说话人转换检测(Speaker Change Detection, SCD)旨在识别对话中不同说话人之间的边界,并常被视为说话人日志(Speaker Diarization, SD)的子任务,具有广泛的应用。最近,微调 wav2vec 2.0 模型在 SCD 任务中达到了最先进的水平,但对其他经典的自监督学习(SSL)模型的探索仍然有限,并且直接对SSL模型进行微调需要一定量的数据和计算资源。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)论文“SCDNet: Self-supervised Learning Feature based Speaker Change Detection”被语音研究顶级会议INTERSPEECH2024接收。该论文研究了SCD任务中的自监督学习 (SSL) 表征的应用。具体来说,该论文提出了一个名为 SCDNet 的模型,并基于该模型研究了各种主流SSL 模型,包括 Hubert、wav2vec 2.0 和 WavLm。同时,该论文还引入了一种基于微调的方法来进一步比较 SSL 模型在 SCD 任务中的特性。此外,该论文还提出了一种对比学习方法来减轻基于微调的方法和 SCDNet 在训练中的过度拟合趋势。实验展示了 WavLm 在 SCD 任务中的优势,也证明了 SCDNet 的良好设计。现对该论文进行简要的解读和分享。
论文题目:SCDNet: Self-supervised Learning Feature based Speaker Change Detection作者列表:李越,王新升,张丽,谢磊
论文原文:https://arxiv.org/pdf/2406.08393
相关链接:NPU-ASLP实验室14篇论文被Interspeech2024 录用
说话人日志(SD)是语音处理中的一种关键方法,旨在回答涉及多个说话人的场景中“谁在何时说话”的问题[1]。相比之下,说话人转换检测(SCD)是寻找对话中的说话人转折点[2],因此它可以被视为SD的子任务[3],并且也具有广泛的应用,例如增强自动语音识别(ASR)准确性和切分字幕。
基于度量的方法是 SCD 任务的常见早期方法,其中通过比较两个连续语音窗口之间的分布来识别说话者变化点。随着 i-vector 和基于 DNN 的嵌入的出现,统一分割方案作为有效方法而受到欢迎。在这种方法中,目标音频被分割成一系列具有恒定窗口长度和重叠长度的片段。随后,比较各个片段的语音嵌入以确定说话者是否发生了变化。然而,由于窗口长度固定,语音嵌入的有效性和边界检测的准确性之间不可避免地需要进行权衡。
为了克服基于分段的方法的局限性,各种工作都致力于通过神经网络来预测帧级别的说话人变化点[1,4]。在这些方法中,模型通常使用真实的 SCD 标签进行训练,优化目标是最小化预测概率信号和线性模糊标记信号之间的距离。
除了用于帧级 SCD 的基于标签的方法之外,一些工作还探索了通过 ASR 技术利用文本转录进行单词级说话人转换检测。通过合并旨在表示说话者轮流的独特标记来增强用于训练 ASR 模型的转录。然后,使用增强转录来训练 ASR 模型,该模型不仅可以预测常规文本标记,还可以预测特殊的说话者轮流标记。虽然这种方法减轻了边界注释的必要性,但使用文本转录可能会更加复杂,特别是在以频繁中断和插入以及语调标记盛行为特征的对话场景中。另外,由于该方法中的预测边界是在字级上操作的,因此边界预测的精度可能不如基于帧级预测的边界预测那么高。
最近,研究者探索了最流行的 SSL 模型之一 wav2vec 2.0 [5] 在 SCD 任务上的有效性。在研究中,预训练的 wav2vec 2.0 以涉及多任务的端到端方式进行微调,即 SCD、重叠语音检测 (OSD) 和语音活动检测 (VAD)。这种 wav2vec 2.0 和基于多任务的方法展示了卓越的性能,在 SCD 任务中达到了最先进的 (SOTA) 水平。受这项研究的启发,我们正在对基于 SSL 的 SCD 端到端训练方法进行进一步研究。
一方面,由于SSL模型中的参数通常较多,直接对其进行微调需要一定的数据和计算资源阈值。另一方面,尽管可以通过多任务处理(例如 OSD 和 VAD)来增强 SCD 性能,但所有这些任务都是帧级二元分类任务,在训练时存在过度拟合的风险由于简单的学习范式而导致复杂的模型。此外,除了 wav2vec 2.0 之外,其他 SSL 模型(例如 Hubert [6] 和 WavLm [7])也在各种下游任务中获得了极大的关注。然而,这些模型在 SCD 中的性能尚未得到探索。
为了解决这些问题,我们提出了一种基于 Conformer 架构的创新的端到端 SCD 模型,称为 SCDNet。SCDNet 利用现成的特征作为输入,并经过端到端的训练来完成 SCD 任务。此外,我们提出了一种对比学习方法来训练面向 SCD 的模型,以解决与帧级二元分类任务相关的过度拟合趋势。此外,我们通过 SCDNet 和基于微调的方法探索各种 SSL 功能的性能。
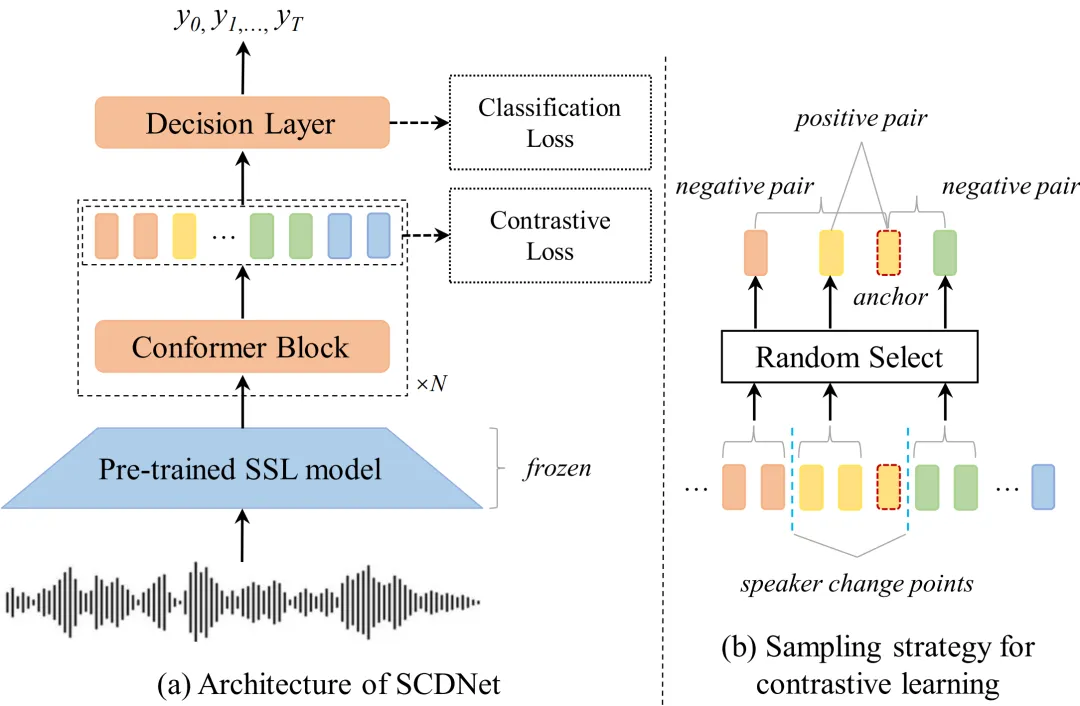
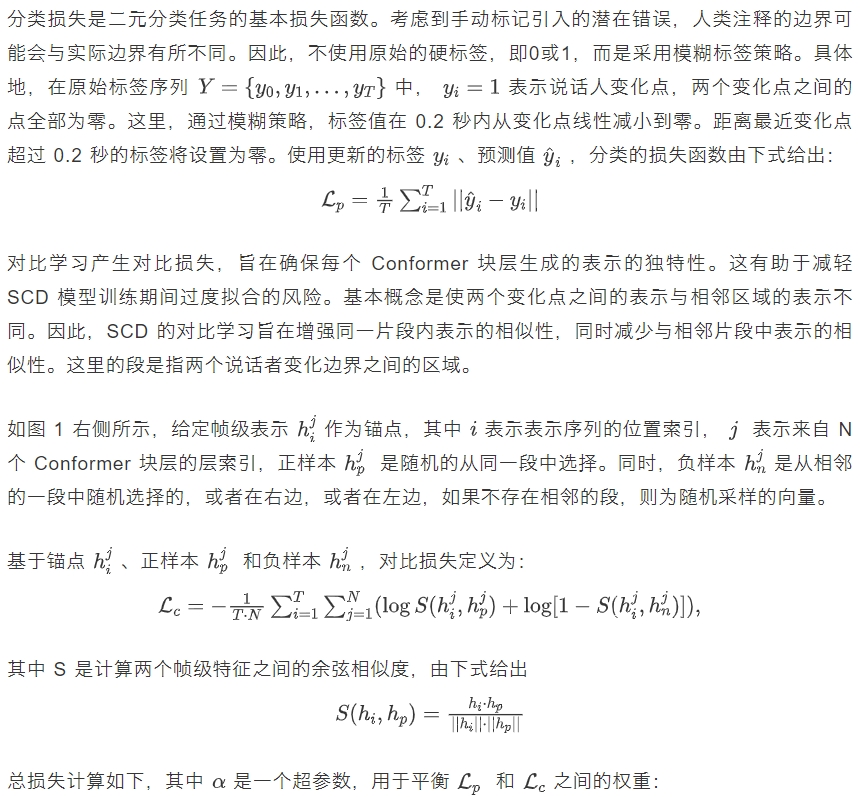
SCDNet 是一个基于 Conformer 的模型,以语音表示作为输入实现帧级二元分类。除了分类损失之外,还提出了对比损失来缓解简单的二元学习方式造成的过拟合倾向。这种对比损失还用于微调 SCD 任务的预训练 SSL 模型。
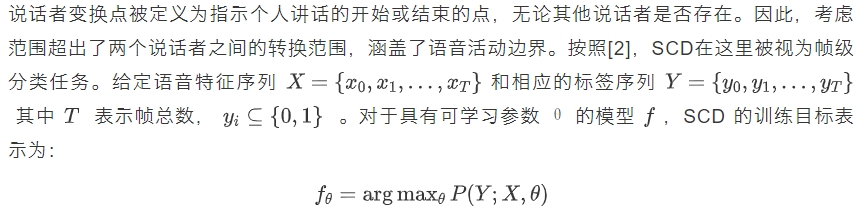
问题表述
网络结构
如图 1 所示,所提出的 SCDNet 主要包含三个组件:预训练的 SSL 模型、Conformer 块和决策层。在推理过程中,输入音频由从预训练 SSL 模型中提取的特征表示。随后,这些特征通过 N 层 Conformer Blocks,然后通过决策层生成最终边界标签。作为帧级二元分类任务,分类损失(例如交叉熵损失或基于距离的损失)是 SCD 相关模型训练的典型损失函数。然而,由于二进制标签提供的信息有限,仅依靠分类损失进行训练可能具有挑战性,很容易出现过度拟合。为了应对这一挑战,提出了一种对比学习方法来训练与分类损失相关的 SCDNet。图1 SCDNet 的架构(左)和对比学习的采样策略(右)
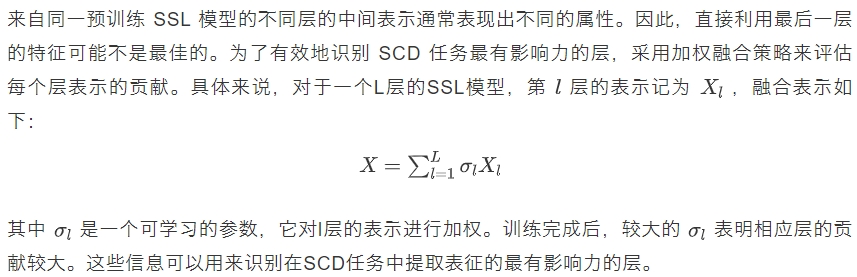
自监督表征的使用
微调自监督模型
除了现成的基于表征的SCDNet之外,我们还通过微调来评估各种SSL模型在SCD任务中的表现。在微调过程中只更新来自变压器层和决策层的参数,并使用我们所提出的损失函数。这种微调方法具有双重目的:它比较了在SCD任务中微调不同SSL模型的性能,并能够直接比较[2]中基于多任务的损失和所提出的损失函数。
数据集和实验配置
实验采用四个真实数据集,包括 AMI [7]、AliMeeting [8]、AISHELL-4 [9] 和 DIHARD3 [10]。对于 AMI 数据集,使用“耳机混合”录音。分别采用AliMeeting的远端通道0和AISHELL-4的通道0。除了上述真实数据集之外,还使用随机混合的模拟过程,从 LibriSpeech [11]的“train-other-500”子集创建了一个人工数据集。考虑到AMI在SCD任务中的广泛使用,在AMI数据集上与其他方法进行比较,同时使用其他数据集进一步验证SCDNet的鲁棒性并证明对比学习方法的有效性。按照[2],采用纯度(Pur)和覆盖率(Cov)分数作为SCD任务的评估指标,F1表示这两者的调和平均值。Python 库 pyannote.metrics 用于计算相应的指标。
SCDNet 包含一个 3 层 Conformer 块(N = 3),隐藏维度为 384。方程中的参数 α。5设置为0.05。在推理过程中,采用0.35的阈值对模型生成的说话人变化点的预测概率进行二值化。
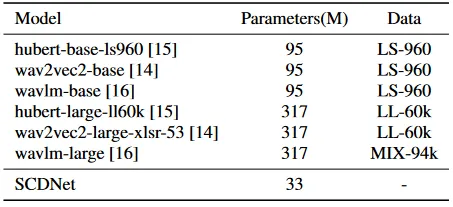
考虑了最近流行的各种SSL模型,包括wav2vec 2.0、Hubert、WavLm及其不同的尺度,如表1所示。采用基于SCDNet和基于微调的方法来探索这些模型的有效性SCD 任务中的模型。SSL表征分析
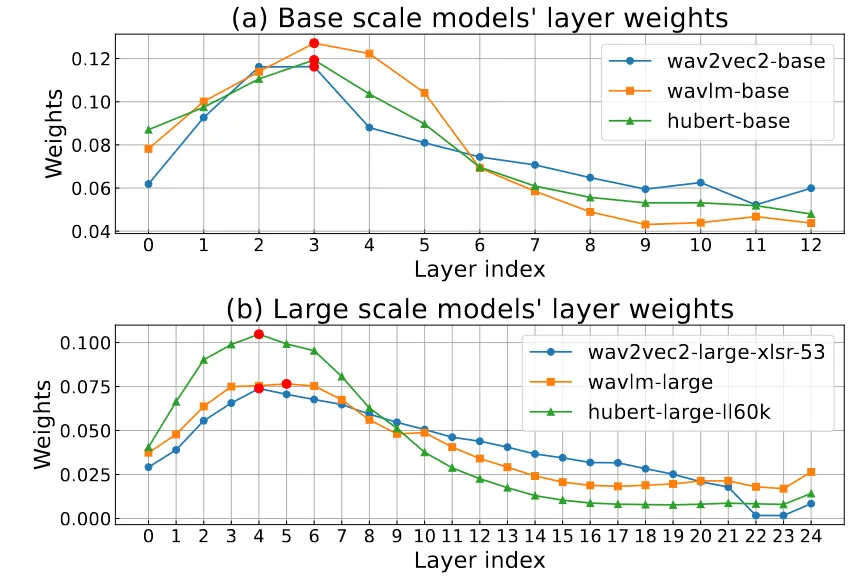
基于 SCDNet 的 SSL 探索从加权融合策略开始,以检查给定 SSL 模型的哪一层表示对 SCD 任务影响最大。图 2 说明了可学习的权重值对应于 SSL 模型的不同转换器层 (l)。层的值越高表示在 SCD 任务的上下文中,该特定层的表示对最终表示的贡献越大。
如图 2 所示,不同模型的权重值,无论是基础模型还是大型模型,都表现出相似的趋势。具体来说,这些值从初始层到某一层逐渐增大,然后逐渐减小。这种趋势表明初始层包含更多的声学信息,而更深的层包含更多的语义信息。在SCD任务中,声学特征和语义信息都很有价值。中间层在声学和语义信息之间取得了平衡,比两端的表示表现出更重要的贡献。图2 加权表示融合方法中不同层的权重值
表2总结了具有最高权重值的层和最后一层的表示的性能。很明显,对于每个模型,具有最高权重值的中间表示优于最后一层所实现的性能。这强调了加权融合方法在识别影响层方面的有效性,而不是直接利用最后一层。比较所有结果,虽然 Wavlmbase 第 3 层的表示不如 wav2vec 2.0-large 第 4 层达到的最佳值,但其较小的模型规模和不太明显的性能劣势使其更适合 SCDNet。表2 AMI 数据集上基于各种 SSL 表征的 SCDNet 性能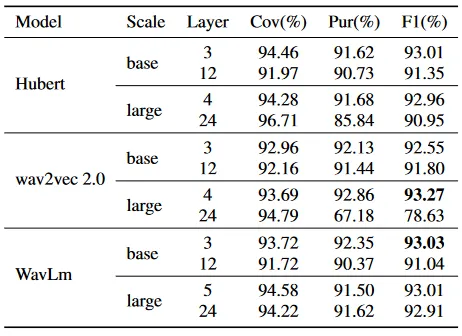
SCD 的基于微调的 SSL 比较如表 3 所示。可以看出,与具有相似规模的其他 SSL 模型相比,基于 WavLm 的方法在大尺度和基础尺度上都实现了最佳性能,这表明 WavLm特别适合 SCD 任务。表3 AMI 数据集上基于微调各种 SSL 模型的 SCD 性能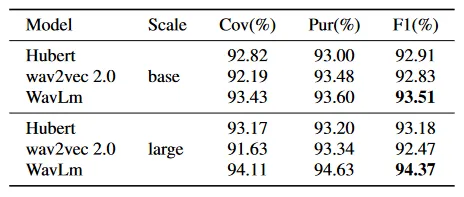
与 SOTA 方法的比较
表4列出了所提出的SCDNet与之前方法的比较。在该表中,SCDNet是指以WavLm-base第3层的表示作为输入的所提出的模型,除非另有特别说明,否则它将成为默认设置。很明显,SCDNet 实现了最好的性能,与[2]之前实现的 SOTA 性能相比,F1 相对增益为 2.5%。这一结果凸显了SCDNet设计的有效性。表4 所提出的方案与之前报告的 AMI 数据集上的 SCD 任务结果的比较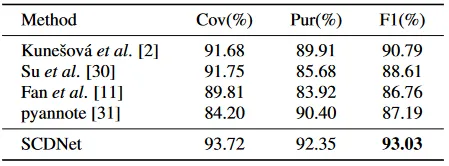
值得注意的是,[2]中之前的 SOTA 性能基于对 wav2vec2-base 模型的微调,与表 3 中所示的模型相同。然而,我们的结果是通过与提出的对比微调 wav2vec-base 来实现的学习方法明显优于[2]中的方法。这种优越性强调了所提出的对比学习方法的有效性。这种优越性的进一步证据将在以下消融研究中探讨。
对比学习损失分析
为了证明所提出的对比学习方法的有效性,在更多的数据集上进行了消融实验,相应的结果如表5所示。未经对比学习训练的模型获得的所有F1值均低于在相同数据集上进行对比学习的模型数据库。具体而言,在 AI-SHELL-4 数据库上,采用对比学习时与不采用对比学习时相比,观察到的值高出 3.4%。这些结果共同证明了所提出的对比学习在增强 SCDNet 性能方面的有效性。表5 SCDNet 带/不带对比学习 (CL) 的结果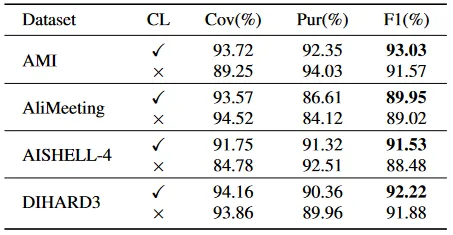
泛化性分析
为了进一步评估SCDNet的泛化能力并为未来的工作提供额外的参考,我们基于人工数据训练SCDNet并在不同的数据集上评估模型。结果如表6所示。如表6所示,在4个测试集中,与直接在相应领域中训练的模型相比,使用人工数据训练的SCDNet的性能下降在10%以内。这表明当仅使用人工数据进行训练时,所提出的 SCDNet 可以推广到数据集外的领域。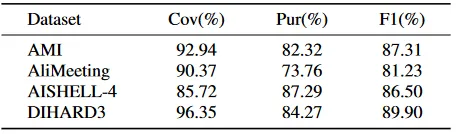
[1] M. Hrúz and Z. Zajíc, “Convolutional neural network for speaker change detection in telephone speaker diarization system,” in International Conference on Acoustics, Speech and Signal Processing. IEEE, 2017, pp. 4945–4949.[2] M. Kunešová and Z. Zajíc, “Multitask detection of speaker changes, overlapping speech and voice activity using wav2vec 2.0,” in International Conference on Acoustics, Speech and Signal Processing. IEEE, 2023, pp. 1–5.[3] R. Yin, H. Bredin, and C. Barras, “Neural speech turn segmentation and affinity propagation for speaker diarization,” in INTERSPEECH. ISCA, 2018, pp. 1393–1397.[4] Z. Fan, L. Dong, M. Cai, Z. Ma, and B. Xu, “Sequencelevel speaker change detection with difference-based continuous integrate-and-fire,” Signal Processing Letters, vol. 29, pp. 15511554, 2022.[5] A. Baevski, Y. Zhou, A. Mohamed, and M. Auli, “wav2vec 2.0: A framework for self-supervised learning of speech representations,” Advances in neural information processing systems, vol. 33, pp. 12 449–12 460, 2020.[6] W.-N. Hsu, B. Bolte, Y.-H. H. Tsai, K. Lakhotia, R. Salakhutdinov, and A. Mohamed, “Hubert: Self-supervised speech representation learning by masked prediction of hidden units,” Transactions on Audio, Speech, and Language Processing, vol. 29, pp. 3451–3460, 2021.[7] S. Chen, C. Wang, Z. Chen, Y. Wu, S. Liu, Z. Chen, J. Li, N. Kanda, T. Yoshioka, X. Xiao et al., “Wavlm: Large-scale selfsupervised pre-training for full stack speech processing,” Journal of Selected Topics in Signal Processing, vol. 16, no. 6, pp. 15051518, 2022.[7] W. Kraaij, T. Hain, M. Lincoln, and W. Post, “The ami meeting corpus,” in International Conference on Methods and Techniques in Behavioral Research, 2005, pp. 28–39.[8] F. Yu, S. Zhang, Y. Fu, L. Xie, S. Zheng, Z. Du, W. Huang, P. Guo, Z. Yan, B. Ma et al., “M2met: The icassp 2022 multichannel multi-party meeting transcription challenge,” in International Conference on Acoustics, Speech and Signal Processing. IEEE, 2022, pp. 6167–6171.[9] Y. Fu, L. Cheng, S. Lv, Y. Jv, Y. Kong, Z. Chen, Y. Hu, L. Xie, J. Wu, H. Bu et al., “Aishell-4: An open source dataset for speech enhancement, separation, recognition and speaker diarization in conference scenario,” INTERSPEECH, pp. 3665–3669, 2021.[10] N. Ryant, P. Singh, V. Krishnamohan, R. Varma, K. Church, C. Cieri, J. Du, S. Ganapathy, and M. Liberman, “The third dihard diarization challenge,” INTERSPEECH, pp. 3570–3574, 2021.[11] V. Panayotov, G. Chen, D. Povey, and S. Khudanpur, “Librispeech: an asr corpus based on public domain audio books,” in International Conference on Acoustics, Speech and Signal Processing. IEEE, 2015, pp. 5206–5210.[12] H. Su, D. Zhao, L. Dang, M. Li, X. Wu, X. Liu, and H. Meng, “A multitask learning framework for speaker change detection with content information from unsupervised speech decomposition,” in International Conference on Acoustics, Speech and Signal Processing. IEEE, 2022, pp. 8087–8091.[13] H. Bredin, R. Yin, J. M. Coria, G. Gelly, P. Korshunov, M. Lavechin, D. Fustes, H. Titeux, W. Bouaziz, and M.-P. Gill, “Pyannote. audio: neural building blocks for speaker diarization,” in International Conference on Acoustics, Speech and Signal Processing. IEEE, 2020, pp. 7124–7128.
 西工大音频语音与语言处理研究组