近年来基于深度学习的语音前端处理及语音识别已经获得了长足的发展,然而对于包括噪声、说话人重叠、混响等多种影响因素在内的真实复杂声学场景,未经处理的语音的人耳主观听感与语音识别准确率都会明显下降。长期以来,基于多通道信号处理的前端语音增强是提升远场语音拾取质量的常用方法。相比于单通道方案,多通道方案可以通过对不同麦克风之间观测到的信号时延的计算来估计出空间信息,在该空间特征的帮助下,模型能够更好地提升语音增强的效果。西工大音频语音与语言处理研究组(ASLP@NPU)近年来致力于基于深度学习的语音增强方向的研究工作。此前已针对单通道语音增强任务,推出了DCCRN[1]、DCCRN+[2],S-DCCRN[3],针对单通道语音增强去混任务,提出了UFormer[4],针对多通道语音增强、分离及去混问题推出了DESNet[5]等模型。近期,实验室和腾讯天籁实验室针对多通道语音增强任务提出了Spatial-DCCRN模型,相关论文"SPATIAL-DCCRN: DCCRN EQUIPPED WITH FRAME-LEVEL ANGLE FEATURE AND HYBRID FILTERING FOR MULTI-CHANNEL SPEECH ENHANCEMENT "被语音研究旗舰会议IEEE SLT2022接收。Spatial-DCCRN是基于S-DCCRN[3]的进一步改进,通过角度特征提取模块以及混合滤波器的帮助下,Spatial-DCCRN在3D语音增强L3DAS22 challenge数据集[6]上指标超越了频域模型DCCRN、EabNet[7]、时域模型FasNet[8],在多通道实录会议数据集ConferencingSpeech2021[9]上客观指标超过了竞赛第一名MIMO-UNet[10],现对该论文进行简要的解读和分享。
论文题目:SPATIAL-DCCRN: DCCRN EQUIPPED WITH FRAME-LEVEL ANGLE FEATURE AND HYBRID FILTERING FOR MULTI-CHANNEL SPEECH ENHANCEMENT作者列表:吕术博、付艺辉、琚雨恺、谢磊、朱唯鑫、饶为、王燕南论文原文:https://arxiv.org/abs/2210.08802样例:https://imybo.github.io/Spatial-DCCRN/
图1 发表论文截图
图2 扫码直接看论文
语音增强(Speech Enhancement,SE)是一项从嘈杂语音中消除噪声,提高语音质量和可懂度的任务,是语音信号处理领域中的重要研究方向。最近,随着深度学习在语音应用上的飞速进展,语音增强被定义为一种数据驱动的监督学习问题。与此同时,基于深度学习的多通道语音增强也受到了越来越多的关注。近期,诸如L3DAS22[6]和ConferencingSpeech2021[9]等国际上举办的语音增强竞赛也关注到多通道相关研究。然而,当前大多数基于神经网络的多通道模型对于空间特征没有更为有效地利用,并且采用filter-and-sum的滤波方式存在一定程度上的理论上限。
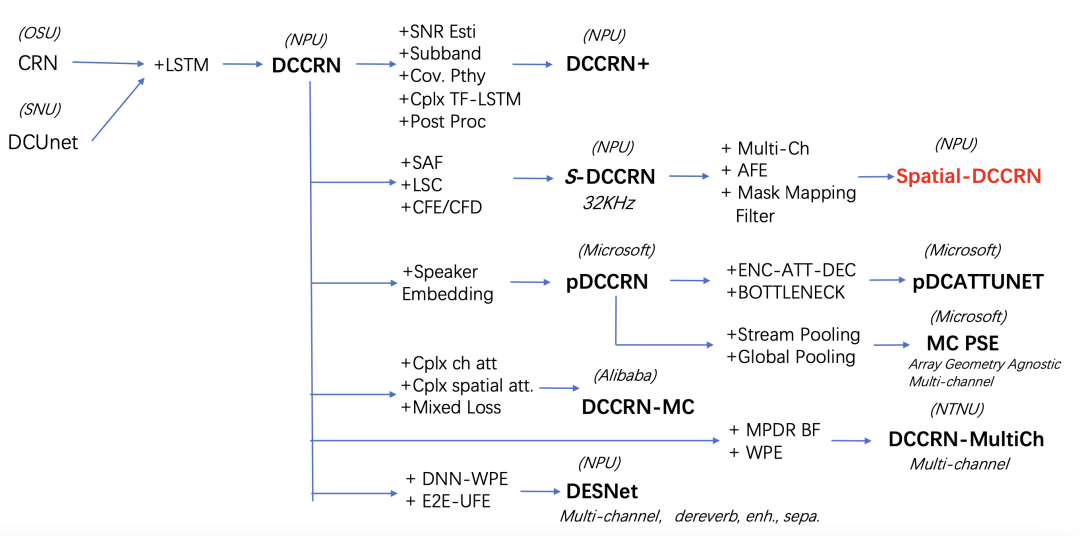
图3 DCCRN及其衍生模型
针对以上的挑战,我们基于此前的S-DCCRN[3]模型结构,设计了Spatial-DCCRN,主要贡献如下:- 将S-DCCRN扩展到多通道,利用S-DCCRN分频带建模的思路,进行级联的局部/全局通道建模,更精细化的处理空间信息。
- 设计了一个角度特征提取模块,只将CosIPDs作为该模块的输入,旨在提取帧级角度特征,送入Sub/Full Channel DCCRN的LSTM辅助训练。
- 设计了一个mask和mapping结合的滤波方案,替代传统的filter-and-sum操作,同时进行降噪和去混响。
如图4所示,输入语音首先通过短时傅里叶变换转换到频域,之后频谱特征通过可学习谱压缩模块(Learnable Spectrum Compression)对能量进行调整,然后再通过一组复数特征编码器(Complex Feature Encoder)提取频带中的有效信息,而后送入子通道DCCRN和全通道DCCRN,与此同时,cosIPD特征送入角度特征提取模块(Angle Feature Extraction module)提取帧级别角度特征,然后送入Sub / Full -channel DCCRN中。其中Sub / Full - channel DCCRN估计的是mapping滤波器的参数,将该结果和原始带噪信号拼到一起送入MMF (Masking and Mapping Filtering)模块估计masking滤波器的参数,从而进行滤波。最后将滤波结果通过复数特征解码器(Complex Feature Decoder)还原回频域,最后通过逆傅里叶变换重构出语音。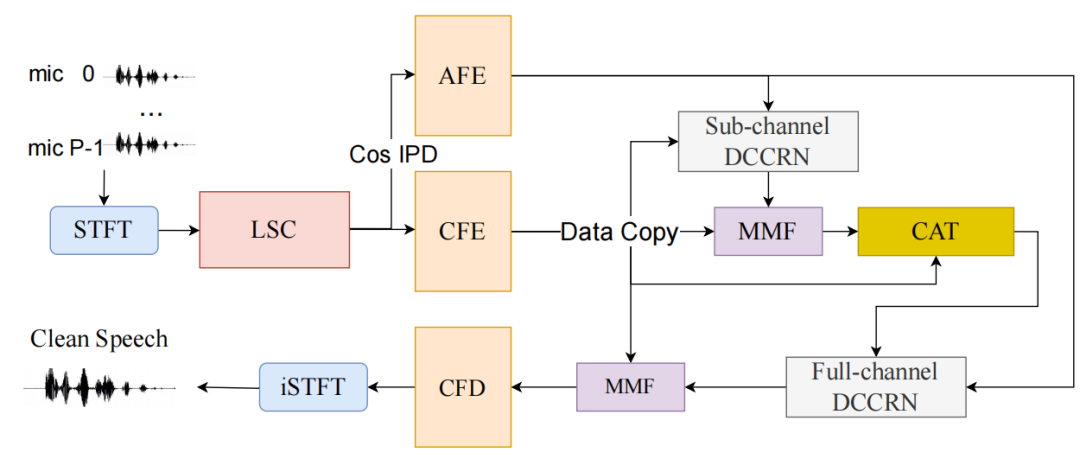
图4 Spatial-DCCRN 网络结构
如图5所示,角度特征提取模块和Complex Feature Encoder (CFE) 模块类似。模块整体的输入是CosIPD特征,首先用一个点卷积将信息转入到高维表征。之后用多层带动卷积建模时间序列信息,最后再通过一层卷积提取局部信息。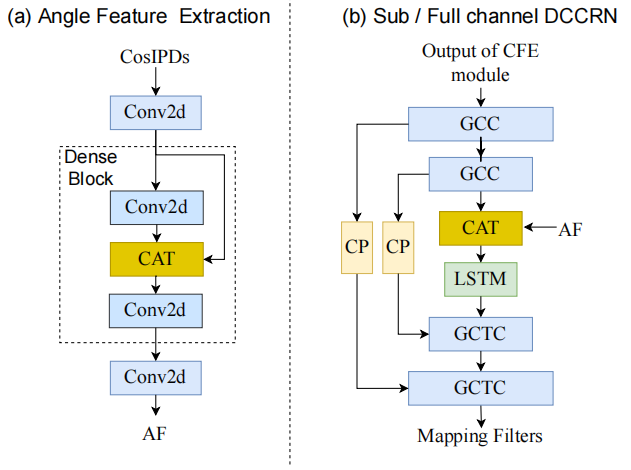
图5 Angle Feature Extraction 网络结构
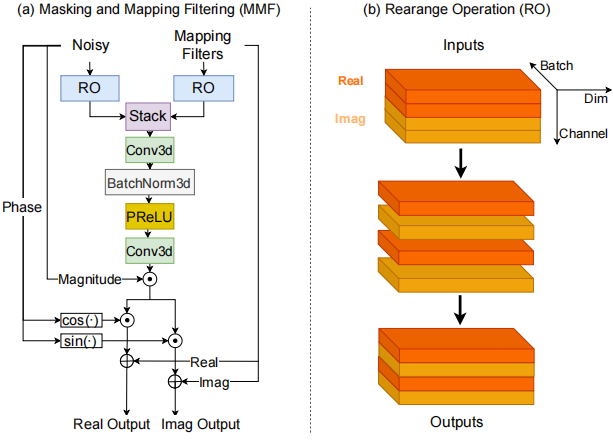
Masking & Mapping Filtering如图6所示,首先将带噪语音和Mapping滤波器进行重排列,按照通道序列实虚部交替,之后将两者堆叠到一个独立的维度上。整体结构采用的3D卷积,一方面,3D卷积可以更好地提取带噪信号和Mapping滤波器间的信息,另一方面,通过将步数设置为2,3D卷积提取两者间信息时可以保证通道间的独立性,防止空间信息被破坏。网络提取完Masking滤波器后,将其作用到带噪语音上,再加上主体网络估计的Mapping滤波器,即可得到最终的降噪结果。图6 Masking and Mapping Filtering 网络结构
损失函数主要由以下三个部分构成,其中STOI Loss[11]和PHASEN Loss[12]用于衡量增强后的语音和干净语音在复频域的相似性,SISNR Loss[13]用于衡量时域的相似性。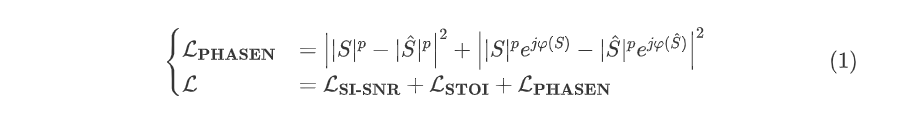
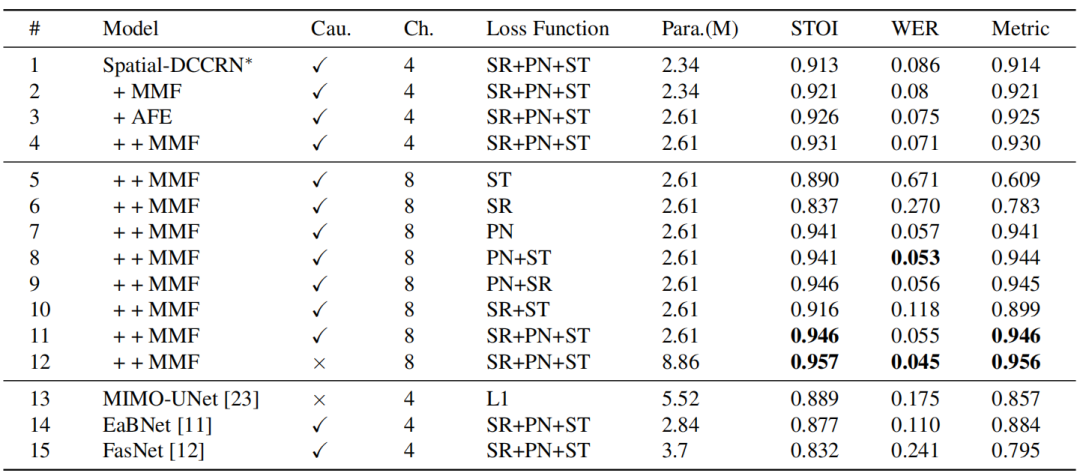
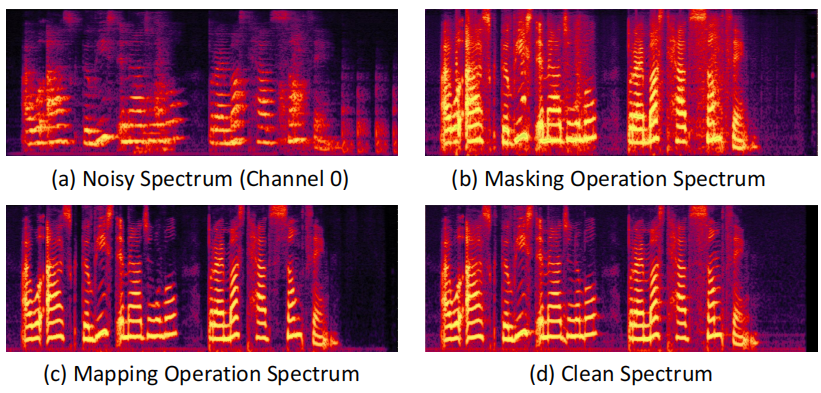
我们首先在L3DAS22 challenge dataset数据集[6]上进行消融实验,该数据集的训练集和校验集是固定的,分别是81小时和4小时。之后在 ConferencingSpeech 2021竞赛数据集[9]上进一步验证,训练数据包含550小时的干净语音和120小时的噪声数据。在ConferencingSpeech 2021竞赛数据集上,训练数据均为动态随机混合生成,信噪比为-5至25dB,测试集是采用ConferencingSpeech 2021竞赛官方盲测集。首先在L3DAS22 challenge的测试集上测试各个模型解码结果的STOI和WER指标。从表1中可以看到,加入MMF和AFE模块后模型性能得到明显的提升,并且从Loss函数来看,单独STOI Loss性能较差,但和其他Loss辅助在一起性能可以有所提升。单独PHASEN Loss要优于单独SISNR Loss,从频域上优化,模型失真相对少一些。将时频域联合优化后,指标达到最高。表1 L3DAS22 challenge测试集消融实验结果如图7所示,我们可视化了单独Masking滤波器的结果,可以看到,在没有显式指导Masking滤波器去混的情况下,模型依旧学到了去混的功能,证明了我们模块设计和思路的有效性。图7 Masking and Mapping Filtering 降噪结果
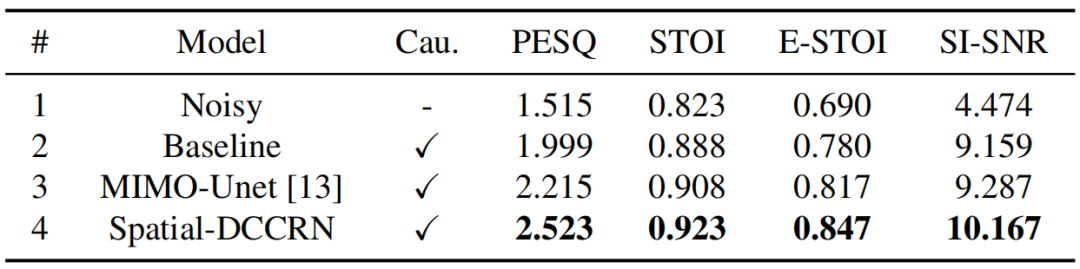
最后,我们在 ConferencingSpeech2021 Challenge 盲测集上测试了模型的PESQ、STOI、E-STOI、SI-SNR指标。从表2可以看到,Spatial-DCCRN在客观指标上超越了竞赛TOP-1的模型MIMO-UNet[10]。表2 ConferencingSpeech2021 测试集结果
第一组(L3DAS22 Challenge)
带噪语音:
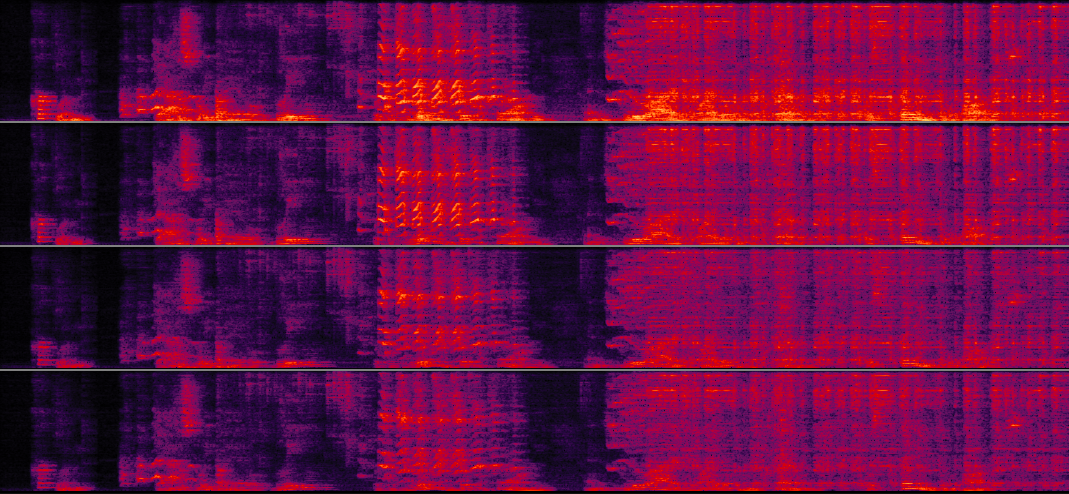
Spatial-DCCRN:
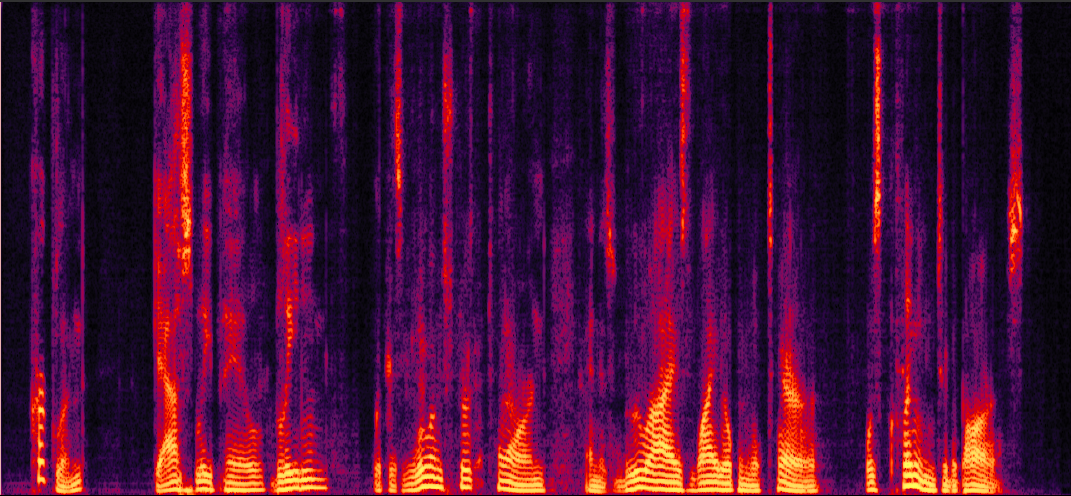
干净语音:
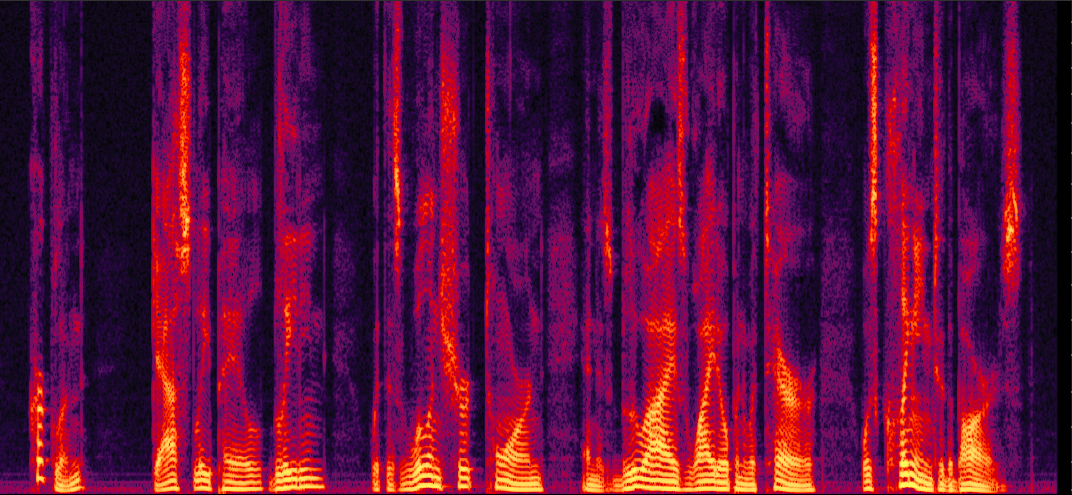
第二组(ConferencingSpeech2021 Challenge)
带噪语音:
ConferencingSpeech_Noisy音频
Spatial-DCCRN:
ConferencingSpeech_Spatial_DCCRN音频
MIMO-UNet:
ConferencingSpeech_Mimo_Unet音频
更多样例敬请访问:
https://imybo.github.io/Spatial-DCCRN/
[1] Yanxin Hu, Yun Liu, Shubo Lv, Mengtao Xing, Shimin Zhang, Yihui Fu, Jian Wu, Bihong Zhang, and Lei Xie, "DCCRN:Deep complex convolution recurrent network for phase-awarespeech enhancement," Interspeech, pp. 2472–2476, 2020.[2] Shubo Lv, Yanxin Hu, Shimin Zhang, and Lei Xie, "DCCRN+:Channel-wise subband dccrn with snr estimation for speech enhancement," Interspeech2021.[3] Shubo Lv, Yihui Fu, Mengtao Xing, Jiayao Sun, Lei Xie, Jun Hunag, Yannan Wang, Tao Yu, "S-DCCRN: Super Wide Band DCCRN with learnable complex feature for speech enhancement," ICASSP2022[4] Yihui Fu, Yun Liu, Jingdong Li,Dawei Luo, Shubo Lv, Yukai Jv and Lei Xie, "Uformer: A Unet Based Dilated Complex & Real Dual-path Conformer Network for Simutaneous Speech Enhancement and Dereverberation," ICASSP2022[5] Yihui Fu, Jian Wu, Yanxin Hu, and Lei Xie. "DESNet: A Multi-Channel Network for Simultaneous Speech Dereverberation, Enhancement and Separation," 2021 IEEE Spoken Language Technology Workshop (SLT). IEEE, 2021: 857-864.[6] Eric Guizzo, Christian Marinoni, Marco Pennese, Xinlei Ren, Xiguang Zheng, Chen Zhang, Bruno Masiero, Aurelio Uncini, and Danilo Comminiello. "L3das22 challenge: Learning 3d audio sources in a real office environment," ICASSP2022[7] Andong Li, Wenzhe Liu, Chengshi Zheng, and Xiaodong Li. "Embedding and beamforming: All-neural causal beamformer for multichannel speech enhancement," ICASSP2022[8] Yi Luo, Cong Han, Nima Mesgarani, Enea Ceolini, and Shih-Chii Li. "Fasnet: Low-latency adaptive beamforming for multi-microphone audio processing," ASRU2019[9] Wei Rao, Yihui Fu, Yanxin Hu, Xin Xu, Yvkai Jv, Jiangyu Han, Zhongjie Jiang, Lei Xie, Yannan Wang, Shinji Watanabe, Zheng-Hua Tan, Hui Bu, Tao Yu, Shidong Shang. "Interspeech 2021 conferencingspeech challenge: Towards far-field multi-channel speech enhancement for video conferencing," Interspeech2021[10] Xinlei Ren, Xu Zhang, Lianwu Chen, Xiguang Zheng, Chen Zhang, Liang Guo, and Bing Yu. "A causal u-net based neural beamforming network for real-time multichannel speech enhancement," Interspeech2021[11] Cees H Taal, Richard C Hendriks, Richard Heusdens, and Jesper Jensen. "A short-time objective intelligibility measure for time-frequency weighted noisy speech," ICASSP2010[12] Dacheng Yin, Chong Luo, Zhiwei Xiong, and Wenjun Zeng. "Phasen: A phase-and-harmonics-aware speech enhancement network," AAAI2020[13] Yi Luo and Nima Mesgarani. "Conv-tasnet: Surpassing ideal time–frequency magnitude masking for speech separation," TASLP2019 
 西工大音频语音与语言处理研究组