
 西工大音频语音与语言处理研究组
文章来源于音频语音与语言处理研究组,作者宋堃
论文题目:AdaVITS: Tiny VITS for Low Computing Resource Speaker Adaptation
作者列表:宋堃,薛鹤洋,王新升,从坚,张雍茂,谢磊,杨兵,张雄,苏丹
论文原文:https://arxiv.org/abs/2206.00208
1. 背景动机 说话人自适应(speaker adapation)技术重要的应用场景是针对普通说话人的小样本音色克隆任务。由于针对大量目标说话人,因此需要考虑自适应模型的计算、存储和训练时间成本。当前有很多工作集中在优化模型的说话人存储成本 [1]和训练时间成本 [2]上,而对于模型的计算成本没有重点关注。可行的方法有量化蒸馏和神经架构搜索,但前者有明显的效果损失,而后者的搜索过程本身需要消耗更多的计算和时间成本。因此,我们从对模型的先验知识角度出发,减少其中不必要的计算和参数量,实现减少计算成本的同时尽可能保证合成效果。但减少计算和参数量本身是一个挑战性任务,这是因为:(1)当前主流的说话人自适应框架包括声学模型与声码器两部分,两部分在推理时可能存在误差,而这种误差在小型化结构的普通说话人自适应场景会更明显,导致瑕疵明显增多。(2)声学模型中语言学特征与声学特征存在耦合,模型小型化导致的建模能力下降会加重这一现象,不利于说话人自适应任务。 针对以上问题,我们引入基于VITS [3]的说话人自适应框架以解决声学模型和声码器的误差问题,并使用音素后验图特征 (PPG) 作为中间语言学表征约束文本到隐变量z的建模过程。因为PPG由大量说话人数据训练的语音识别声学模型提取,与说话人无关,因此可以实现语言学特征与声学特征的解耦。在此框架基础上,我们针对其中部分结构进行了优化,其中包括在解码器中结合逆傅立叶变换 (iSTFT)、正则化流层 (flow) 中引入共享层嵌入 (embedding)、线性注意力机制等方面。
使用PPG:没有语言学特征和声学特征的耦合,可以更直接的将内容和语言信息分别建模,更有利于小型化。同时可以实现克隆结果的风格可控,不会受到普通说话人录音语速和错读的影响。另外,PPG作为帧级语言学表征,可以显著解决VITS模型在多说话人上的发音不稳定问题。 使用VITS:VITS作为当前主流的端到端TTS框架,实现声学模型和解码器部分统一建模,避免两段式框架中声学模型与声码器共用基于梅尔谱中间表征引入的误差问题。
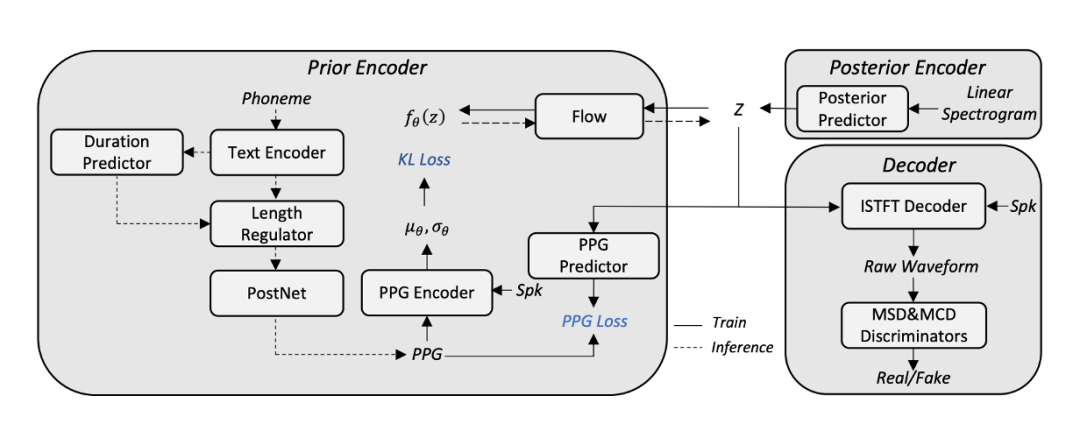
图1 AdaVITS模型架构
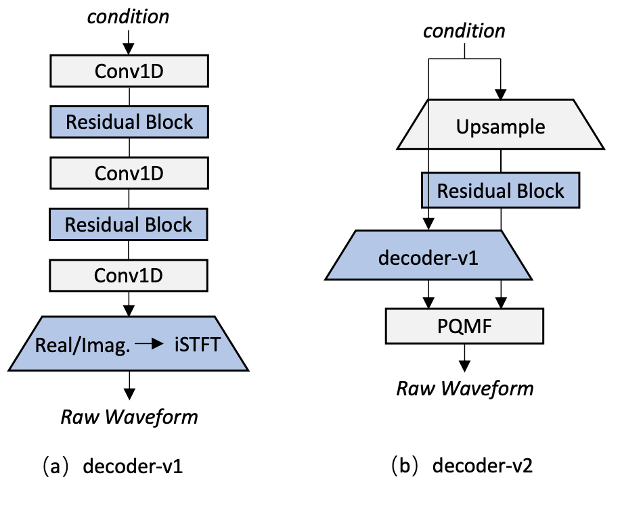
图2 两种Decoder架构
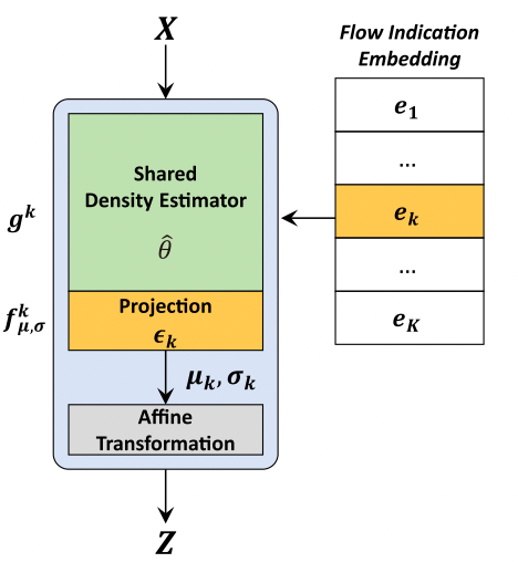
图3 flow indication embedding架构 [5]
另外由于原始FFT Block中,点积注意力机制的计算复杂度并不与输入文本长度线性相关,在长句上有非常明显的计算损耗增加,因此我们替换其为线性注意力机制 [6],使其计算复杂度与输入长度线性相关。
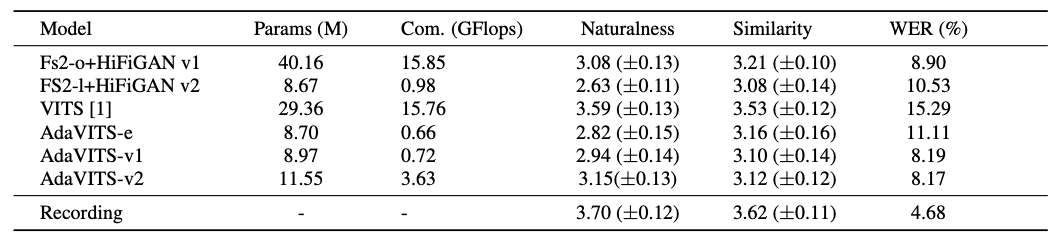
VITS:原始论文版本的VITS
AdaVITSv1:使用decoder-v1的本文方案
AdaVITSv2:使用decoder-v2的本文方案
FS2-o+HiFiGAN v1:使用FastSpeech2和HiFi-GAN v1
FS2-l+HiFiGAN v2:使用小结构FastSpeech2和HiFi-GAN v2
AdaVITS-e:不使用PPG作为中间表征的AdaVITS版本
分别测试了各系统的自然度和音色相似度的MOS评分、WER,并计算了各系统的参数量和计算量。实验结果如表1所示。和具有与AdaVITSv1相似的模型大小的FS2-l+HiFiGAN v2相比,所提出的AdaVITS实现了更好的自然度和更少的计算复杂度。AdaVITS合成样本的WER比FS2-l+HiFiGAN v2更低,表明AdvaVITS具有良好的发音稳定性。与FS2-o+HiFiGAN v1相比,AdaVITS-v2具有相似的自然度,但模型尺寸小。我们也看到,与原始VITS相比,AdaVITS在自然度和说话人相似度方面仍有差距,但是计算复杂度方面有明显优势。与此同时,与其他方法相比,AdaVITS实现了更低的WER,这主要归功于基于PPG的语言特征的利用,这可以通过AdaVITS-e的性能来证明,其使用文本取代PPG作为输入的时候WER攀升。
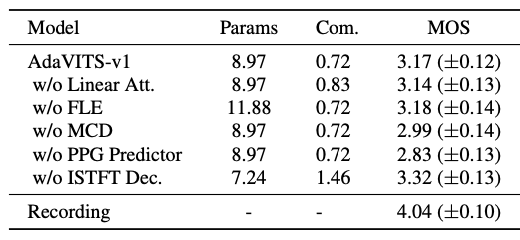
如表2的消融实验所示,复数谱判别器 (MCD) 和PPG预测器 (PPG Predictor) 在获得高质量语音中发挥了重要作用,而加入flow indication embedding (FLE)、线性注意力机制 (Linear Att.) 和iSTFT解码器 (iSTFT Dec.) 可以有效地减少参数数量和计算复杂度,而不会对MOS得分造成明显的影响。
表2 消融实验MOS分
以下是AdaVITS针对5个普通说话人自适应的样例,每个说话人采用手机录制的10句语音进行说话人自适应训练,其中source为原始录音,result为语音合成样例。
