
 西工大音频语音与语言处理研究组
文章来源于音频语音与语言处理研究组,作者雷怡
语音合成(Text-to-Speech,TTS)和歌声合成(Singing Voice Synthesis,SVS)分别是根据文本和音乐乐谱生成高质量的语音和歌声的技术。在深度学习的推动下,语音合成和歌声合成的自然度和音质得到了极大提升。随着TTS和SVS在实际应用中的需求不断增多,诸如能说会唱的虚拟人是当下的热点应用。但当前语音合成和歌唱合成通常是两个系统,且需要单独的标注训练数据。一方面,既有语音又有歌唱的发音人数据很难获得;另一方面,两个单独的系统无形中增加了构建成本。为此,对TTS和SVS进行统一建模,且能够利用不同发音人的语音和歌唱数据构建一个统一的系统,同时实现这些发音人的语音和歌声合成,是一个理想的选择。
论文题目:UniSyn: An End-to-End Unified Model for Text-to-Speech and Singing Voice Synthesis
作者列表:雷怡,阳珊,王新升,谢启聪,姚继珣,谢磊,苏丹
发表会议:AAAI (AAAI Conference on Artificial Intelligence) 2023
论文原文:https://arxiv.org/abs/2212.01546
图1 发表论文截图
图2 扫码直接看论文
基于深度学习的语音合成(TTS)和歌声合成(SVS)的最新进展极大地提高了生成语音和歌声的质量和自然度。随着实际需求的不断增加,在诸如虚拟人的应用场景中,我们需要一个“能说会唱”的音色。一般来说,同时实现TTS和SVS,需要来自同一发音人高质量语音和歌唱标注数据。然而同时获得一个发音人的语音和唱歌数据往往是困难的,比如有的人不擅长唱歌。相较而言,仅有语音或者唱歌录音的发音人数据更容易获得,比如标贝开源的DB1语音合成数据[1],以及网易联合ASLP实验室和多家单位开源的Opencpop歌唱数据[2]。当然,由TTS和歌声转换(Singing Voice Conversion)组成的级联系统可以达到同时生成一个发音人语音和歌声的目的,但这种系统流程复杂,并在推理时依赖于参考音频,不能灵活生成任意内容的音频。
全球首个中文精标歌声合成开源数据Opencpop正式发布
朱鹏程,公众号:语音之家全球首个中文精标歌声合成开源数据Opencpop正式发布
TTS和SVS任务都可以抽象为从输入信息(即文本输入或乐谱)生成人声的过程,因此使用统一的模型来实现语音和歌声合成任务是合理的。在这种统一框架下,利用不同发音人的语音和歌唱数据实现每个发音人的语音和歌唱合成是一个理想的目标。然而TTS和SVS的统一建模实现上述目的面临诸多挑战。首先,作为重要的输入信息,SVS中的乐谱与TTS中的文本输入在形式上存在差异。其次,虽然语音和歌唱声音都是由同一个发音系统产生,但声学形式的产出在音色和韵律方面都有显著差异。而且,发音人的音色和发音风格(即说话和唱歌)是严重耦合在一起的。当每个目标发音人在训练阶段只能使用一种风格(说话或唱歌)数据时,这种耦合往往会导致音色泄漏问题,这意味着合成的目标发音人歌声听起来像是提供歌唱训练数据的发音人,而不是目标发音人,反之亦然。由于这些挑战,之前的研究在构建TTS和SVS统一模型时一般利用从波形中提取的显式特征(例如音调轮廓和节奏)作为输入,为目标发音人生成所需的语音或歌声。在模型推理时,由参考信号提供的显式特征是必不可少的。因此,生成的歌声依赖于参考音频,不能合成任意歌曲,这降低了实际应用中的灵活性。
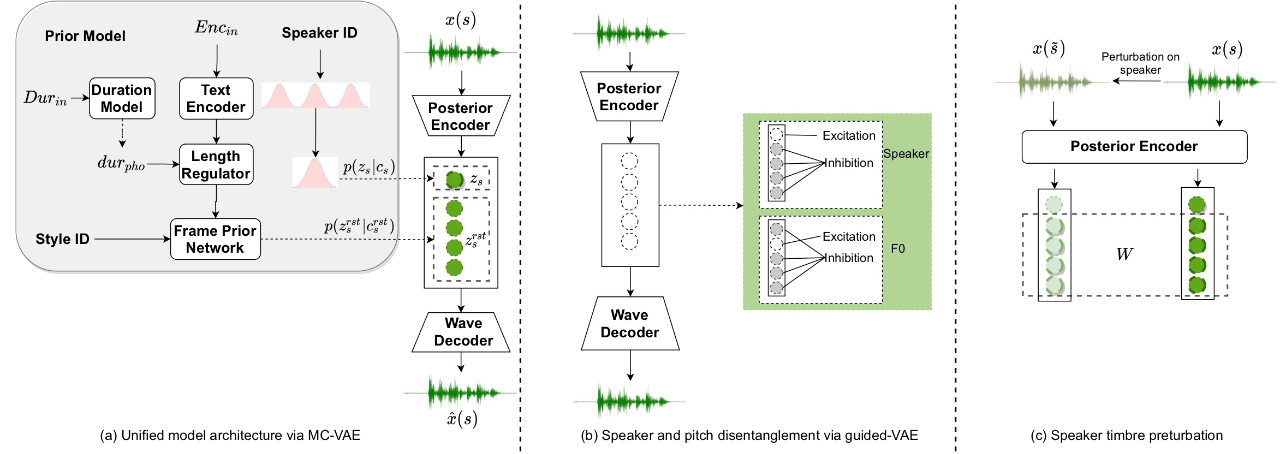
图3 UniSyn结构框架图
2.1 TTS-SVS统一文本输入表示
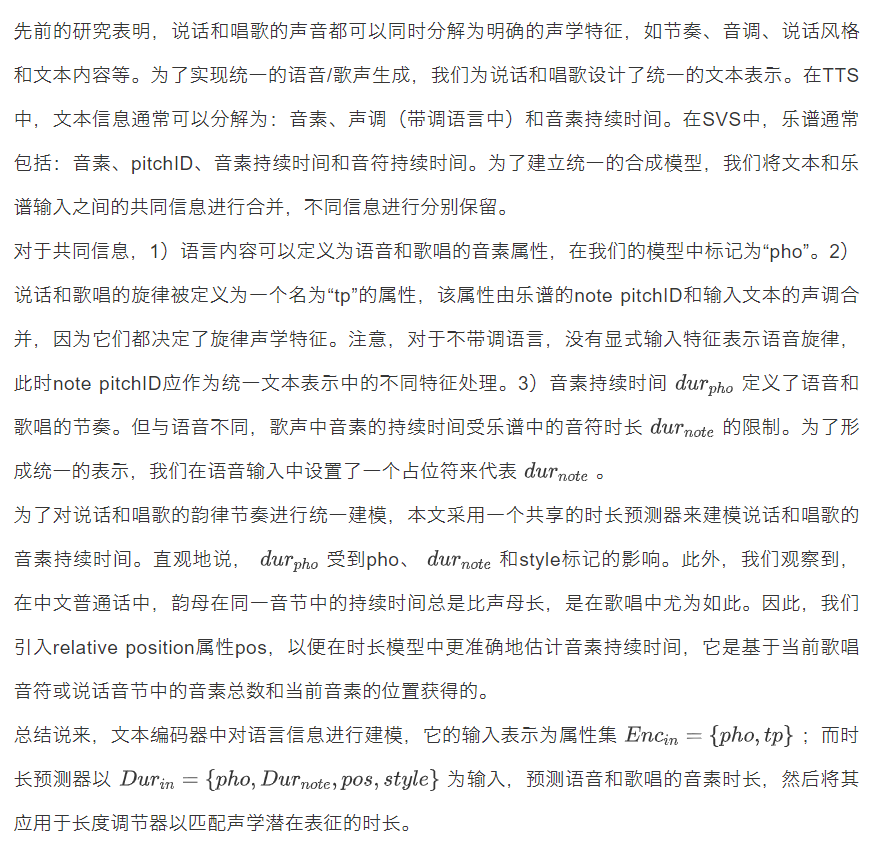
2.2 基于MC-VAE语音生成框架
为了构建一个端到端的生成框架,我们使用VITS[3]中基于CVAE的框架,从潜在变量中合成波形。在本文中,我们将潜在空间分成两个独立子空间,使VAE学习到的潜在变量更具可解释性。理想情况下,我们倾向于将音频信号分解为两个独立的属性,即发音人音色和剩余发音人无关属性。为了实现这一目标,我们提出了多条件变分自动编码器(MC-VAE)。
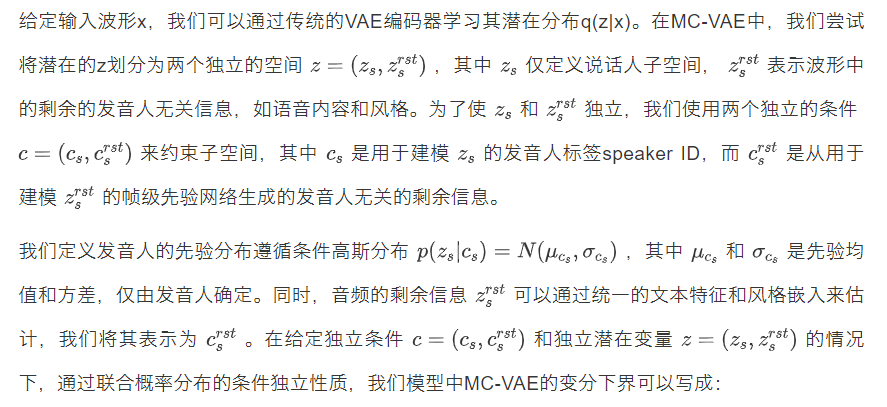
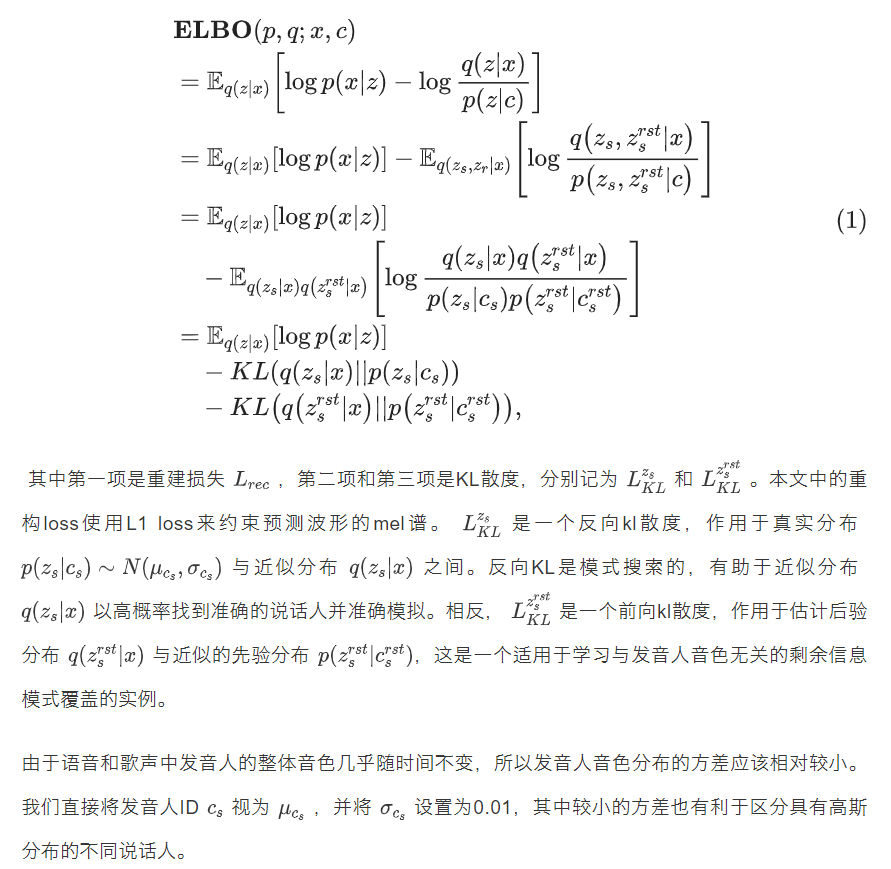
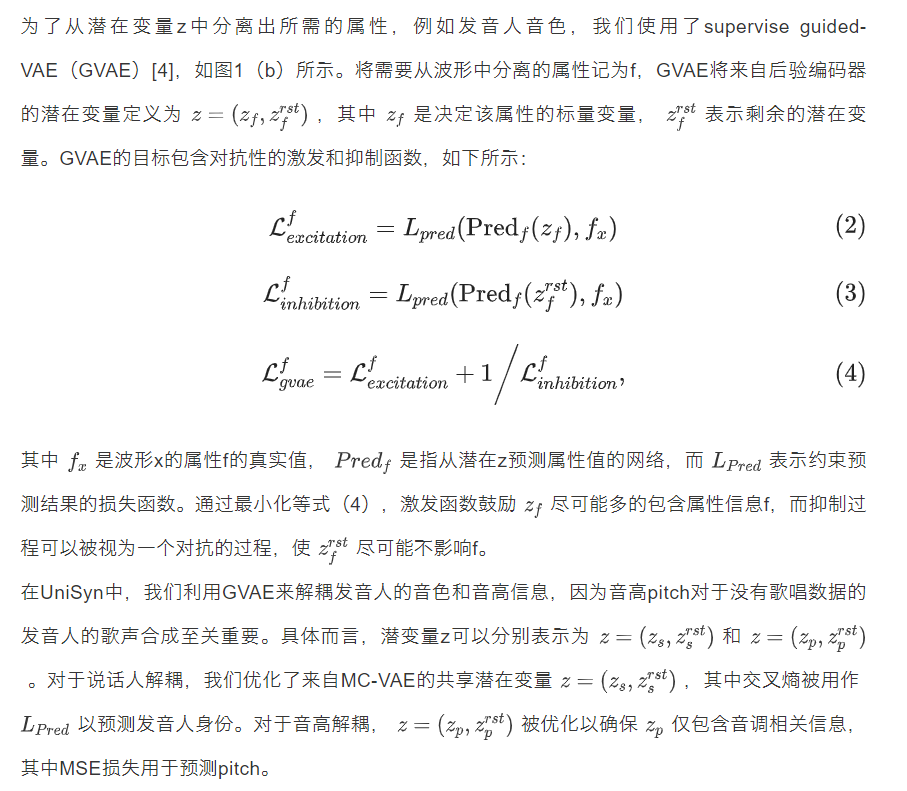
2.3 基于GVAE的解耦
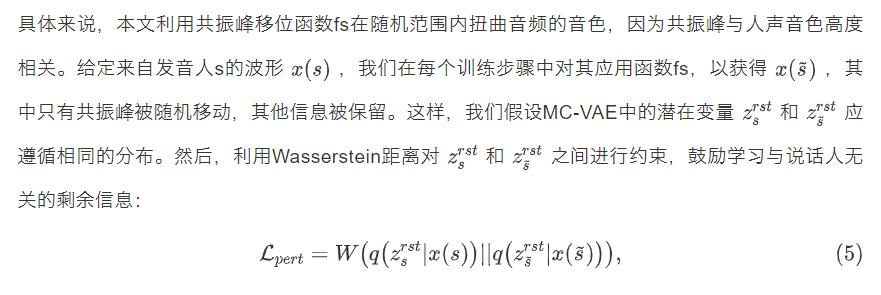
2.4 发音人音色扰动
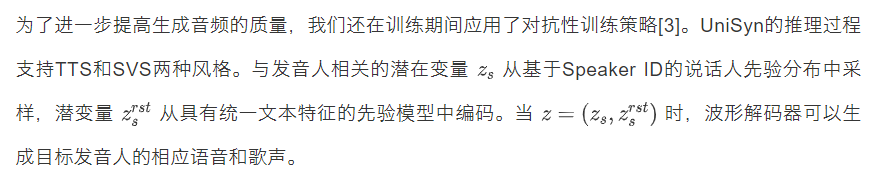
2.5 训练与推理
3.1 实验数据
为了评估UniSyn的性能,我们使用中文普通话语音和歌唱语料库进行了实验。
歌唱语料库包含两位女歌手的数据:1)Opencpop[2]开源的歌唱语料库,收录了100首由一个专业歌手录制的流行歌曲,我们称之为Singer-1;2)一个内部歌唱语料库,包含来自另一位女歌手的100首歌曲,表示为Singer-2。这两个歌唱数据集都有大约5小时的音频,我们将它们切分成句子片段进行训练。
语音语料库由两个说话人组成:1)标贝开源的普通话TTS数据集DB1[1],由一位女性说话人录制,包含约10小时的偏向中性的朗读风格语音,记为Speaker-1;2)另外一个内部录制的来自一位女性发音人朗读风格的语音,总共约5小时,我们将其称为Speaker-2。
为了平衡语音和唱歌的数据量,我们从每个说话人数据中随机选择大约2小时的音频进行模型训练。为了进行验证和评估,我们从剩余数据中选择了说话人100句话和来自每个歌手的两首预留的歌曲。我们将所有语音和歌唱音频降采样到24k Hz。
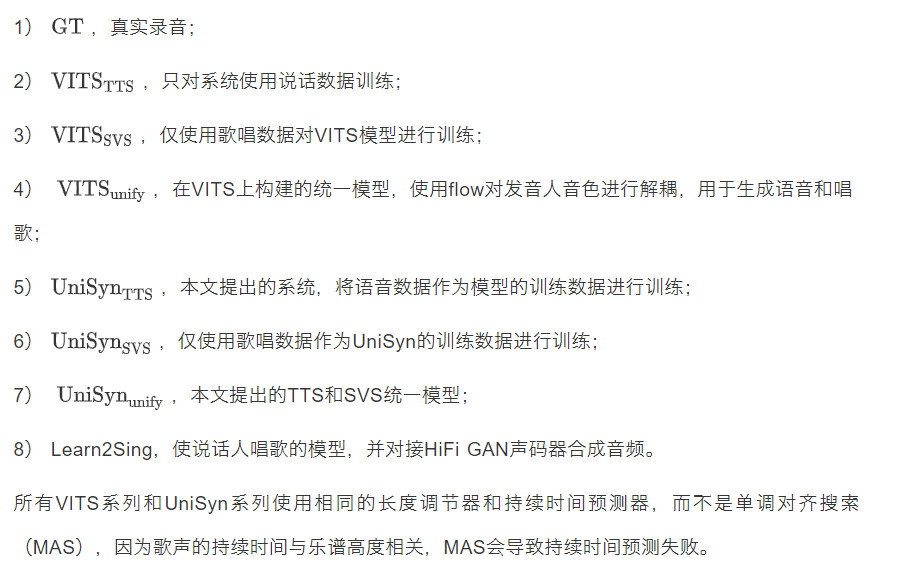
3.2 对比模型
Learn2Sing2.0 — 教师-学生学习框架下基于扩散模型和互信息的歌声合成
薛鹤洋,公众号:语音之家论文推介:Learn2Sing2.0 — 教师-学生学习框架下基于扩散模型和互信息的歌声合成
3.3 主观实验
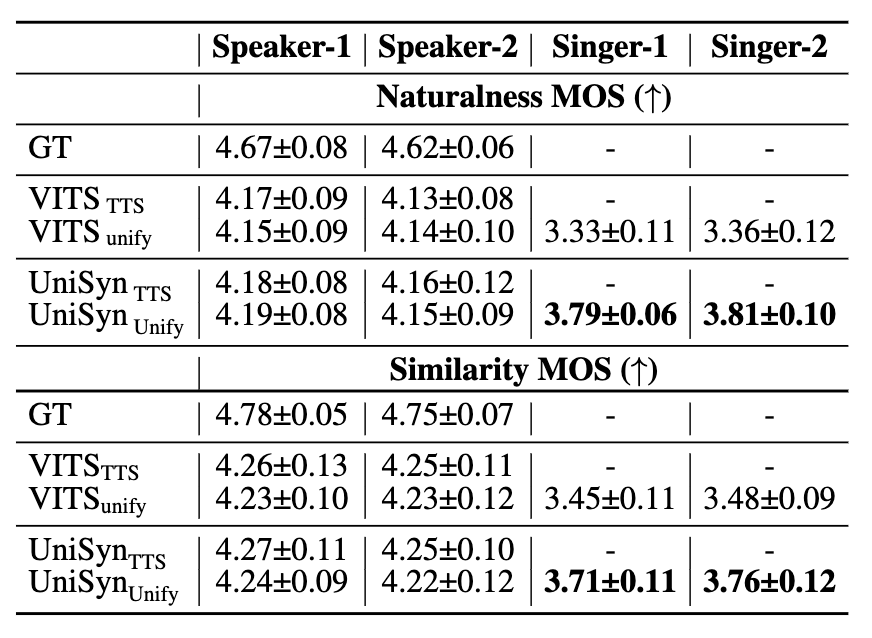
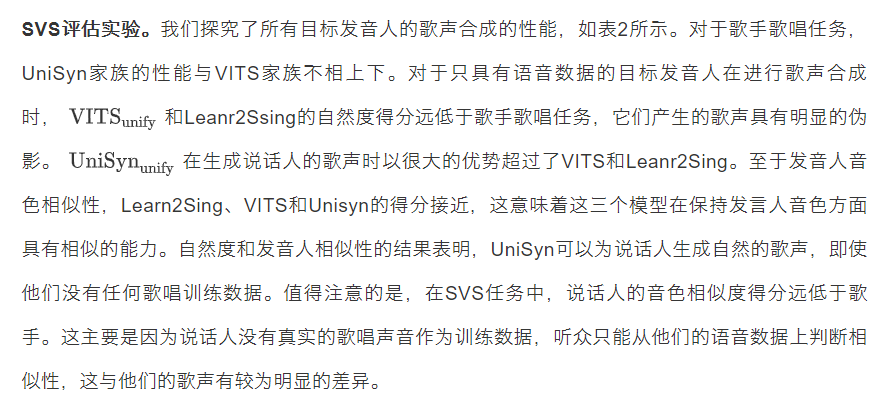
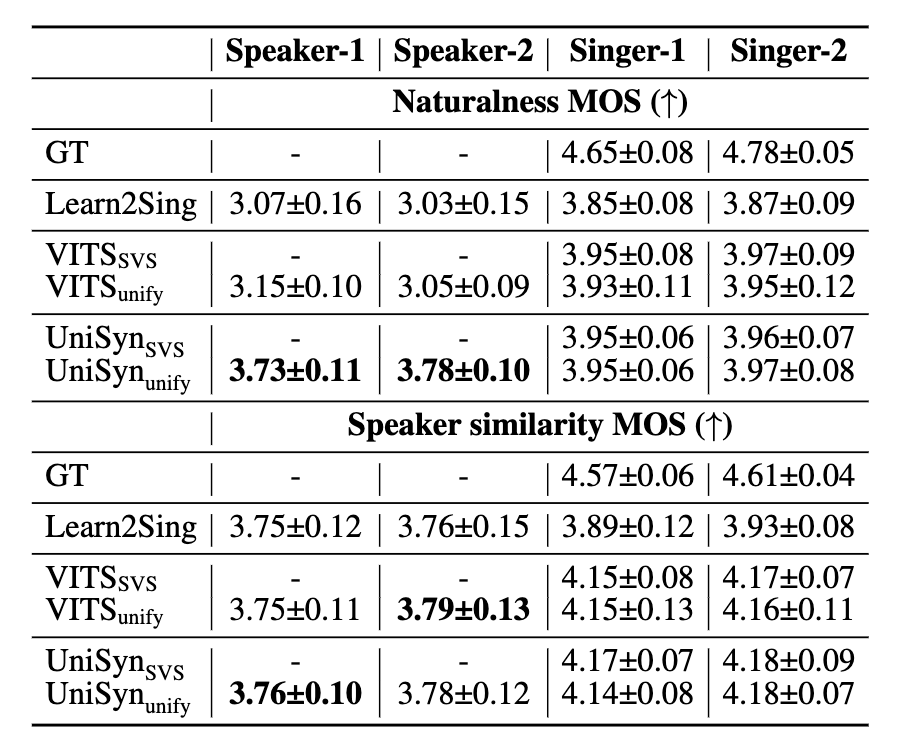
表2 SVS任务中各个系统生成歌声的自然度和发音人音色相似度MOS打分
3.4客观实验
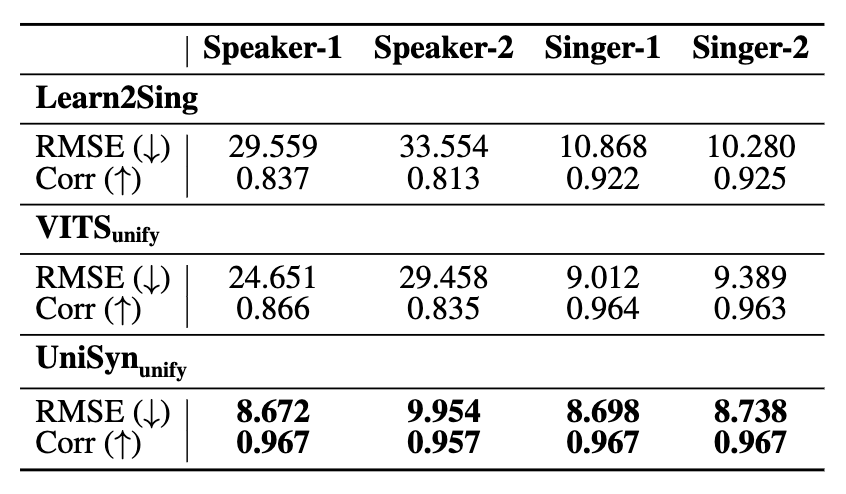
由于音高对歌声至关重要,我们对合成歌声的pitch准确度进行客观评估,如表3所示,包括与真实录音的均方根误差(RMSE)和皮尔逊相关系数(Corr)。对于Singer-1和Singer-2,所有系统的RMSE和Corr都达到了相似的水平。而对于Speaker-1和Speaker-2的歌声,UniSyn实现了最低的RMSE和最高的Corr结果,这与歌手的合成歌声达到了相当的水平。但对于Learn2Sing和VITS,RMSE仍然很高,而Corr显然处于较低水平。客观评价结果与主观测试一致,进一步证明了UniSyn统一模型可以在没有歌唱训练数据的情况下为说话人合成自然的歌声。
表3 客观实验结果
3.5 消融实验
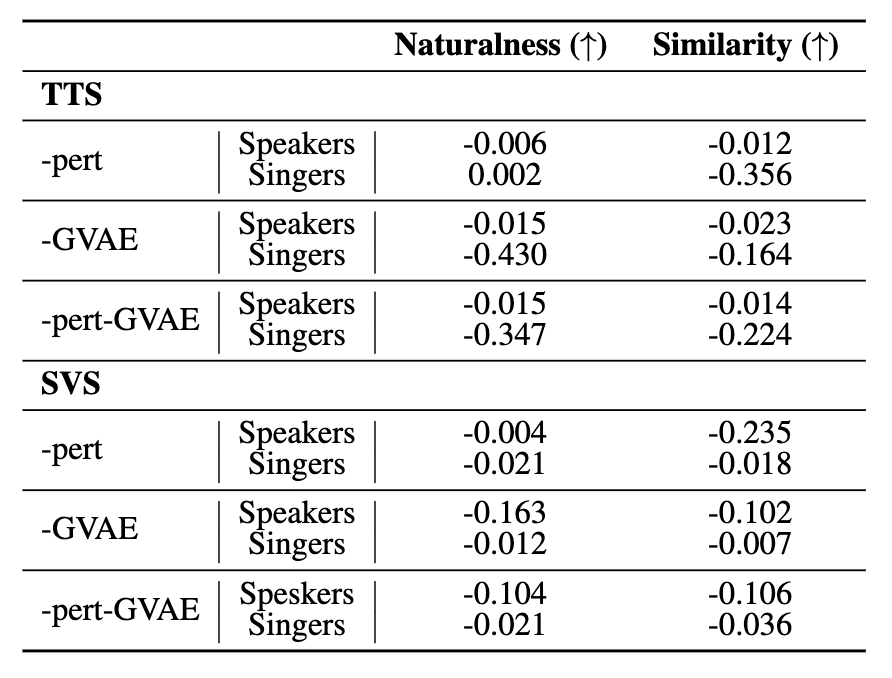
消融实验的CMOS结果如表4所示,其中“-pert”和“-GVAE”分别表示从UniSyn中去除发音人扰动和GVAE。CMOS得分越低,UniSyn就越好。从说话人的TTS和歌手的SVS结果中,我们发现去除扰动或GVAE不会对合成语音产生太大影响,这表明所提出的MC-VAE可以有效地进行语音生成。从跨发音人的交叉TTS和SVS任务中可以看出:1)去除发音人扰动策略导致发音人相似性显著下降,这表明发音人扰动主要影响跨发音人生成过程中的音色;2) 去除GVAE会显著降低自然度,并对发音人相似性产生显著影响,这表明GVAE在保持自然度和发音人相似性方面发挥着重要作用;3) 与单独移除两个组件相比,移除这两个组件得分介于单独去除二者之间。我们还注意到,去除这两种策略会导致不同程度的性能下降。去除发音人扰动会显著降低TTS和SVS的发音人相似度,同时,尽管GVAE对于TTS和SVS都是必要的,但是它对TTS任务的自然度更重要。
表4 消融实验CMOS得分
歌手一(Singer-1)
语音合成(无说话训练数据):
歌声合成:
说话人一(Speaker-1)
真实语音:
语音合成:
歌声合成(无歌声训练数据):
[1] https://www.data-baker.com/open_source.html
