低调奋进
论文统计每月更新一次,主要跟踪语音合成和语音识别的发展状况。很多文章都是在会议后才发出,但不影响统计。统计过程难免存在疏漏,因此统计结果仅供参考。
所有文章语音合成领域统计列表请访问:
http://yqli.tech/page/tts_paper.html
语音识别领域论文统计请访问:
http://yqli.tech/page/asr_paper.html
开源语音数据查询:
http://yqli.tech/page/data.html
如何查找语音资料请参考文章:
https://mp.weixin.qq.com/s/eJcpsfs3OuhrccJ7_BvKOg
文章统计excel :
https://docs.google.com/spreadsheets/d/11YYOg6i6UXw19_g1JRaXGNhvt1zhG24RgOXCzZlqZGE/edit?usp=sharing
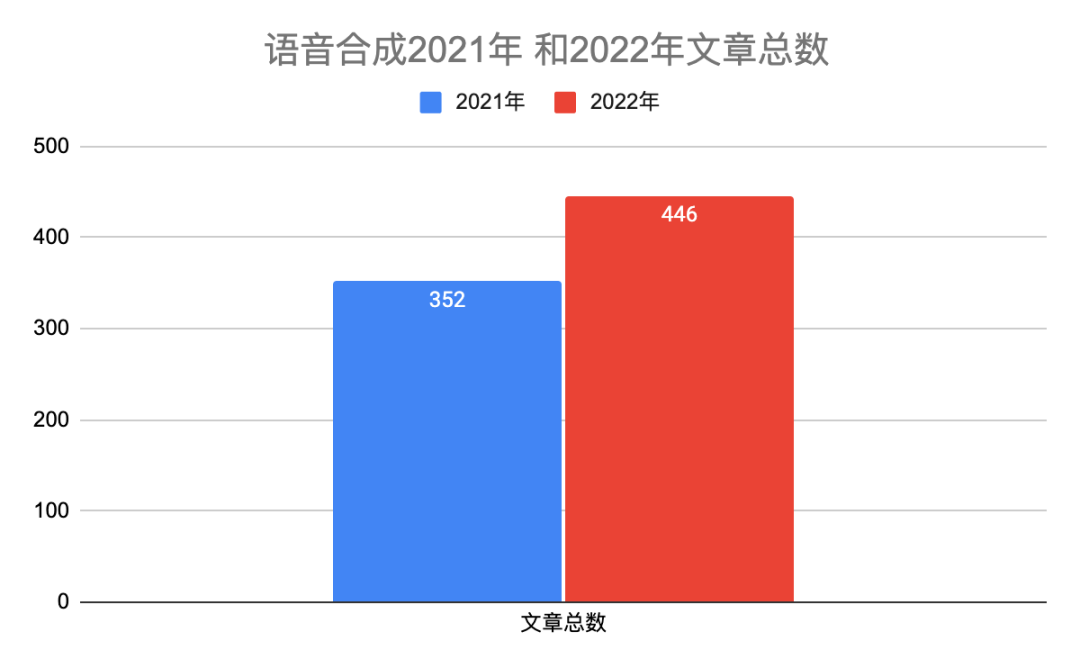
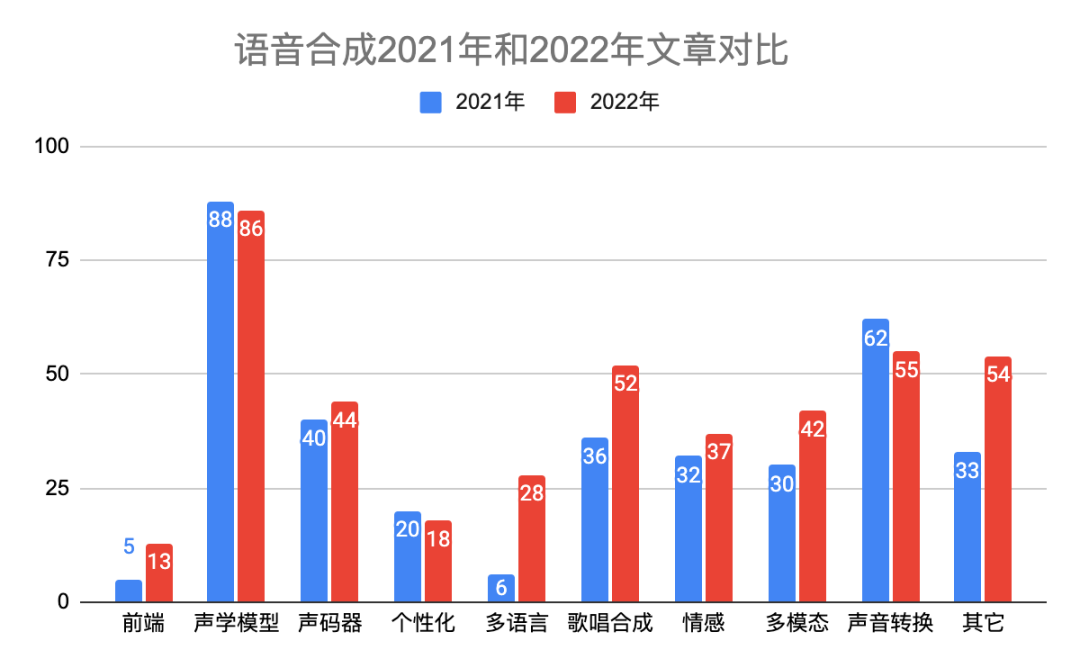
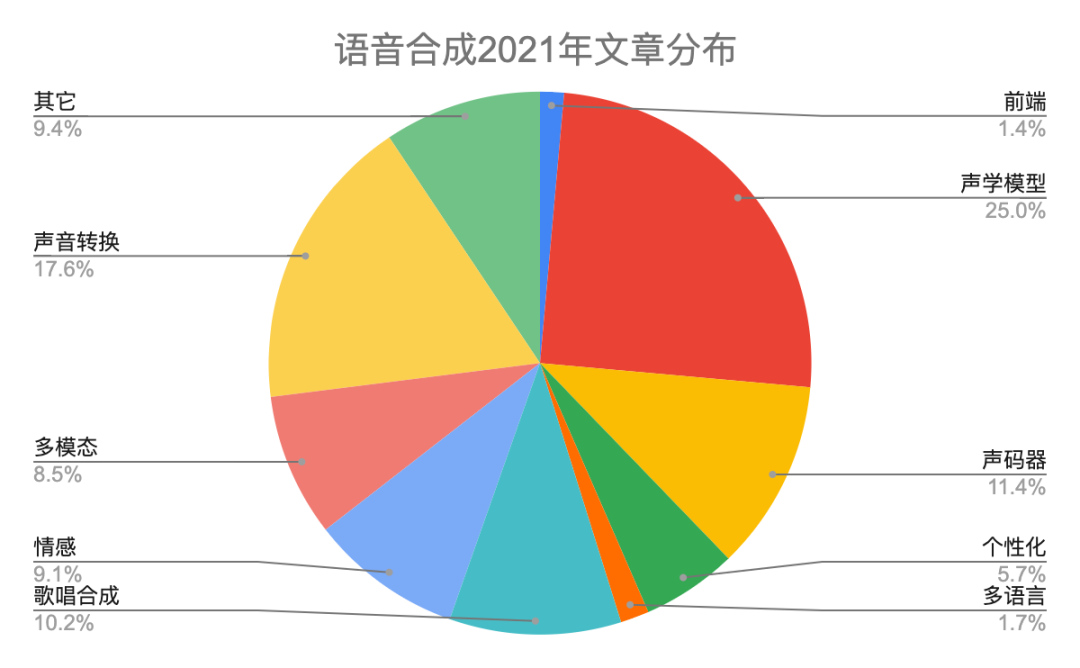
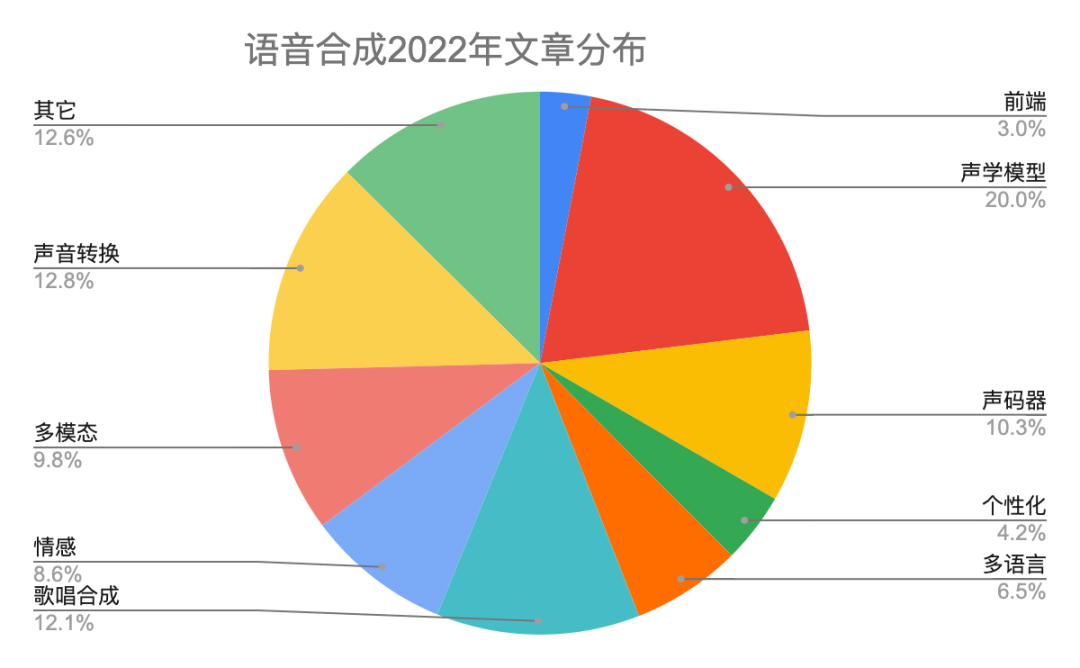
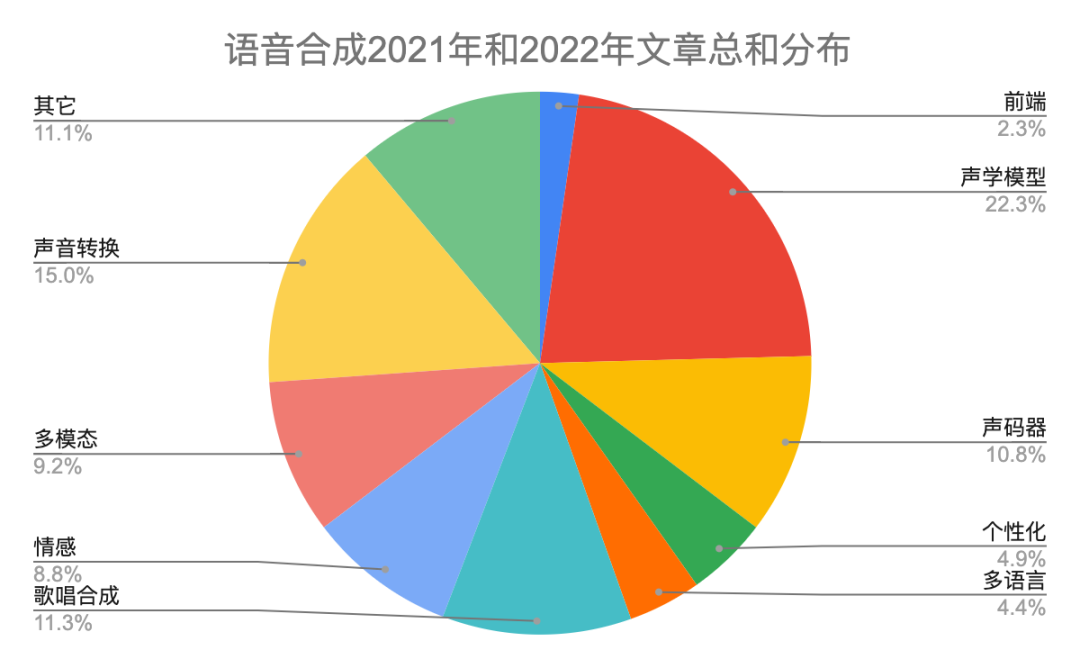
表一给出具体分类说明。2022年语音合成有446篇文章,比2021多一些。图二和图三是2022年和2021年在每个研究方向上对比柱状图和饼状图,除了声学模型网络结构和声音转换相对稍微下降,其它方向都有上升。本年度的热点主要分布在声学模型、声码器、歌唱合成、声音转换和多模态。我们知道Diffusion模型在图像领域很火,同样在语音合成领域有24篇文章采用该技术。最后,自从vits端到端以来,很多开源平台也都支持该网络,今年也有十来篇文章做端到端,比如trinitts naturalspeech等等,端到端依然会是接下来几年的研究热点。
图一 2022和2021语音合成论文总量
图二 2022年和2021年语音合成各领域文章分布柱状图
图三 2022年和2021年语音合成各领域文章分布饼状图
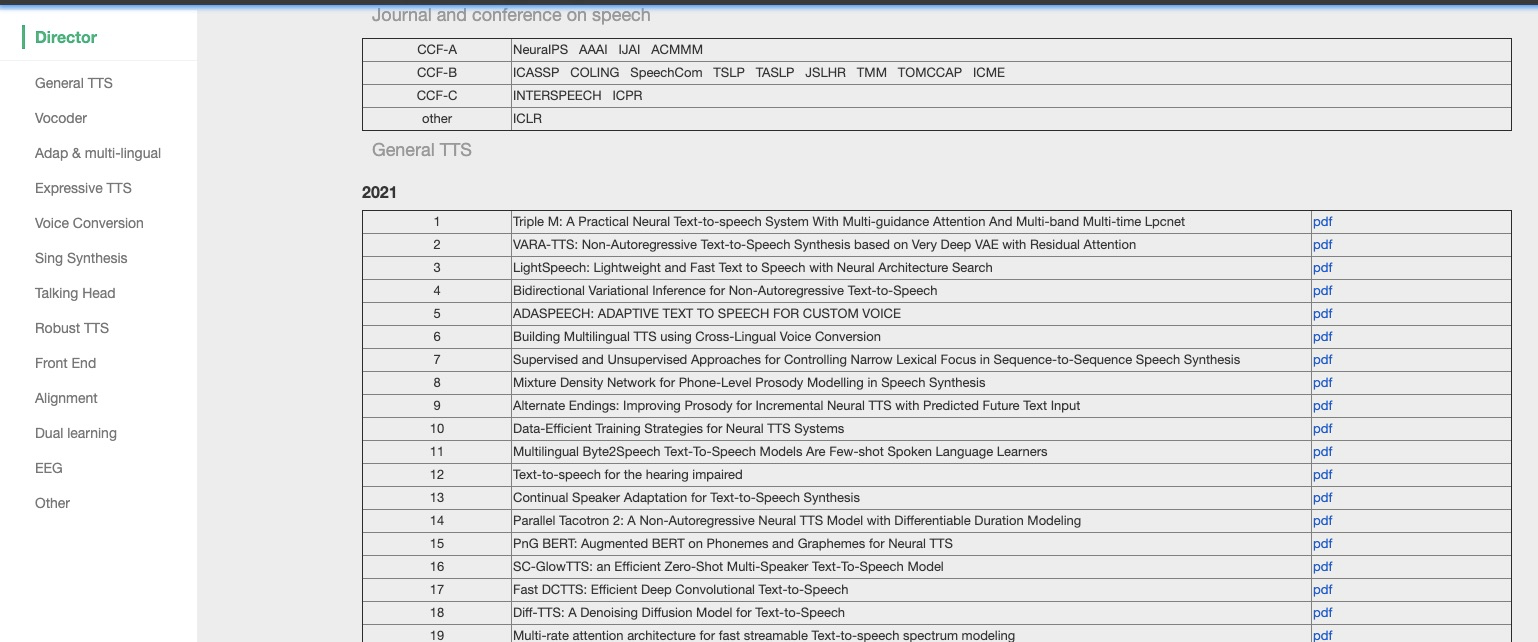
语音合成的文章列表请访问:
http://yqli.tech/page/tts_paper.html
可参见煮酒论开源语音工具包:
https://mp.weixin.qq.com/s/ZFD2mUAC1B6ZH5JEf5yJmg
| robust | 鲁棒性 |
| speaker diarization | speaker diarization |
multichannel | 多通道 |
| speech translation | 语音翻译 |
| multi-modal | 多模态 |
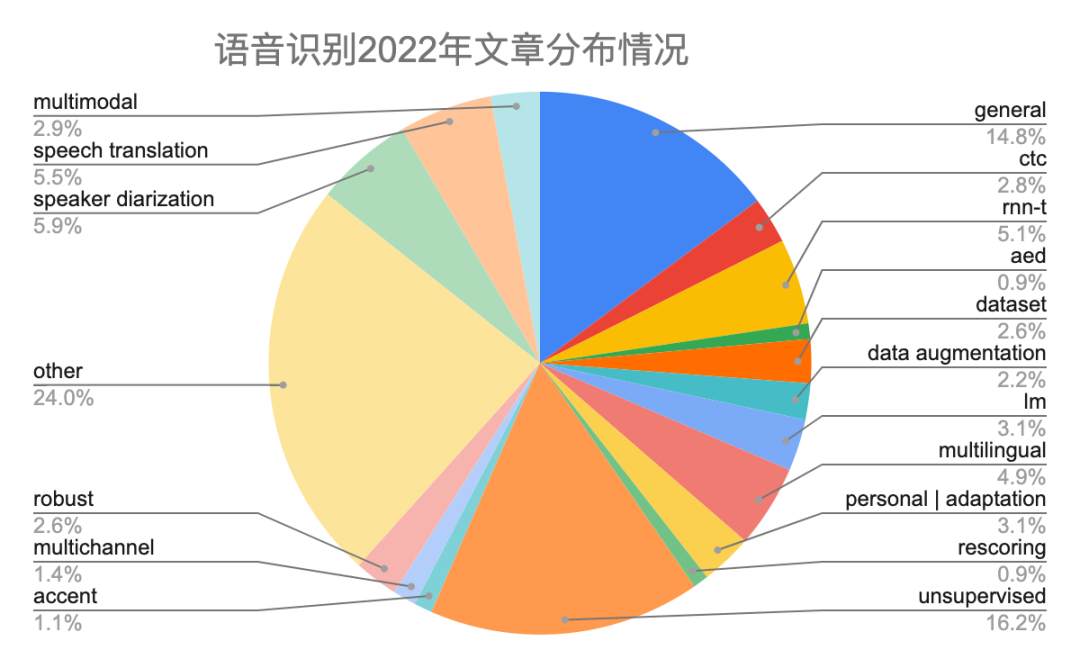
图四 语音识别文章分布柱状图(单位:篇)
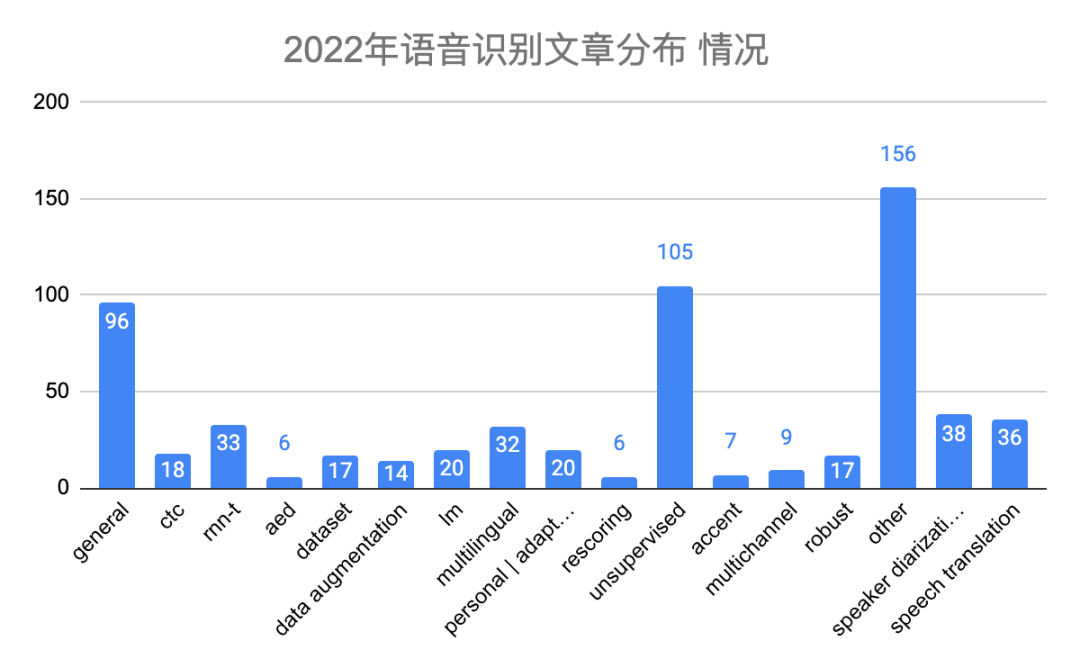
语音识别的文章列表请访问
http://yqli.tech/page/asr_paper.html