
 智能语音新青年
以下文章来源于智能语音新青年,作者ttslr
近期,ICASSP 2023会议发布录用通知,内蒙古大学计算机学院“语音理解与生成研究组”(https://ttslr.github.io/index_S2Group.html)刘瑞研究员团队提交的论文《Exploiting Modality-Invariant Feature for Robust Multimodal Emotion Recognition with Missing Modalities》被会议录用。该论文提出融合模态不变特征的缺失模态想象方法,利用模态不变特征在模态缺失条件下实现更鲁棒的多模态情感识别。
0 Abstract
利用不同模态间的互补信息能够提升多模态情感识别的性能。然而在现实环境中,我们不能保证所有模态的数据始终存在。在预测跨模态缺失数据的研究中,异质模态之间的固有差异(即模态鸿沟),成为了一个的挑战。为了解决这一问题,我们提出了“使用不变特征的缺失模态想象网络(IF-MMIN)”,该网络包括两种新的机制:1)在全模态场景下基于中心矩差 (CMD)距离的不变特征学习策略;2)基于不变特征的想象模块(IF-IM),通过这两种机制来缓解缺失模态预测中的模态鸿沟问题,提高多模态联合表征的鲁棒性。在基准数据集IEMOCAP上的综合实验表明,在不确定缺失模态条件下,所提模型优于所有基线,并不断提高整体情感识别性能。
1 Introduction
缺失模态下的多模态情感识别的研究,力求在现实环境中进行情感识别[1,2]。在现实环境中,由于摄像机遮挡、麦克风损坏等原因,一些数据可能会丢失。缺失模态问题的主流解决方案可以概括为两类:1)缺失数据生成[3-5],2)多模态联合表征学习[6,7]。在[3]中,提出了一种编码器-解码器网络,利用可用模态生成高质量的缺失模态图像。在[7]中,提出了一种具有周期一致性损失的基于平移的方法来学习模态之间的联合表征。在[1]中,结合了上述两种方法,提出了缺失模态想象网络(Missing Modality Imagination Network,简称MMIN),通过预测缺失模态信息来学习联合表征。
异质模态之间的模态鸿沟仍然是一个问题[8-10],这对情感识别的准确性产生了不利影响。如何缓解模态鸿沟成为了现在面临的问题。虽然不同的模态有其独特的特质,但它们在语义空间中共享相同的信息。在完整模态下的多模态情感识别任务中,通过引入模态不变特征,取得了显著的情感识别效果。Hazarika等[8]提出了共享子空间来学习模态之间的潜在共性,以减少模态鸿沟的影响。Liu等[11]提出了离散共享空间来捕获细粒度表示,以提高跨模态检索精度。所有的研究都表明,模态不变特征有效地弥补了模态鸿沟。我们注意到,在缺失模态下的情感识别任务中,还没有与模态不变特征有关的研究。
在这项工作中,我们提出了一个融合模态模态不变特征的缺失模态想象网络(IF-MMIN)。具体来说,我们首先采用基于中心矩差(CMD)距离的约束训练策略来学习各种模态间的模态不变性。然后,我们设计了IF-MMIN神经结构,用来从可用模态中预测缺失模态的不变特征。这样,我们对可用的模态进行了充分的探究,缓解了跨模态想象中的模态鸿沟问题,从而提高了多模态联合表示的鲁棒性。在基准数据集IEMOCAP上的实验结果表明,在所有缺失模态条件下,我们所提出的方法优于最先进的基线模型。
这项工作的主要贡献是,1)我们提出了一个基于CMD距离的约束训练来学习完整模态中的不变特征;2)在跨模态想象过程中引入不变特征,减少模态鸿沟的影响,增强多模态联合表征的鲁棒性;3)在各种缺失模态条件下的实验结果表明,所提出的IF-MMIN能够在缺失模态场景下进行准确的情绪识别。
2 IF-MMIN: METHODOLOGY
我们所提出的IF-MMIN方法首先在完整模态数据下采用基于中心矩差(CMD)距离的不变特征学习策略来学习模态特定特征和模态不变特征。在IF-MMIN训练中,IF-IM读取这两个特征,通过缺失模态想象来学习鲁棒联合表示。
2.1 CMD Distance-based Invariant Feature Learning
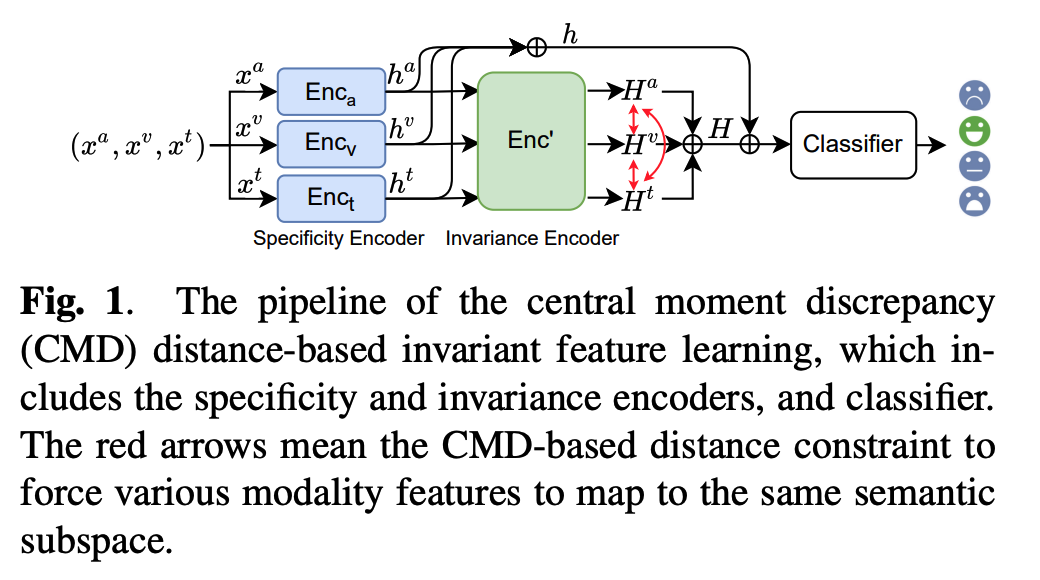
如图1所示,不变特征的学习途径包括三个模块:特定编码器(Specificity Encoder)、不变编码器(Invariance Encoder)和分类器(Classifier)。特定编码器旨在从每个模态的原始特征(xa,xv,xt)中提取高级特征(ha,hv,ht)来表示模态特定特征。不变编码器以模态特定特征作为输入,提取模态不变特征H, H由所有模态中的高级特征(Ha,Hv,Ht)拼接而成。最后,将h和H进行拼接并输入到基于全连接层的分类器中,来预测情感类别。在此之后,我们将采用经过预训练的特定编码器和不变编码器以及提出的IF-IM模块来构建IF-MMIN框架。
Specificity & Invariance Encoders
特定编码器如图1中蓝色块所示,由声学编码器(Enca)、视觉编码器(Encv)和文本编码器(Enct)组成。具体来说,基于LSTM和max-pooling的声学编码器从原始特征xa中提取出话语级声学特征ha。视觉编码器与声学编码器结构相同,用于读取原始特征xv并输出话语级视觉特征hv。文本编码器采用NLP领域颇具影响的文本表示模型TextCNN,从原始特征xt中提取话语级文本特征ht。
不变编码器(Enc')如图1中的绿色块所示,它由全连接层、激活函数和dropout层组成。它的目的是通过基于CMD的距离约束策略(如图1中红色箭头所示),将模态特定的特征(ha,hv,ht)映射到共享子空间中,以获得高级特征(Ha,Hv,Ht)。然后,我们将这三个高级特征拼接成模态不变特征H。
CMD-based Distance Constraint
基于CMD的距离约束旨在减少模态的高级特征(Ha,Hv,Ht)之间的差异。注意,CMD[12]是一个最先进的距离度量,通过匹配特征的顺序矩差来测量两个特征分布之间的差异。我们通过最小化Lcmd来学习模态不变特征:
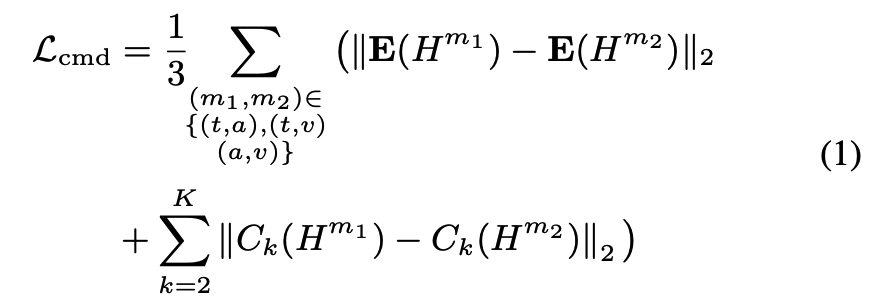
其中E(H)是输入样本的经验期望向量,Ck(H)=E((H-E(H))k)是H坐标的所有k阶样本中心矩的向量。
2.2 IF-MMIN Training
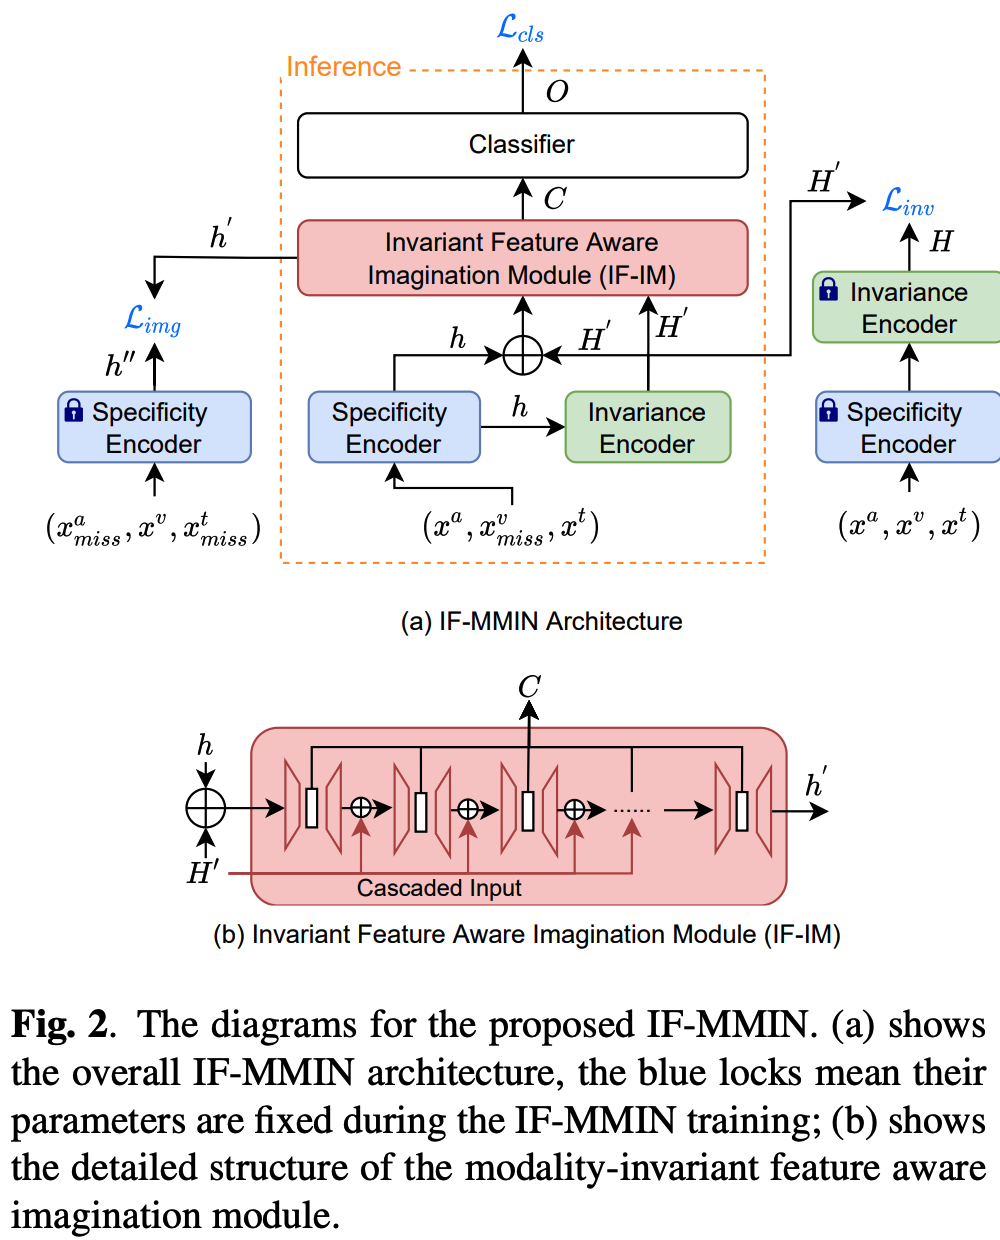
IF-MMIN的总体结构如图2(a)所示,其中包括1)特定编码器;2)不变编码器;3)模态不变特征感知想象模块,简称IF-IM;4)分类器。
设全模态输入为x=(xa,xv,xt),特定编码器以(xa,xmissv,xt)为输入(其中miss表示当前模态缺失),提取模态特定特征(ha,hv,ht),然后将其连接为最终输出h。不变编码器读取(ha,hv,ht),并从中预测模态不变特征H', H'由高级特征(H'a,H'v,H't)连接组成。然后将h和H'相加并输入到IF-IM中,以预测缺失模态的特征h'。然后将IF-IM所有中间层的潜向量组合在一起,作为联合表征C,用来预测最终的情感类别O,如图2(b)所示。为了保证IF-MMIN中模态不变特征预测和缺失模态想象过程的稳定性,在分类损失(Classification Loss, )的基础上增加了想象损失(Imagination Loss, )和不变损失(Invariance Loss, )。请注意,特定编码器和不变编码器的参数均由2.1.1节中提到的相应模块初始化。
Invariant Feature Aware Imagination Module (IF-IM)
如图2(b)所示,IF-IM由级联自编码器构成,其中包含M个自编码器。与[1]不同,IF-IM同时读取h和H'。此外,H'是基于每个自编码器的级联输入,以协助缺失模态的想象,缓解模态鸿沟问题。
Loss Functions
在IF-MMIN训练中,使用分类损失Lcls来监情感分类。更重要的是,想象损失Limg用于最小化IF-IM的输出h'与缺失模态的模态特定特征之间的差异,而不变损失旨在使预测的模态不变特征与全模态信号下的目标模态不变特征之间的距离接近。
总损失函数为三个损失函数的和:L=Lcls+aa*Limg+bb*Linv,其中aa和bb为平衡因子。
3 EXPERIMENTS AND RESULTS
我们在IEMOCAP数据集[15]上验证了IF-MMIN。按照[1],我们将IEMOCAP情绪标签分为四类:快乐、愤怒、悲伤和中性。训练集/验证集/测试集的分割比例为8:1:1。
3.1 Experimental Setup
与[1]中的相似,原始特征xa,xv和xt分别是配置为“IS13 ComParE”的130维的 OpenSMILE[16]特征、由预训练的DenseNet模型[17]提取的342维的“Denseface”特征,以及1024维的BERT词嵌入。
特定编码器Enca和Encv的隐藏大小设置为128,Enct包含3个卷积块,内核大小为3,4,5,输出大小为128。不变编码器Enc'的输出H的大小为128。IF-IM由5个自动编码器组成,每个编码器的大小为384-256-128-64-128-256-384,其中潜向量大小为64。分类器包括3个大小为{128,128,4}的全连接层。由于Linv的值比Limg小得多(约1%),我们将aa设为1,bb设为100,以平衡数值差异,提高Linv在整体损失中的重要性。批次大小为128,dropout率为0.5。我们采用动态学习率的Adam优化器[18],初始学习率为0.0002,使用Lambda LR[19]更新学习率。
我们以10折交叉验证的方式进行了所有的实验,包括不变特征学习和IF-MMIN训练,其中每折包含40个epoch。为了证明模型的鲁棒性,我们将每个模型运行三次,以减轻参数随机初始化的影响。我们在验证集上选择最佳模型,并报告其在测试集上的性能。所有模型都使用Pytorch深度学习工具包实现,并在单个NVIDIA Tesla P100显卡上进行训练。
3.2 Comparative Study
我们选用了三种多模态情感识别系统进行比较研究。1) MCTN[7]:通过缺失模态和可用模态之间的循环转换来学习联合表示;2) MMIN[1]:缺失模态问题的最先进模型,它通过自编码器和周期一致性学习,通过跨模态想象来学习联合表示;3) MMIN w/o cycle[1]:去掉了MMIN的周期一致性学习部分,只保留了缺失模态的想象过程,这正好对应我们的IF-MMIN。
3.3 Main Results for Uncertain Missing-Modality
为了在不同缺失模态测试条件[1]下验证我们的IF-MMIN,我们公布了加权精度(WA)[20]和非加权精度(UA)[21]的所有结果。
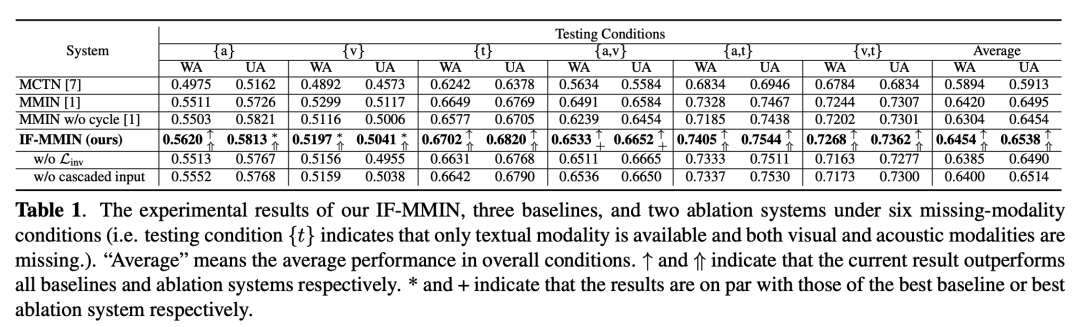
如表1的第2行到第5行所示,我们的IF-MMIN在所有缺失模态测试条件下的平均值都达到了最高水平。对于每个条件,IF-MMIN也优于除条件{a}和{v}之外的所有基线;而在这两个条件下,IF-MMIN与最佳基线相当。其原因可能是文本形态比视听形态包含更多的语义信息[22]。综上所述,所有的结果都表明IF-MMIN能够学习到鲁棒的多模态联合表征,通过引入模态不变特征能有效缓解模态鸿沟,从而在不同的缺失模态测试条件下具有显著的性能。
3.4 Ablation Study
IF-MMIN利用不变性特征H'并添加不变性损失Linv来增强缺失模态的想象,并且IF-IM将不变性特征H '作为级联输入(cascaded input)。
为了验证他们的贡献,我们进行了以下消融实验:1)IF-MMIN w/o Linv系统在IF-MMIN训练期间舍弃Linv。2) IF-MMIN w/o cascaded input系统只是将H '作为IF-IM中第一个自编码器的输入,而不是每个自编码器的输入。
从表1的第5行到第7行可以看出,IF-MMIN在大多数情况下也优于w/o Linv的IF-MMIN和w/o cascaded input的IF-MMIN,这证实了1)IF-MMIN的不变编码器可以在Linv的约束下准确预测不变特征,从而更好地为IF-IM服务;2)级联输入可以在每一层自编码器工作时提供先验知识,确实增强了IF-IM的想象能力。
3.5 Visualization Analysis
不变特征学习的准确性是IF-MMIN良好工作的前提。因此,为了验证不变特征学习相关模块Lcmd、Linv、H'和H的作用,我们对IF-MMIN进行了以下可视化实验。
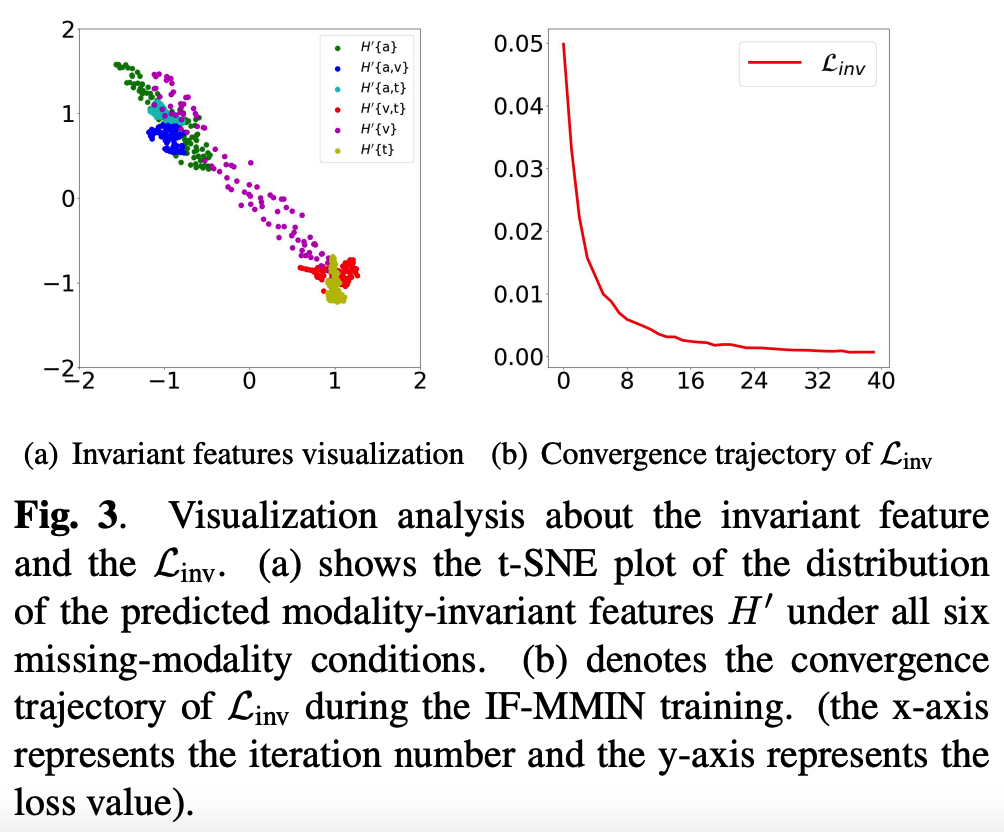
我们使用t-SNE算法在二维平面[23]中可视化6种缺失条件下的H',如图3(a)所示。我们从测试集中随机抽取600个句子,每个缺失条件对应100个句子,提取600个不变特征H'。因此,图3(a)中有600个点,每种颜色各有100个点。观察到,在各种条件下的所有在特征分布上形成了清晰的聚类,这是振奋人心的。图3(b)为IF-MMIN训练过程中Linv轨迹的收敛情况,其中x轴为迭代次数,y轴为损失值。从图中的平滑曲线可以看出,H'和H在训练过程中是非常接近的,进一步证明了Linv的有效性。由于H是在Lcmd约束下学习的,也证明了Lcmd的有效性。
4 CONCLUSION
本文研究了一种新的基于不变特征的多模态情感识别模型(IF-MMIN),该模型包括基于CMD距离的不变特征学习和基于不变特征的缺失模态想象模块(IF-IM)。通过利用不变特征,我们的IF-MMIN可以缓解模态鸿沟,提高多模态联合表征的鲁棒性。在IEMOCAP上的实验结果表明,在各种缺失模态条件下,我们所提出的IF-MMIN优于初始基线。在未来的工作中,我们将进一步探索和改进不变特征学习的方法。
