
 智能语音新青年
论文地址:https://arxiv.org/abs/2310.00704
0、ABSTRACT
演示和代码已发布:https://uniaudio666.github.io/demo_UniAudio/
1、INTRODUCTION
音频生成是生成式人工智能的重要组成部分。最近,生成式人工智能的普及引发了音频生成方面日益增多和多样化的需求:音频预计根据人类需求生成,例如语音合成(TTS),语音转换(VC),歌唱声音合成(SVS),文本到声音和文本到音乐。以往的音频生成任务通常是任务特定的:它们的设计严重依赖于领域知识,并且它们的使用受限于固定的设置(Tan et al.,2021; Luo&Mesgarani,2019; Zmolikova et al.,2023; Huang et al.,2021b; Cho et al.,2021)。与独立处理每个任务不同,这项工作是试图实现通用音频生成的一次尝试,旨在通过一个统一的模型完成多个音频生成任务。通用音频生成模型预计将获得音频和相关模态的足够先验知识,从而有可能提供生成不同类型音频的简单有效解决方案。
大语言模型(LLM)在文本生成任务中的卓越性能启发了音频生成中一系列基于LLM的模型(Wang et al.2023a; Kharitonov et al.2023; Huang et al.,2023b; Agostinelli et al.,2023; Borsos et al.,2023)。在这些工作中,LLM在独立任务中的能力已经在文本到语音(TTS)(Wang et al.,2023a; Kharitonov et al.,2023; Huang et al.,2023b)和音乐生成(Agostinelli et al.,2023; Copet et al.,2023)等任务中得到广泛研究,并取得了竞争性的性能。然而,LLM在处理多个任务方面在音频生成研究中尚未充分利用:大多数现有的基于LLM的工作仍然是为单一任务而设计的(Wang et al.,2023a; Kharitonov et al.,2023)。我们认为,通过LLM范式实现音频生成的普适性和多功能性是有前景的,但在这项工作之前尚未全面研究过。
为了实现通用音频生成,本工作提出了UniAudio,它采用LLM技术,能够根据各种输入模态(如音素序列,文本描述和音频本身)生成多种类型的音频(语音、声音、音乐和歌唱)。所提出的UniAudio主要具有以下特点:首先,所有类型的音频以及所有输入模态都被标记为离散序列。具体而言,构建了一个通用神经编解码模型,用于有效地标记音频,无论音频类型如何,同时使用其他类型的标记器来标记不同的输入模态。然后,UniAudio将源-目标对连接为单个序列。最后,UniAudio使用LLM执行下一个标记的预测。在分词过程中使用基于神经编解码器的残余矢量量化(Zeghidour et al.,2021),导致产生过长的标记序列(一个帧对应多个标记),这些标记序列不能有效地被LLM处理。为了降低计算复杂性,设计了多尺度Transformer架构,分别对内部和帧间相关性进行建模。具体而言,使用全局Transformer模块来建模帧间相关性(例如,语义级别),并使用局部Transformer模块来建模帧内相关性(例如,声学级别)。
为了展示UniAudio在新任务上的可扩展性,UniAudio的构建过程分为两个阶段。首先,提出的UniAudio在多个音频生成任务上进行联合训练,这使模型不仅能够获得音频的内在属性,还能够获得音频与其他输入模态之间的相互关系的足够先验知识。其次,通过微调,经过训练的模型可以无缝支持更多未见过的音频生成任务。因此,UniAudio有望成为通用音频生成的基础模型:它能够不断支持音频生成的新需求。在实验中,我们的UniAudio支持11个音频生成任务:训练阶段包括7个音频生成任务,而在微调阶段又添加了4个任务。UniAudio的构建过程扩展到了165,000小时的音频和10亿个参数。在这11个任务中,UniAudio在客观和主观评估中一直取得了竞争性的性能。在其中大多数任务上甚至取得了最先进的结果。进一步的研究表明,在训练阶段同时训练多个任务对每个涉及的任务都有互惠互利的效果。此外,UniAudio能够有效地适应新的音频生成任务,并在与特定任务模型相比具有显著差距的情况下表现出色。
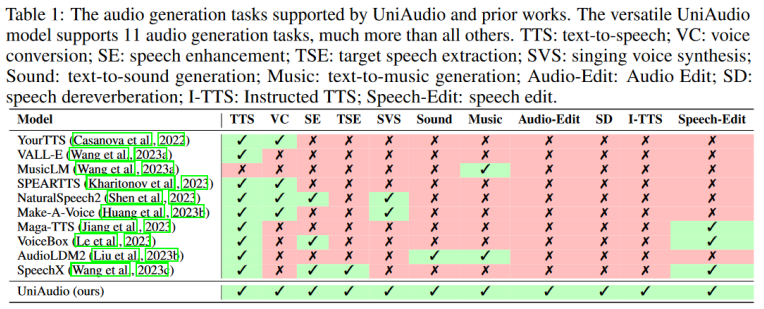
朝着通用音频生成的方向,UniAudio被提出作为11个音频生成任务的统一解决方案,这一数字超过了音频生成研究中已知的所有工作。
在方法学上,UniAudio提供了以下新颖方法:(i) 音频和其他输入模态的顺序表示;(ii) 针对基于LLM的音频生成任务的统一公式;和(iii) 专门为音频生成设计的高效模型架构。
通过实验证明,UniAudio的整体性能得到了很好的验证,构建多功能音频生成模型的益处得到了详尽的实验结果验证。
发布了演示和代码,希望UniAudio能成为未来研究中支持新兴音频生成的基础模型。
2、UNIAUDIO
本节介绍了提出的UniAudio的技术细节。第2.1节解释了音频和其他模态是如何进行分词的。然后,在第2.2节中,所有考虑的音频生成任务都以统一的方式进行了阐述。随后,在第2.3节中提出了多尺度Transformer架构,以应对由于采用神经编解码器而引起的过长序列挑战。
2.1、TOKENIZATION
LMs通常用于顺序建模,因此在处理之前需要对音频和所有其他输入模态进行分词。每个模态的这些过程由独立的模块完成。所有这些模块在UniAudio的优化中都是固定的或无参数的。
2.1.1、AUDIO
在本工作中考虑的所有音频生成任务中,无论其类型(语音、声音、音乐或歌唱),音频都是要预测的目标。与分别对不同类型的音频进行建模不同,UniAudio意图将所有类型的音频都分词为一个统一的模态(尽管它们通常具有不同的模式,如频率范围等),这需要一个适合将所有音频类型映射到共享潜在空间的模型。在本工作中,采用神经编解码器模型(Défossez et al.,2022; Yang et al.,2023b),如Wang et al.(2023a); Kharitonov et al.(2023)所述,用于音频分词。具有采样率 fs 的持续时间 d 的音频信号可以由序列 x 表示。音频神经编解码器旨在通过具有量化模块的编码器-解码器架构将压缩然后恢复为 :

其中 T 表示编码器下采样后的音频帧数,L 表示编码器的特征维度。音频的离散表示是量化过程的中间产物。对于任何隐藏输出 ht的帧,整数向量zt 由残余矢量量化(RVQ)(Zeghidour et al.,2021)生成,其中 nq表示矢量量化层的数量。迭代地,每个元素 zt^k是在所有预先学习和固定的第 k 级量化器向量{qk^*}中,其与ht 和所有先前选择的量化器向量之间的残差的 L2 距离最小的索引。使用离散表示 zt,ht^ 被重建为 ht 的一个紧密估计,可以用来恢复 xt。
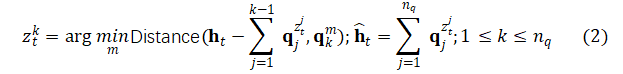
所有音频帧的离散表示z是一个矩阵,需要在LM处理之前转换为序列:它被简单地扁平化为一个序列,其中一个帧的每个 nq 元素是连续的。由于可以使用神经编解码器从 z 恢复波形,因此本文的其余部分主要讨论如何使用LM技术来预测音频标记序列 z。有关本工作中采用的神经编解码器的详细信息在附录E中。
2.1.2、 OTHER MODALITIES
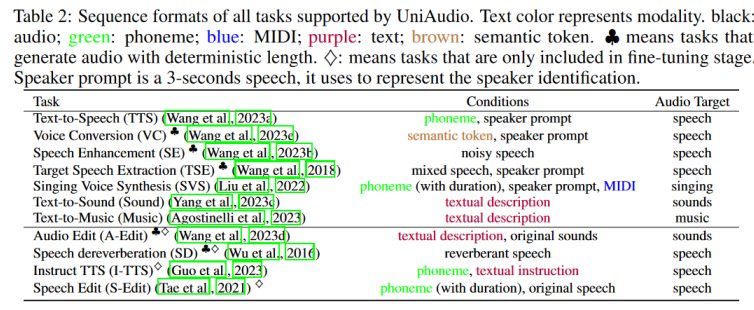
除了音频之外,UniAudio考虑的其他模态也需要表示为序列。此外,大多数这些序列都通过标记化转化为离散序列。这些输入模态的序列化和标记化,以及它们的关键特征,如表2所示,被简要总结如下。
音素:音素是语言学中语音发音的基本单元。音素序列具有多个来源:(1)当仅有文本可用时,可以通过使用发音字典进行文本到音素映射来获取没有持续时间信息的音素序列;(2)当仅有语音可用时,可以通过DNN-HMM系统的束搜索来获取具有持续时间信息的音素序列(Hinton et al.,2012);(3)当文本和语音都可用时,可以通过DNN-HMM系统的强制对齐来获取具有持续时间信息的音素序列。
MIDI:MIDI(Zhang et al.,2022)广泛用于歌声合成任务。MIDI中包括F0和持续时间信息。我们使用持续时间信息来扁平化F0序列,以获得帧级别的F0序列。
文本:文本可以作为音频生成任务中人类指令的载体(Yang et al.,2023a; Copet et al.,2023)。在本工作中,这些文本指令被表示为从预训练的文本大型语言模型(Raffel et al.,2020)派生的连续嵌入,因为这些嵌入包含丰富的文本语义。如何使用LLM处理这些连续嵌入将在第2.33节中进一步说明。
语义标记:语义标记是从音频自监督学习(SSL)模型输出的连续嵌入派生的。这些连续表示具有高度的信息量,可以用于语音理解(Rubenstein et al.,2023)和生成任务(Borsos et al.,2023)。按照Huang et al.(2023b)的方法,通过对这些连续表示进行K均值聚类(Hsu et al.,2021),将这些连续表示划分为离散表示。由于连续表示是帧级的,因此语义标记还编码了持续时间信息。
2.2、UNIFIED TASK FORMULATION
对于UniAudio考虑的所有任务,目标音频是根据给定条件生成的。在相同的目标模态,即音频情况下,正是条件定义了不同的音频生成任务。然而,即使在条件方面存在差异,所有任务仍然可以统一制定为可以由LLM处理的顺序建模任务:首先将目标音频和条件都转换为子序列,然后拼接为[conditions, target]序列进行处理。
UniAudio总共支持11个音频生成任务。每个任务的顺序格式在表2中定义,其中所有模态的子序列如第2.1节中所述派生出来。然而,由于每个任务的独特配置,一些条件子序列在标记化过程中会受到特定于任务的预处理操作的影响。对于音频,这些操作主要用于数据损坏,例如在标记化之前在原始音频中添加噪声、混响和与其他发言者混合的语音。对于音素和语义标记,默认情况下保留了持续时间信息,但也可以被删除。对于歌声合成和语音编辑任务,音素的持续时间信息被使用。对于TTS和I-TTS任务,不使用持续时间信息。对于MIDI,持续时间信息用于重复F0序列。对于文本嵌入,本工作中不应用任何操作。
为了避免歧义,插入了一些特殊的离散标记(用<>括起来),以指示以下内容:(1)整个序列的开始和结束;(2)某个模态的每个子序列的开始和结束;和(3)任务标识符。例如,对于一个文本到声音任务序列,该任务基于文本描述生成目标音频,整个序列如下所示:text_sequenceaudio_sequence。
2.3、MULTI-SCALE TRANSFORMER
基于LLM的音频生成的先前工作(Copet et al.,2023)提倡将离散音频标记建模为扁平化序列。如果这样做,这些序列将在长度为 的情况下进行处理,考虑到Transformer(Vaswani et al.,2017)相对于长度的二次复杂性,这是非常具有挑战性的。受到Yu et al.(2023)的启发,特别为离散音频序列设计了一个多尺度Transformer架构,这是一个分层模型,通过全局和本地Transformer模块分别处理帧间和帧内相关性。
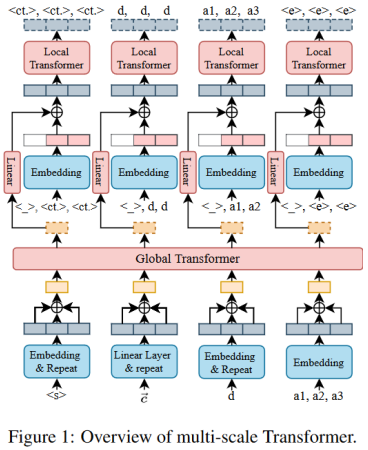
图1显示了提议的架构概述。与以前的工作Kharitonov et al.(2023)一样,多尺度Transformer不是逐个标记地处理整个扁平化序列,而是将块(即,每个连续的nq个标记)视为全局建模单元,然后在每个块内部处理标记。对于音频标记序列,每个块包含nq个连续的音频标记,确切地表示一个音频帧。首先,如方程2所建议的,不管每个量化向量的具体选择如何,都是使用总和量化向量来表示音频帧。因此,在嵌入阶段,每个块(也称为帧)由进入全局Transformer之前的相应嵌入的总和向量表示。其次,全局Transformer是逐帧预测音频的:为了预测帧,它输出包括帧和所有先前内容的连续表示。这些连续表示将由本地Transformer进一步处理。第三,与方程2中的情况一样,鉴于隐藏表示,获取独立于之外的任何隐藏输出。受到这一启发,合理地预测帧xt的离散标记,也就是块zt,仅使用与帧xt-1对应的全局Transformer的隐藏输出。更详细地说,由于每个标记的获取都是自回归地依赖于其之前的标记,因此采用本地Transformer以自回归方式预测块序列。在这个过程中,由全局Transformer输出的相应向量充当块级别的上下文,它经过线性变换,然后添加到每个标记的嵌入结果中。
所提出的多尺度Transformer架构也适用于除音频之外的离散和连续序列。对于除音频之外的所有离散标记(音素、语义、MIDI和特殊标记),每个标记具有独立的语义,因此应该占用一个块。因此,这些离散标记重复了次,以填充每个块。连续文本嵌入也重复了次以达到相同的目的。此外,它们的嵌入过程被线性变换替代,而它们在本地Transformer的预测目标是连续的特殊标记。
提出的多尺度Transformer的设计可以有效地降低计算复杂性。首先,全局Transformer的等效序列长度从减少到,这使得全局建模成本与无关,因此采用更大的变得可行。其次,生成每个帧的离散标记的块内计算被转移到本地Transformer。本地Transformer上的计算相对较轻,因为它只处理非常短的序列(固定为长度),并且根据设计经验具有较少的参数,少于全局Transformer。
3、EXPERIMENTS
3.1、EXPERIMENTAL SETUP
数据和模型:本工作采用了12个数据集,所有这些数据集都是公开可用的。总音频时长为165,000小时。有关每个任务的详细数据统计以及它们在每个任务中的使用情况,请参见附录A.1。来自所有模态的离散标记形成了一个大小为4212的联合词汇表,包括所有特殊标记。全局和本地Transformer一致采用具有因果性的Vanilla Transformer解码层。总体参数预算约为10亿。详细的模型配置请参见附录A.2。现有的神经编解码模型对于通用音频生成来说不是最佳的,主要是由于数据覆盖不足。然后,使用较少的量化级别、更小的每秒帧速率、更高的质量和更广泛的覆盖面构建了一个改进的神经编解码模型。
训练和推断:训练阶段包括7个任务,而在微调阶段添加了4个新任务。表2指定了仅用于微调的任务。训练和微调均使用了16个AMD MI200-64G GPU完成。优化的详细配置请参见附录A.3。为了在微调过程中保持先前任务的性能,根据任务重新采样训练数据,α = 0.05。一致采用了Top-k抽样进行推断,其中k和温度分别设置为30和0.8。由于全局Transformer不直接预测标记,因此抽样过程仅在本地Transformer推断中发生。
评估:对于评估,大多数任务使用客观和主观指标进行评估。一般来说,对于客观评估,使用词错误率(WER)来评估生成的语音的可懂性;相似度分数(SIM)用于评估说话者身份的相似性;声音质量的感知评估(PESQ)、VISQOL、DNSMOS和梅尔倒谱失真(MCD)是从人类听觉研究中得出的信号级质量指标;与(Copet et al.,2023)一样,Frechet音频距离(FAD)、Kullback-Leiber(KL)散度和Frechet距离(FD)用于音频保真度和音频相似性;对于主观评估,采用MOS和SMOS来提供针对语音和歌唱相关任务的以人为本的判断。对于文本到声音和文本到音乐任务,我们使用总体质量(OVL)和与文本输入相关性(REL)(Copetet al.,2023)。请注意,所有主观结果均来自Amazon Mechanical Turk,以进行公平比较。附录B显示了主观评估过程的详细信息。
3.2、THE RESULTS OF 7 GENERATIVE TASKS IN THE TRAINING STAGE
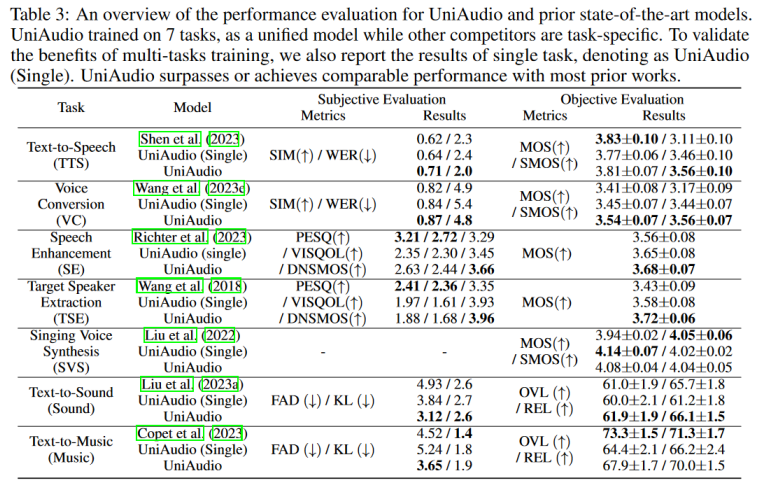
表3呈现了提出的UniAudio模型在所有7个音频生成任务上的综合评估结果。先前的各个任务的最新工作也被列为竞争对手。为了全面比较现有的音频生成方法,这些竞争对手不仅包括基于LLM的方法,还包括基于扩散模型的方法以及其他传统的音频生成方法。由于许多任务有多个竞争对手,每个任务的详细比较见附录C。如预期的那样,UniAudio是一个多功能系统,可以一起处理所有7个音频生成任务,并取得竞争对手的表现。根据主观评估,UniAudio在6个任务中的3个(TTS、VC、声音)中超越了竞争对手;根据客观评估,在7个任务中有5个任务获得了最佳结果,只有SVS和音乐两个任务没有。UniAudio在SE和TSE方面的主观性能不如竞争对手,这也在以前的文献中观察到(Erdogan et al.,2023),即信号级评估指标可能不适用于生成方法。UniAudio无法在音乐任务中超越其竞争对手(Copet et al.,2023)。然而,这些模型使用的私有数据比本工作更多。表3还验证了同时训练多个任务对每个涉及的任务都是有益的:在7个任务上训练的模型一致优于其单一任务对应的每个模型。这一好处可以归因于大规模数据和各种任务以及不同模态之间的内在联系,这也在文本语言研究中观察到(Radford et al.,2019)。
3.3、FINE-TUNING RESULTS
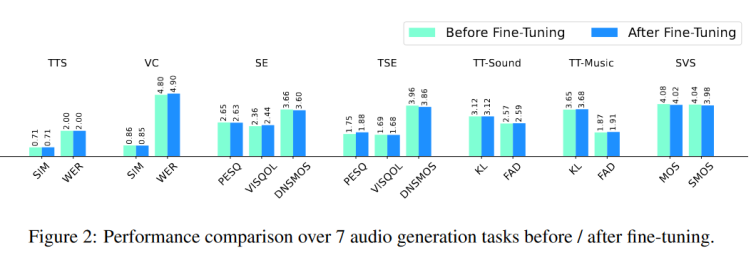
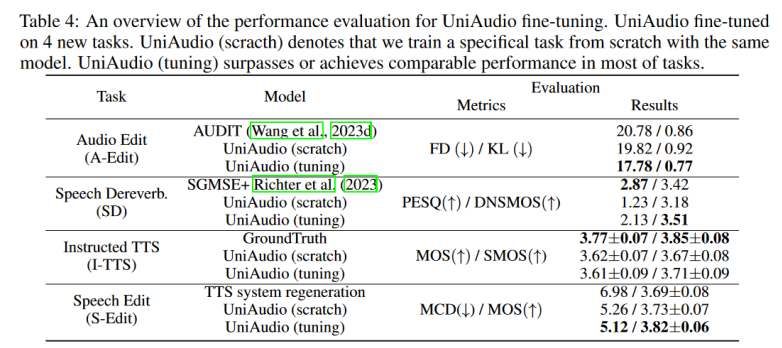
UniAudio的设计旨在通过微调不断支持新的音频生成任务。图2和表4分别展示了7个预训练任务和4个新任务的评估结果。首先,图2表明,微调阶段不会导致在先前的7个生成任务上的显著性能下降。其次,经过微调的UniAudio模型在音频编辑和语音去混响方面超越了竞争对手,并接近于指导TTS任务的基本真实质量。对于语音编辑,与生成整个句子相比,UniAudio表现出了显著的改进。第三,几乎在所有看不见的任务中,从头开始构建的单一任务系统与通过微调构建的多功能系统之间都可以观察到非常显著的改进。所有这些观察结果都支持了提出的UniAudio有望成为音频生成的基础模型。
4、DISCUSSION ON MODEL ARCHITECTURES
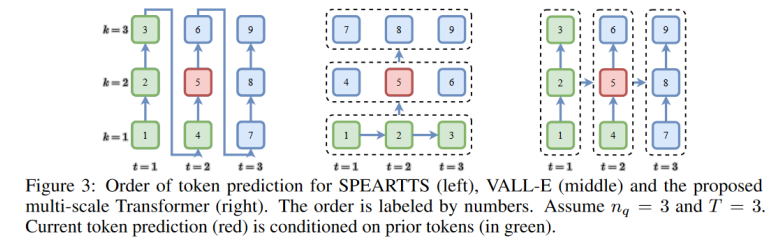
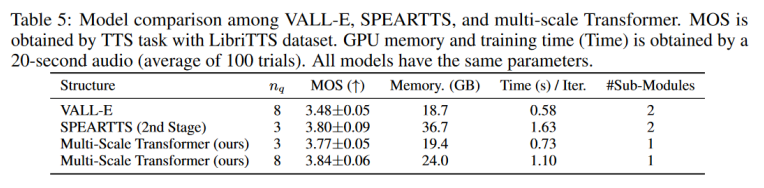
与第2.3节类似,采用神经编解码器已成为基于LLM的音频生成的常见选择,但会引发过长序列的问题,需要进一步考虑。本节将提出的多尺度Transformer与领域内两种典型方法进行比较:SPEARTTS11(Kharitonov et al.,2023)和VALL-E。图3是这三种架构的示意图。表5提供了基于非官方实现12的结果。自回归性能:先前的工作Copet et al.(2023)发现,自回归是音频生成质量的关键因素。SPEARTTS和多尺度Transformer都是自回归的:任何标记的预测都基于其所有先前的标记。然而,在要由VALL-E预测时,部分先前的标记不予考虑(例如,参见图3中间的蓝色块,当要预测红色块时,标记id 4和7未被使用)。自回归属性的必要性在表5中进一步通过实验证实:即使在具有最高的情况下,VALL-E在MOS评估中的表现仍不及其竞争对手。较大的和效率:增加nq会提供更高的重建质量,但训练时需要更长的序列和更多的计算。对于SPEARTTS,计算复杂性的限制比其他两种方法更严格。在SPEARTTS中,采用了普通的Transformer解码器来建模平铺的长序列,其空间复杂度为。因此,SPEARTTS对非常敏感:如表5所示,在的情况下,训练需要更多的时间和内存,甚至在我们的实验中采用 时无法收敛。接下来,VALL-E和多尺度Transformer的空间复杂度均为,与无关,并允许采用较大的(例如8)。从实验角度来看,与VALL-E相比,多尺度Transformer消耗更多的内存和时间。需要澄清的是,不论如何,VALL-E的每次迭代训练只采用了每个帧的2个编解码器标记(分别用于自回归和非自回归模块),因此它的训练不包括整个长序列。相比之下,多尺度Transformer是在每个帧的所有标记上进行训练的。此外,与VALL-E和SPEARTTS不同,后者由两个子模块组成,具有指定的输入和输出(I/O)格式,而提出的多尺度Transformer是一个集成模型,与标准LLM共享相同的I/O格式,更适合作为基础模型。基于所有这些考虑,本工作认为,所提出的多尺度Transformer在音频生成中是更有前途的选择。
5、RELATED WORKS
这项工作代表了朝着利用基于LM的技术实现通用音频生成的重要一步。在LM时代之前,各种音频生成任务,如TTS和语音转换,都得到了广泛研究,每个任务都有自己专门的架构、训练目标和受语言学、信号处理、听觉感知和机器学习研究影响的设计原则。这些任务通常采用不同的生成模型,如扩散模型、基于流的模型和Seq2Seq模型等。然而,只有有限数量的算法可以处理多个音频生成任务,通常是将某些任务视为特殊情况或为每个任务训练单独的模型。
大语言模型的出现,以及提示方法的使用,启发了基于文本指令或描述的新音频生成任务,如Instruct-TTS和Text-to-sound。此外,基于LM的音频生成模型在泛化到未见过的说话者、资源稀缺情景和多语言环境方面表现出卓越的能力。这些模型在各自领域内取得了最先进的结果。
单独处理每个音频生成任务是一项耗时的工作,特别是考虑到数据稀缺性和这一领域不断发展的需求。建立通用音频生成模型提供了一种有前景且实际的替代方案。虽然一些并行工作可以处理多个音频生成任务,但它们并没有将通用性作为核心设计目标,或者仅限于一些语音任务的子集。本工作中提出的UniAudio模型支持11个音频生成任务,超越了所有已知的工作。它还展示了能够无缝集成新的音频生成任务的能力,填补了当前文献中的空白。
6、LIMITATION
并非所有已知的音频生成任务都包括在提出的UniAudio中,这是因为这些任务的需求和定义各不相同。而且,所有在微调中添加的新任务都基于训练阶段已知的模态。尚未探讨如何集成具有未知模态的新任务的问题。
7、CONCLUSION
为了应对音频生成领域不断出现的各种需求,本研究试图实现通用音频生成。提出的UniAudio是一种基于语言模型的生成模型,支持11种不同的音频生成任务,这一数量超过了音频研究领域的所有现有工作。在实验中,提出的UniAudio在所有11个任务上都表现出了竞争力,并在其中几个任务上取得了业界领先的结果。它还通过实验证明了持续集成未知音频生成任务的能力。我们发布了演示和代码,希望UniAudio可以成为未来音频生成研究的通用基础模型。
8、ETHICAL STATEMENT
我们正在深入探讨使用大型语言模型技术生成多样化音频的革命性领域。我们发现自己处于创新和责任的交汇点。必须承认我们工作的伦理维度,并确保我们的贡献用于社会的利益。开放性:随着我们在这个领域的发展,确保这项技术的好处普及而不是仅限于少数特权人士至关重要。我们的代码与此提交一起公开发布,以确保每个人都能平等地访问。所有实验都基于开放获取的数据集进行,允许进行研究导向的比较和复制。避免滥用:虽然我们的模型可以生成各种音频内容,从音乐到语音,但在生成虚假信息、深度伪造音频或任何有害内容方面存在潜在的滥用可能性。我们呼吁负责地采用我们的代码和模型,充分尊重个人隐私并遵守相关法规。关于潜在的滥用问题,我们不会发布checkpoint。
