西工大音频语音与语言处理研究组
文章来源于音频语音与语言处理研究组,作者宋堃
端到端语音到语音翻译(Direct/E2E S2ST)是指一个神经网络模型完成从一个语种的语音到另外一个语种语音的直接翻译。然而目前的研究主要集中在语义翻译的准确性,忽略了源语言到目标语言的语音风格迁移。缺乏高保真表现力并行数据使得这种风格转移具有挑战性,尤其是在实际应用场景中往往没有目标语言的语音,需要实现零样本(zero-shot)迁移。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)和字节跳动合作论文“StyleS2ST: Zero-shot Style Transfer for Direct Speech-to-speech Translation”被语音研究顶级会议INTERSPEECH 2023接收。该论文首先使用多语种多说话人文本到语音合成(TTS)系统构建并行语料库,在此基础上提出了基于风格适配器的具有跨语言语音风格迁移能力的StyleS2ST模型。现对该论文进行简要的解读和分享。
论文题目:StyleS2ST: Zero-shot Style Transfer for Direct Speech-to-speech Translation
合作单位:字节跳动
作者列表:宋堃,任意,雷怡,王春峰,魏坤,谢磊,殷翔,马泽君
论文链接:https://arxiv.org/abs/2305.17732
发表论文截图
扫码直接看论文
1. 背景动机
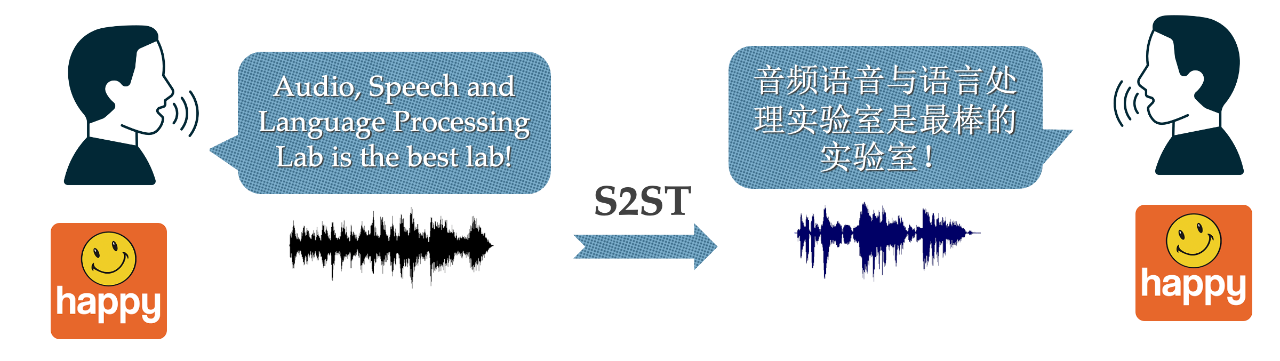
当前,由于自监督预训练语音模型的迅速发展,通过使用预训练模型如HuBERT [1]提取的特征并做k-means聚类得到的离散单元可以很好地表示语音中的语言信息,有助于模型更好地学习源语言和目标语言之间的对齐关系。因此,当前Direct S2ST已经实现了接近甚至优于传统级联系统的语义翻译性能。但是当前Direct S2ST只关注于语言学信息,而忽略伴随源语言语音的说话风格信息(包括说话者的音色、语调、节奏等)。而这些风格信息显着影响语音的表现力和自然度。随着 S2ST 应用场景的增加,在许多场景中,例如电影配音翻译,将源语言风格转换为目标语言语音往往是至关重要的。图1展示了保留表现力的场景。然而,由于缺乏来自同一说话人多语种语音平行数据,构建具有风格迁移的 S2ST 是极具挑战的。此外,在实际应用中,不能仅迁移训练集中存在的风格特征,因为源语言语音中可能存在多种风格表达。也就是说,对于任意新说话人的任意训练集中未见过的风格,我们都应该能够迁移,在本文中我们将其称为 S2ST 的零样本风格迁移。
针对以上问题,本文提出StyleS2ST模型。首先,我们使用双语平行文本作为输入,利用预先训练的多语种多说话人 TTS 系统,构建了高质量的双语平行语料库。其次,由于合成语音在语言和口语风格上都是并行的,我们基于 SOTA 的端到端语音到离散单元英译汉(En2Zh)架构[2]构建模型。为了实现零样本风格迁移,我们在 该系统中采用了基说话人嵌入(Embedding)的预训练风格适配器。实验结果表明,所提出的StyleS2ST 模型可以进行零样本端到端语音到语音翻译,同时保留从源语言到目标语言的说话风格。
2. 提出的方案
语料库构建
为了训练 StyleS2ST,我们需要首先构建一个英中双语的说话人平行语料库。为了构建该语料库,我们首先训练一个英中双语的多说话人 TTS 系统。如图2,该TTS系统采用基于声学模型Fastspeech 2 [3] 和声码器HiFi-GAN [4] 的架构。我们使用国际音标 (IPA) 作为系统的输入来模拟不同语言的共享语音空间。之后,我们使用编码器将输入音素序列编码为隐藏表示,该表示与说话人嵌入和语言嵌入相连接,以合成目标语言和所需说话风格的语音。由于缺乏平行语料库,每个说话人只有英文或中文数据。尽管如此,使用 IPA 作为输入可以让我们获得不同说话者的双语高保真合成语音。为了评估和过滤训练 S2ST 的合成语音,我们利用词错误率(WER)和语音质量感知评估(PESQ来检查语言错误和语音质量,把不符合要求的语音从语料库中剔除。
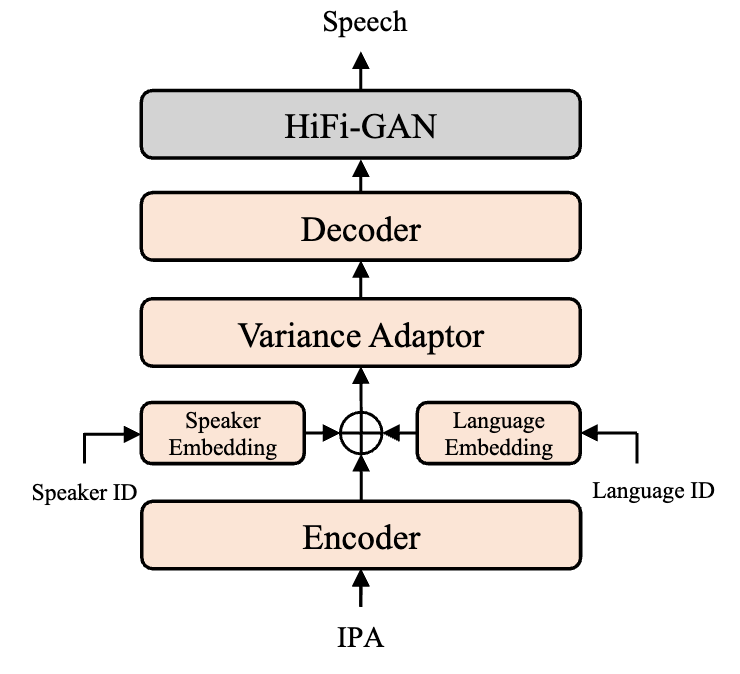
图2 多语种多说话人TTS系统
StyleS2ST 模型结构
我们通过预训练的 HuBERT 模型提取伪数据对的隐藏表示,该模型是在大量未标记的语音数据上进行训练的。提取的语音隐藏表示通过 k-means 方法进行聚类,将语音编码为离散单元,作为 S2UT 系统的中间表示。如图3,端到端StyleS2ST 模型由语音到单元和单元到语音模块组成。此外,我们保留连续的重复单元,以尽可能保留时长中的韵律,这是一种风格信息。语音到单元(S2UT)模块采用基于 Transformer 架构的预训练 wav2vec 2.0 [5] 语音编码器和预训练unit-BART [6] 解码器。但我们并没有像以往工作一样直接使用HiFi-GAN 声码器作为单元到语音(UT2S)模块。相反,我们将UT2S过程两部分:声学模型和声码器。这个流程在TTS中使用更普遍,并且易于风格控制。
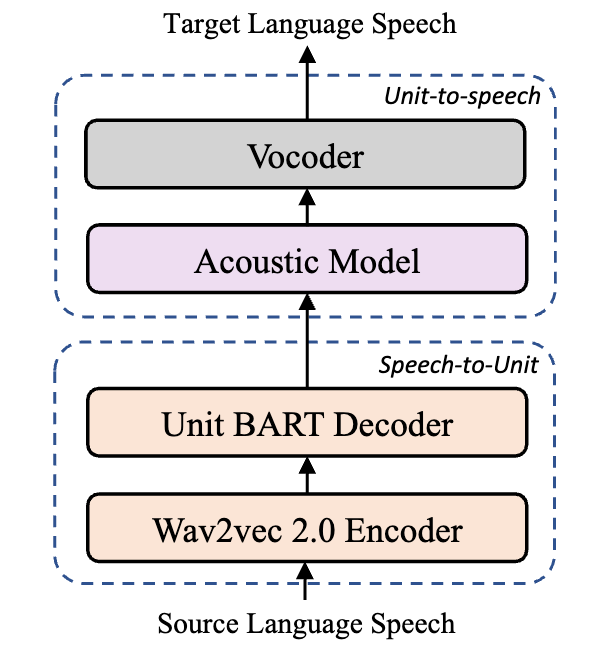
图3 StyleS2ST模型结构
声学模型
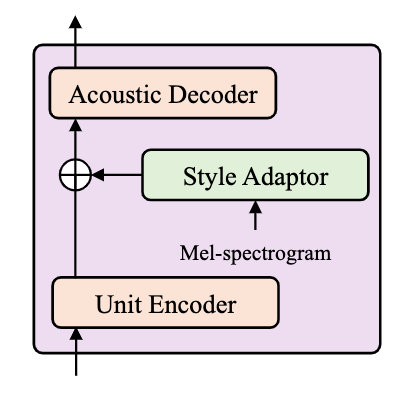
在语音到单元(S2UT)模块中保留时长使得声学模型的输入能够表达局部风格特征,例如韵律信息。为了捕获全局风格特征,包括说话人的音色,我们采用了句子级全局风格适配器,该适配器使用预训练说话人嵌入模型提取特征。具体来说,我们采用 ECAPA-TDNN [7] 说话人嵌入模型作为风格适配器,并使用大量的中文和英文平行数据其进行预训练。通过使用两种语言进行训练,可以避免不同语言之间说话人表征空间的不匹配问题,这对于我们的 S2UT 模块至关重要。我们使用单元作为单元编码器的输入来捕获上下文信息。图4是风格适配器模块的实现,该模块提取风格嵌入作为声学解码器的附加条件。这使得模型可以建模连续声学空间,并具备风格控制能力。鉴于平行数据中说话人的数量有限,我们采用大量未配对的中文数据来预训练声学模型。说话人适应过程中的微调可能会导致灾难性的遗忘问题。因此,我们选择不对平行语料库上的预训练模型进行微调。相反,我们使用平行语料库中的中文语音和未配对的中文数据来训练预训练模型,从而增加了可用的训练数据量。
3. 实验
数据
中英文平行语料库:我们基于CoVoST 2 [8]语音到文本翻译数据集搭建平行语料库,该数据集包含512K条英语语音和相应的中文文本数据对。然而,由于 CoVoST 2 中的英语语音数据质量不高,因此我们在实验中仅使用文本数据。我们使用由 20 个说话人组成的内部数据集训练多语种多说话人 TTS 系统。每个说话人约有5000条、5小时的高保真高表现力中文或英文数据,风格多样,包括故事、广播等,覆盖不同性别和年龄的说话人。我们通过多说话人多语种TTS系统,使用 CoVoST 2 中的中文文本和其对应于Common Voice [9] 数据集中相应的英文文本,并使用不同的说话人合成相应的英汉语音对。而后我们剔除了其中了WER高于6%或PESQ低于3.9的数据。过滤后,我们总共获得了277K个英汉语音对,分别包括263和124小时的语音数据。
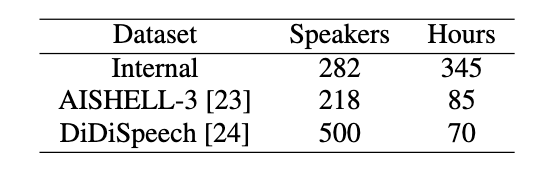
预训练数据:为了提高模型的泛化性能并实现零样本迁移能力,我们使用了大量具有不同声学条件的中文语音数据。具体来说,我们利用一个内部数据集以及两个开源数据集 AISHELL-3 [10] 和 DiDiSpeech [11],其中包含 1,000 名不同年龄和性别的说话人的 共500 小时语音。从总共 500 小时的数据中,我们从 1K 个说话人中随机选择了 300 小时进行预训练。数据如表1所示。
测试集:对于集内说话人,我们从平行语料库随机抽取了200句英文数据。对于集外说话人,我们使用20个英文说话人,共100句英文。
对比系统
Direct S2UT:直接使用[1], 为了与我们提出的模型可比,我们使用声学模型-声码器结构代替原系统中的单元到语音模块
StyleS2ST:本文提出的系统
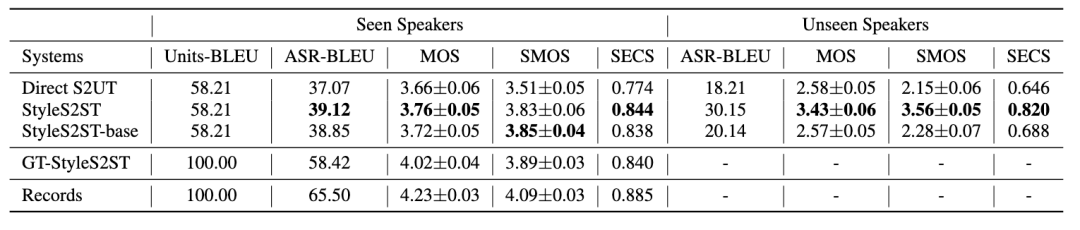
StyleS2ST-base:在提出的系统中不使用中文TTS数据预训练,用于测试预训练的作用
GT-StyleS2ST:提出的系统中使用真实的离散单元,用于测试单元到语音模块的性能
实验结果
为了评估翻译质量,我们首先计算翻译离散单元的 BLEU 分数,称为Units-BLEU。接下来,我们使用内部中文 ASR 模型将合成语音识别为文本并计算 BLEU 分数,我们将其称为 ASR-BLEU。为了评估合成语音的自然度和风格相似度,我们对每个系统的所有测试集进行平均意见得分 (MOS) 测试,对每个样本进行评分,包括自然度和风格相似度。此外,我们使用从合成中文和真实英语语音中提取的说话人嵌入之间的说话人编码器余弦相似度(SECS)作为客观评估指标。
如表2,ASR-BLEU 显着低于units-BLEU,并且通过真实录音与GT-StyleS2ST 间的比较,ASR 系统和合成语音质量会导致BLEU下降。并且在未见说话人上,翻译的准确性也有所下降。在Direct S2UT系统和StyleS2ST-base系统中,单元到语音模块的集外泛化能力较差,导致合成语音的可懂度下降,这反映在较低的ASR-BLEU分数上。关于风格转移性能,我们观察到Direct S2UT 系统在集内说话人中实现了良好的风格相似性,这表明离散单元仍然包含一些与说话人相关的信息,特别是不做去重的离散单元。同时,在具有风格适配器的系统中,相似度和自然度显著提高。在未见说话人中,与见过的说话人相比,Direct S2UT 和 StyleS2ST-base 模型的自然度和风格相似度都显着下降,而我们提出的 StyleS2ST 模型保持了更好的自然度和风格相似度。这些结果证明了我们预训练的声学模型的有效性。
预训练消融
为了研究零样本场景中用于预训练声学模型的数据大小和说话人数量的影响,我们通过改变数据大小和说话人数量进行分析,并评估合成语音的自然度和风格相似度。
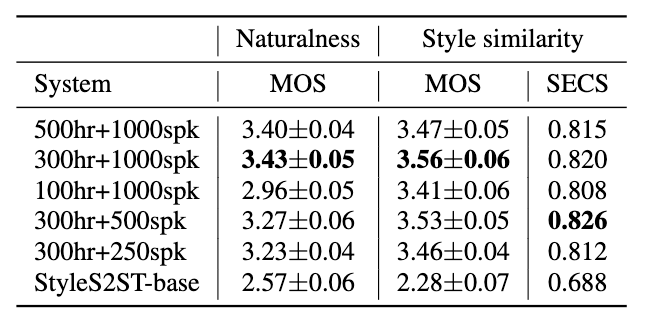
表3中的结果表明,这两个因素对模型的自然度和风格相似度的性能都有显著影响。当数据量从1000个说话人的300小时增加到500小时时,性能会下降。我们推断这可能是由于模型容量限制造成的,模型大小限制了模型能够完全收敛于更大规模的数据集。