
 西工大音频语音与语言处理研究组
合作单位:阿里巴巴达摩院语音实验室
作者列表:梁宇颢,俞帆,李泱泽,郭鹏程,张仕良,陈谦,谢磊
论文网址:https://arxiv.org/abs/2305.13716
图1 发表论文截图
图2 扫码直接看论文
近期,针对远场多说话人语音识别举办了多个竞赛,包括M2MeT[1]和MISP[2]等,推动了多说话人语音识别(Multi-talker ASR)技术的发展。多说话人语音识别要解决的一个关键问题是语音重叠(speech overlap)。
一个直观的解决方案是显式的使用语音分离,然后再用单说话人ASR识别文本,而置换不变训练(permutation invariant training , PIT)[3]方法被广泛地应用于说话人无关的语音分离。PIT考虑了输出标签的所有可能的排列组合,然后选择能最好地分离出单个说话人信号的排列组合来使误差最小化。它也被扩展并应用于多说话人ASR[4],以处理标签和ASR识别结果之间的排列组合问题。在多说话人ASR中应用PIT已经得到了广泛研究,包括联合优化、端到端方法和多通道方法等。然而PIT仍存在一些限制,例如最大的说话人数量受限于输出头的数量,增加输出层的数量会导致训练过程的计算复杂度爆炸。
与PIT不同,条件链(conditional chain)[5]是另一种流行的语音分离的方法,它能迭代地从混合音频信号中产生不同的说话人的信号,从而不受说话人数量的限制。通过使用条件链,一个有多个说话人的混合音频输入可以依次被分离成单独的输出,每个输出对应一个不同的说话人,而之前的输出序列作为分离的条件输入。这种方法也可以扩展到多说话人的ASR任务,直接产生不同说话人的ASR识别结果。条件链的局限性是计算成本高,因为它需要多次迭代来从混合音频中分离出每个说话人的语音信号。该模型的性能也会受限于初始分离的准确性,因为在初始分离步骤中引入的任何错误都会在条件链的后续步骤中传播。相比之下,序列化输出训练(Serialized Output Training, SOT)[6]作为一种端到端的训练方法,通过使用单一的输出层,在一个解码过程中产生不限数量的说话人的ASR结果,克服了这些限制。
SOT主要面临两个挑战。首先,预测代表“说话人变化”的特殊分隔符 依赖于说话人的知识,而ASR本身是独立于说话人的任务。因此准确地预测说话人对于ASR解码器来说是很困难的。针对这一问题,我们将SOT改造成一个多任务学习框架,包含ASR和说话人切换预测两个任务。为此我们设计了一个额外的说话人切换预测模块用来学习说话人知识。通过多任务学习,我们大幅提高了说话人切换预测的准确性。SOT中面临的第二个挑战是缺乏时间上的单调性,因为SOT的标签是根据先进先出顺序组织的,然而这与CTC的单调性机制相悖。为了解决这个问题,我们提出了一个两阶段的CTC策略,用字符级的序列化输出训练(token-level Serialize Output Training, t-SOT) [7]的CTC进行分层编码。此外由于SOT格式包括由多个句子组成的音频片段,我们进一步引入了一个包含真实时间戳的边界约束损失辅助ASR和说话人切换预测任务。本文方法称之为Boundary-aware SOT(BA-SOT)。
我们在SOT的基础上做了三项改进,以更准确的预测说话人的变化。具体来说,我们的BA-SOT包括一个说话人切换预测模块,一个边界约束损失,和一个两阶段的CTC。
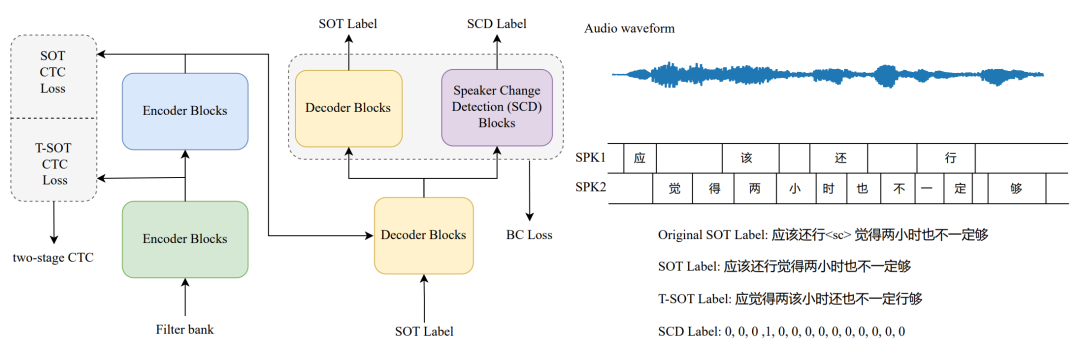
图3: 左侧的结构图展示了提出BA-SOT方案。右侧部分展示了一个例子,包含训练过程中使用的不同标签以及两个说话人的相应音频序列。
说话人切换预测模块
SOT在句子之间插入 来预测不同说话人的切换点。预测
 需要说话人信息,而说话人信息对ASR任务来说是无用的。为了解决这个问题,我们增加了一个说话人切换预测模块进行多任务学习,即使用两个输出层分别实现语音识别和说话人切换预测。ASR任务的标签去除了
 ,只识别语音内容。说话人切换预测任务则预测句子的边界。这使得ASR解码器模块可以专注于上下文信息。而说话人切换预测模块可以单独捕捉说话人信息。
边界约束损失
为了提升ASR和说话人切换的准确度,我们提出了一个应用于交叉注意力模块上的边界约束损失。对于ASR任务,边界约束损失利用每句话的已知边界信息来指导交叉注意力集中在正确的时间范围内。如图4左侧所示,对于不重叠的语音,注意力热力图显示为一条从左上角到右下角的直线。然而对于重叠的语音,如图4右侧所示,注意线被分成几段,断点表示说话人发生变化的位置。因此注意力热力图中的断点为说话人切换预测任务提供了宝贵的信息。这些断点可以作为说话人的信息通过鼓励说话人的注意力学习到正确的边界,从而提高说话人切换预测任务的准确度。
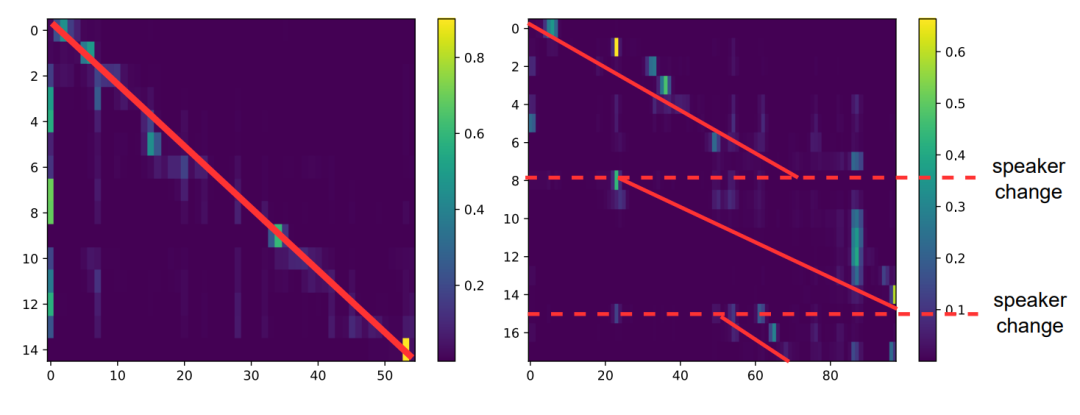
图4 注意力图显示了在非重叠和重叠的情况下,注意力得分的预期趋势,红线代表预期的趋势。
我们研究了两种不同的边界约束损失,举例来说,一个由N个句子组成的SOT标签,删除“说话人切换”标记后可以表示为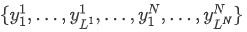 ,其中
 代表第
 句话的第
 个字符,
 代表第
 句话里的字符总数。
在不使用真实的时间戳信息情况下,可以发现以下规律:当 标记出现的时候,前一句话的最后一个字发音往往晚于当前句子的第一个字。由于缺乏真实的时间戳信息,我们可以使用交叉注意力得分中的时间戳作为替代。假设将预测的时间戳表示为
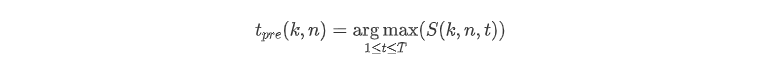
 表示
 在第
 个时间帧的分数。不使用真实时间戳信息的边界约束损失则可以表示为:
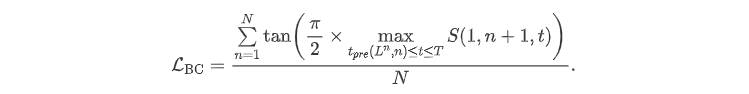
由于上面提出的边界约束损失依赖于注意力分数对时间戳的预测,存在错误累积从而影响到模型性能。为了解决这个问题,我们引入了真实的时间戳来提高边界约束损失的准确性。如果有了真实时间戳,就可以确定下来每句话的边界并将注意力引导到正确的时间范围。在这种情况下,边界约束损失可以被定义为:
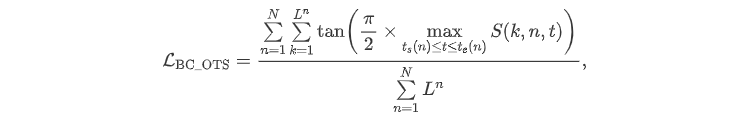
 和
 表示第
 句话的开始和结束时间。
两阶段CTC
基于t-SOT的时间单调性,我们提出了一个两阶段的CTC策略[8],我们将编码器分为两部分,编码器前几层使用t-SOT CTC损失按时间顺序提取声学特征。因为预测说话人切换是多余的,所以在这个CTC损失中我们删除了分隔符。其余的编码器层起到类似于重排序的作用,它们将声学特征的顺序从t-SOT转换为SOT格式,捕捉说话人的知识,将来自于同一个说话人的特征聚集在一起。在这种方法中,t-SOT被视为SOT的中间状态,以减轻直接建模SOT的难度。
训练策略
标签描述我们提出的方法以SOT为基础,将多个含有说话人交叠的句子序列化为一个序列,并在句子之间插入一个分隔符。在实验中,我们采用了句子的先入先出方法,该方法根据句子的开始时间,按时间顺序重新排列句子。t-SOT提供中间编码的标签。标签根据每个字符的发射时间进行排序,并用分隔符相连接。SOT和t-SOT的例子都显示在图3的右侧。
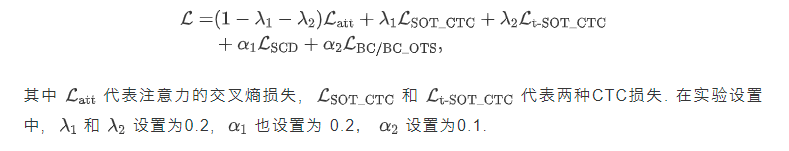
损失函数当在说话人预测模块上应用了边界约束损失之后,我们的模型使用多任务目标进行联合优化。标准的CTC/注意力联合损失被修改如下:
实验数据我们使用AliMeeting数据集来评估提出的方法,AliMeeting[9]是一个会议环境下的多人对话数据集,它总共包含118.75小时的语音数据,分为104.75小时用于训练(Train),4小时用于评估(Eval),以及10小时用于测试(Test)。AliMeeting数据集包含远场重叠音频( ),以及相应的近场音频(
 )。在
 上应用CDDMA Beamformer得到了
 。为了评估在单人谈话情况下的性能,我们使用了
 和
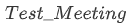 。
 是与WenetSpeech数据集相匹配的测试集,
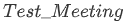 是从197场录制于不同会议室的真实会议中抽取出来的另一个会议场景数据集。
模型结构我们所有的实验均基于ESPnet[10]实现。我们以80维的Mel-filter bank作为声学特征,帧长为16ms,帧移为8ms。在没有模型初始化的情况下训练的SOT基线包含一个12层的编码器和一个8层的解码器以及4头的MHSA,以确保与带有说话人切换检测模块的SOT相似的参数。MHSA和FFN层的尺寸设定为256和2048。我们利用了2个Transformer层作为说话人切换检测模块,其配置与解码器层相同。至于两阶段CTC,我们采用了9个编码器层,以t-SOT的顺序提取声学特征,然后用3个编码器层来完成重新排序。由于 数据集中没有说话人切换,这会加剧类别不平衡的问题并对我们模型的准确性产生不利影响。因此在完成模型训练后,我们只使用远场数据集对说话人切换检测模块进行微调。
评估指标 在一个多说话人语音识别系统中,识别出的句数可能标签中的句数不同,这表明说话人切换预测不准确。为了解决这个问题,我们引入了句相关CER(UD-CER),即按分隔符将识别结果分为多句话,并重新排列以获得最低的CER。UD-CER的计算方法与最优参考组合(ORC)WER的计算方法类似,它可以被看作是N个通道的ORC WER的一个变种,其中N代表句子的数量。UD-CER和原始SOT中使用的WER定义之间有一些区别。虽然这两个指标都是对句子进行处理,但SOT中的WER是将所有句子拼接起来,然后计算一次CER。值得注意的是,UD-CER对预测说话人变化的错误特别敏感。除了UD-CER,我们还利用了字符错误率(CER)指标,该指标的计算方式与M2MeT挑战赛中的计算方法相同。
表1 本文方法在多个测试集上的CER/UD-CER。由于分隔符 造成的字典差异,SOT基线与模型初始化时随机初始化了输出层部分。所有的模型都是在没有语言模型的情况下进行解码的,在解码过程中CTC的权重被设置为0.6。波束搜索的大小被设置为20。
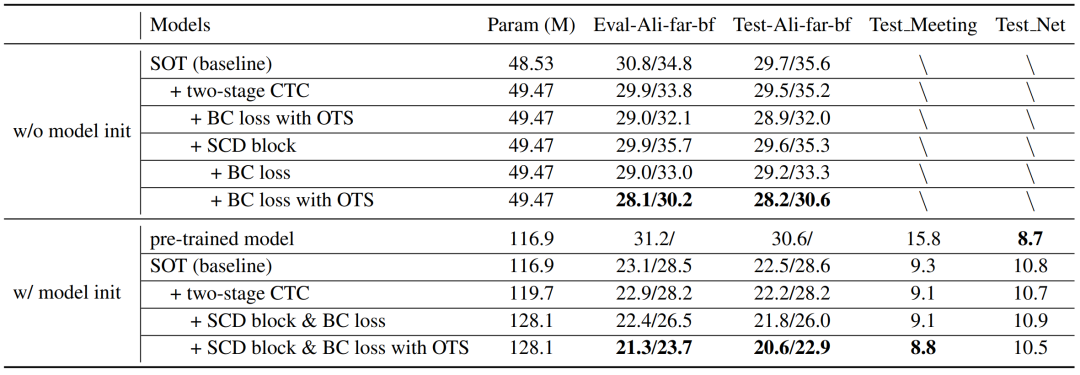
不使用初始化模型结果如表1所示,我们比较了我们提出的方法和SOT基线模型的效果,后者是在
使用初始化模型结果由于模型参数的随机初始化,没有真实时间戳的边界约束损失往往会向错误的方向上进行优化,因此我们使用预训练的模型来提供一个理想的初始化。我们用
注意力矩阵分析图5展示了SOT和BA-SOT模型的注意力热力图。图的左边部分展示了SOT的注意力在相应语词的实际时间边界上是混乱的。相比之下,右边部分显示的BA-SOT的注意图更加集中和清晰。这一改进是通过使用边界约束损失来实现的,它不仅加快了模型的收敛速度,而且还提高了标签边界的注意力准确性。
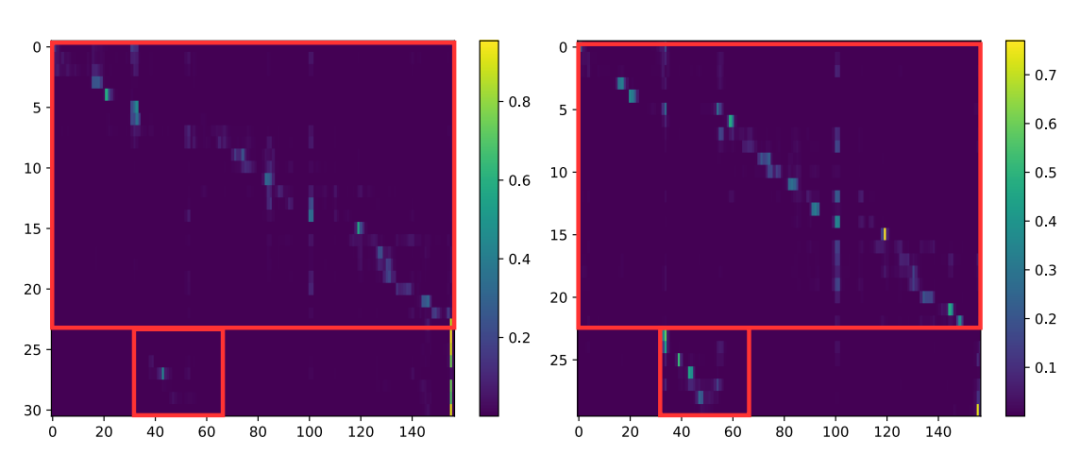
图5 AliMeeting数据集中某片段的注意力热力图。红色方块表示每句话的时间范围。
说话人转换点预测分析一段语音的解码结果如图6所示。SOT的识别结果漏掉了一个分隔符,导致UD-CER的飙升,而BA-SOT可以对说话人变化的更好预测。在这个例子中,BA-SOT的结果表明当以较高的精度预测说话人变化位置时,UD-CER可以与CER相等。表1和图6中CER和UD-CER的趋势相似,UD-CER比CER有更明显的改进。这表明我们提出的方法可以更准确地预测说话人切换的位置。
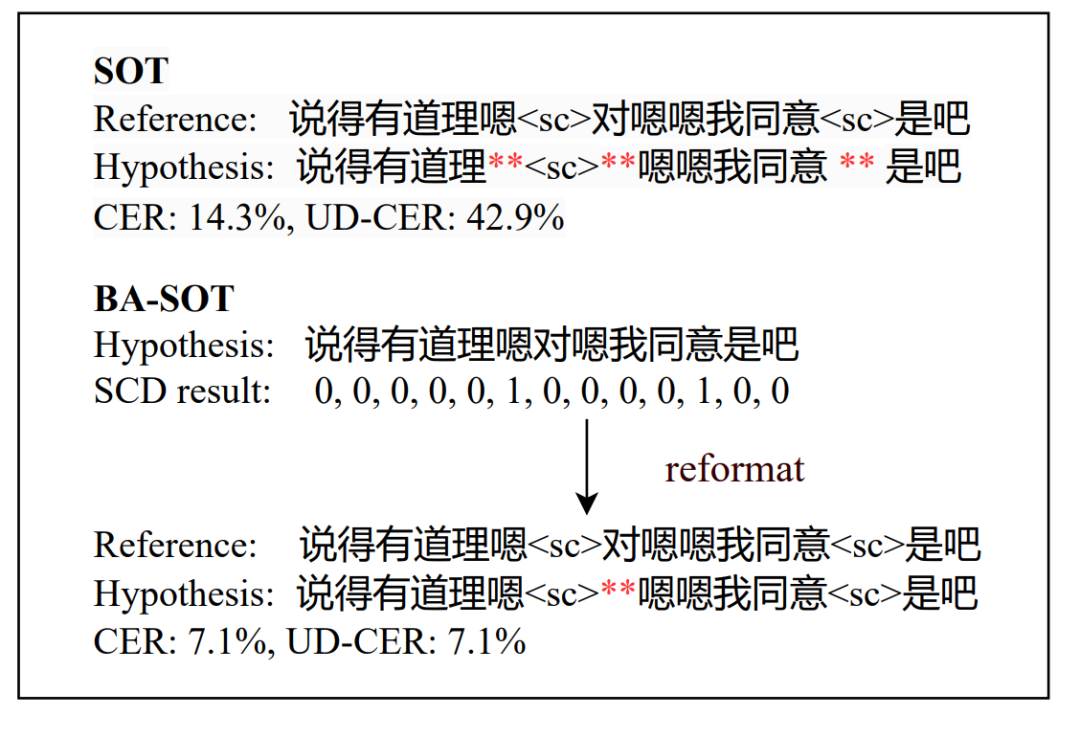
图6 一个解码结果的例子。红色的***表示删除或插入错误。BA-SOT的输出被重新转换为SOT格式,然后计算CER和UD-CER。
参考文献
[1] Yu, S. Zhang, P. Guo, Y. Fu, Z. Du, S. Zheng, L. Xie, Z.-H. Tan, D. Wang, Y. Qian, K. A. Lee, Z. Yan, B. Ma, X. Xu, H. Bu, "Summary on the ICASSP 2022 multi-channel multi-party meeting transcription grand challenge," in Proc. ICASSP. IEEE, 2022.
[2] H. Chen, H. Zhou, J. Du, C.-H. Lee, J. Chen, S. Watanabe, S. M. Siniscalchi, O. Scharenborg, D.-Y. Liu, B.-C. Yin, J. Pan, J.-Q. Gao, and C. Liu, "The first multimodal information based speech processing (MISP) challenge: Data, tasks, baselines and results," in Proc. ICASSP. IEEE, 2022, pp. 9266–9270.
[3] D. Yu, M. Kolbæk, Z. Tan, and J. Jensen, "Permutation invariant training of deep models for speaker-independent multi-talker speech separation," in Proc. ICASSP. IEEE, 2017, pp. 241–245.
[4] D. Yu, X. Chang, and Y. Qian, "Recognizing multi-talker speech with permutation invariant training," in Proc. Interspeech. ISCA, 2017, pp. 2456–2460.
[5] J. Shi, J. Xu, Y. Fujita, S. Watanabe, and B. Xu, "Speakerconditional chain model for speech separation and extraction," in Proc. Interspeech. ISCA, 2020, pp. 2707–2711.
[6] N. Kanda, Y. Gaur, X. Wang, Z. Meng, and T. Yoshioka, "Serialized output training for end-to-end overlapped speech recognition," in Proc. Interspeech. ISCA, 2020, pp. 2797–280
[7] N. Kanda, J. Wu, Y. Wu, X. Xiao, Z. Meng, X. Wang, Y. Gaur, Z. Chen, J. Li, and T. Yoshioka, "Streaming multi-talker ASR with token-level serialized output training," in Proc. Interspeech. ISCA, 2022, pp. 3774–3778.
[8] B. Yan, S. Dalmia, Y. Higuchi, G. Neubig, F. Metze, A. W. Black, and S. Watanabe, "CTC alignments improve autoregressive translation," in arXiv preprint arXiv:2210.05200, 2022.
[9] F. Yu, S. Zhang, Y. Fu, L. Xie, S. Zheng, Z. Du, W. Huang, P. Guo, Z. Yan, B. Ma, X. Xu and H. Bu, "M2MeT: The ICASSP 2022 Multi-Channel Multi-Party Meeting Transcription Challenge," in Proc. ICASSP. IEEE, 2022.
[10] S. Watanabe, T. Hori, S. Karita, T. Hayashi, J. Nishitoba, Y. Unno, N. Enrique Yalta Soplin, J. Heymann, M. Wiesner, N. Chen, A. Renduchintala, and T. Ochiai, "ESPnet: End-to-end speech processing toolkit," in Proc. Interspeech, 2018, pp. 2207–2211.
