
 西工大音频语音与语言处理研究组
文章来源于音频语音与语言处理研究组,作者刘广厚
发表论文截图
1. 背景动机
语音合成是指从文本生成自然语音的技术。近些年,语音合成在深度学习的推动下发展迅速[1],已经可以合成高自然度高质量的语音。人类语音是极富表现力的,讲话风格多种多样。然而在实际应用中,考虑到录制数据的成本,通常只有少量的发音人具有高质量的表现力数据。为了为任意说话人合成表现力语音,需要把给定的说话风格迁移到不包含该风格的目标说话人上,即风格迁移(style transfer)技术。目前主流的风格迁移方式有两类。一类是以有监督的方式使用显示风格分类索引来控制风格[2],但合成语音的多样性不够丰富,也不够可控,只能合成预先定义的几种风格。另一类是从参考音频提取风格表征用来指导语音的生成[3],这种方法虽然能够合成表现力丰富多样的音频,但是提取的风格信息不够直观和可解释,每次合成都需要挑选一个参考音频,在实际应用中较为不便。
针对上述问题,本文探索了用自然语言描述进行可控风格迁移的可能性,提出了一种基于文本描述引导的跨说话人风格迁移方案PromptStyle。PromptStyle基于VITS[4]的结构进行构建,并引入跨模态风格编码器实现风格迁移。跨模态风格编码器构建了一个声学特征和语义的共享空间,来在保持较高的发音稳定性和说话人相似度的同时,实现了基于文本描述引导的风格迁移。
2. 提出的方案
PromptStyle模型结构如图1所示,由风格编码器、提示编码器和基于VITS的语音合成系统三部分组成。基于VITS的端到端语音合成模型,直接将音素序列转换为语音波形。VITS[4]可以产生高质量的语音,这归功于它的端到端学习方式,而不存在传统范式中声学模型和声码器之间可能的不匹配。风格编码器用于从参考语音中提取风格信息,而提示编码器则用于从自然语言描述中提取语义信息。
基于VITS框架,我们提出了一个两阶段训练流程以实现基于自然语言描述的风格转换。在第一阶段,我们使用多说话人多风格数据来训练一个基于带有风格编码器的VITS的风格转换系统,来让模型学习一个风格嵌入空间。在第二阶段,我们使用带有自然语言描述(提示)的表现力语音来微调整个模型,以构建语义嵌入空间和风格嵌入空间之间的关系,从而实现带有文本提示的风格转换。
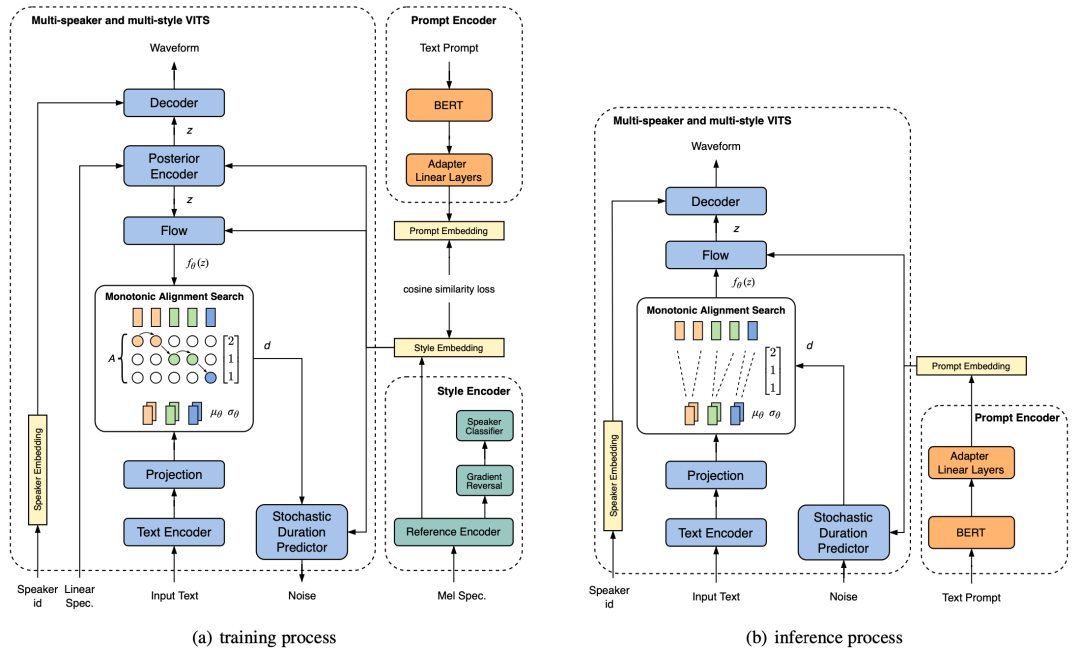
图1 PromptStyle模型结构
跨模态风格编码器
跨模态风格编码器由一个风格编码器和一个提示编码器组成,用于构建风格和语音表示的共享空间。
风格编码器从梅尔频谱中提取风格信息,不选择线性频谱是因为线性频谱包含了太多的信息,影响风格信息的准确提取。风格编码器由一个参考编码器和一个说话人对抗模块组成。参考编码器与GST[5]中的结构相似,说话人对抗模块由梯度反转层、前馈层和说话人分类器组成,用于分离说话人和风格信息。
提示编码器被用来构建一个文本提示嵌入空间,以便使用自然语言描述进行可控的风格转换。提示编码器由一个预先训练好的BERT模型和一个适配线性层组成。首先,文本提示被送入BERT[6]模型以提取语义特征。然后,适配线性层将语义特征转换为与风格编码器提取的风格嵌入匹配的文本提示嵌入,并构建文本提示嵌入和风格嵌入空间之间的关系。
两阶段训练流程
本文引入了一种两阶段的训练流程来构建风格和提示空间之间的关系,以实现基于参考语音或文本描述的风格转换,同时带有风格标注数据的类型和规模可以根据实情况灵活变动,并且微调的过程所需时间较短。
第一阶段训练了基于参考音频的风格转换系统。本文研究了VITS中各个模块在风格转换任务中的作用。文本编码器处理输入音素,与说话人和风格信息无关。本文认为发音时长是风格的一个重要表现,所以只将风格嵌入输入到随机时长预测器中。归一化流模块用于丰富先验分布中包含的信息,考虑到在构建先验分布时很难同时考虑到说话人和风格嵌入,只将风格嵌入输入归一化流模块中。后验编码器从线性谱图中得到正态后验分布,并由解码器重构谱图。参考DelightfulTTS[7],增加了SSIM损失,说话人对抗模块使用梯度反转的交叉熵损失训练。第一阶段训练的损失函数如下。
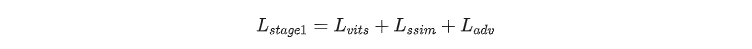
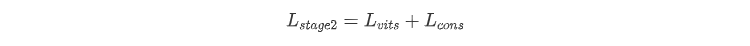
3. 实验
实验数据:内部中文数据集,包含2小时的有声书音频和共12小时的8个女性说话人表现力语音。
对比系统
CST-TTS:参考[8]搭建的一个基于非自回归结构的跨说话人风格转换框架,可以通过风格标签控制合成语音表现力。
GST-MLTTS:一个基于半监督训练和SCLN的跨说话人情感转移模型[9]。
PromptStyle:本文方案。
主观测试
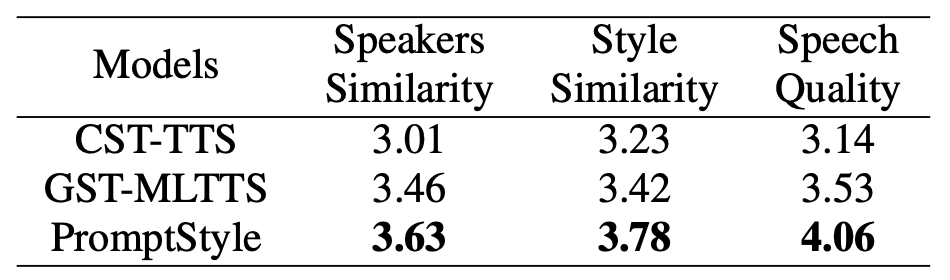
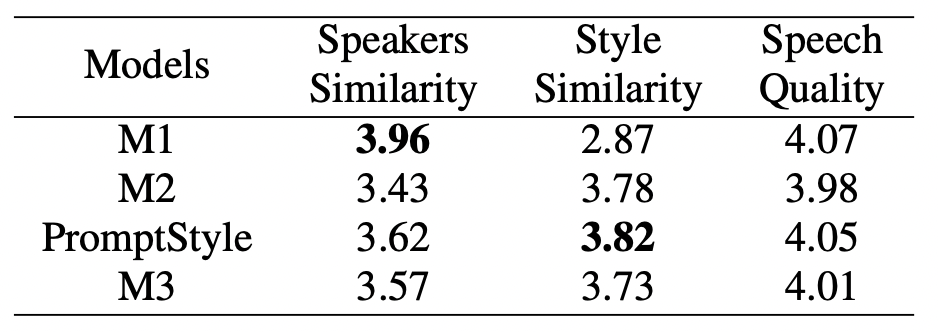
如表1所示,PromptStyle在合成语音质量、说话人相似度和风格相似度方面的表现都要更好,证明了端到端结构的优势以及风格与说话人嵌入添加到不同模块的有效性。
表1 相似度和音频质量MOS结果
客观测试
通过t-SNE实现风格嵌入空间的可视化,对训练数据中的常见风格进行评估。使用PromptStyle、CST-TTS和GST-MLTTS分别提取风格嵌入,颜色相同的点来自同一风格类别。两点之间的距离表示风格嵌入的相对相似度。较小的距离表示更相似的风格嵌入。理想的风格编码器应该使来自同一类别的风格嵌入彼此更接近,而来自不同类别的更加分散。如图2所示,PromptStyle在风格嵌入方面呈现出明显的优越性。
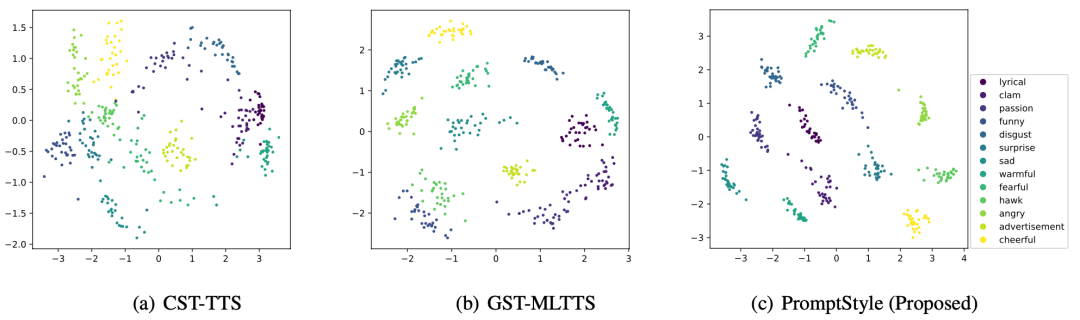
图2 不同模型的风格嵌入可视化
消融实验
消融实验旨在验证风格嵌入和说话人嵌入添加到不同模块的影响,主要考虑后验编码器、归一化流和解码器三个模块。模型设置如表2所示,实验结果如表3所示,PromptStyle在较好的保留目标说话人音色的同时,合成语音的风格表现力最强。
表2 消融实验设置
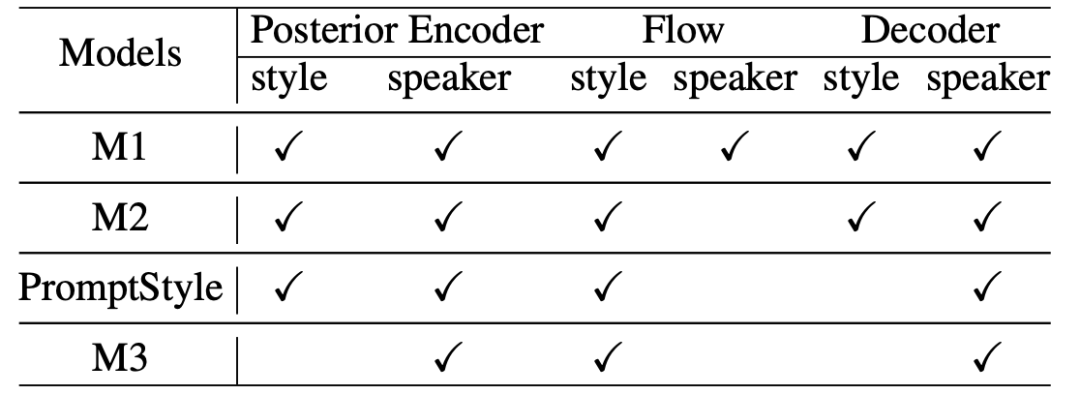
表3 消融实验相似度和音频质量MOS结果
基于文本提示的风格控制
PromptStyle可以使用参考音频或文本提示来进行风格转换。由于参考音频比文本提示包含更直接的风格信息,本文将使用参考音频做为topline。分别从参考音频和文本提示中提取风格嵌入和提示嵌入,在语音质量、说话人相似度和风格相似度三个方面进行ABX偏好测试。测听人员从提供的一对音频样本中选择哪一个具有与所提供的自然语言描述相符的表现力。如图3所示,大多数测听人员选择 No preference,即基于自然语言的风格迁移效果与基于参考音频的风格迁移效果相当,这表示PromptStyle实现了文本提示引导的风格迁移,可以合成高质量的语音并具备准确的风格控制能力。
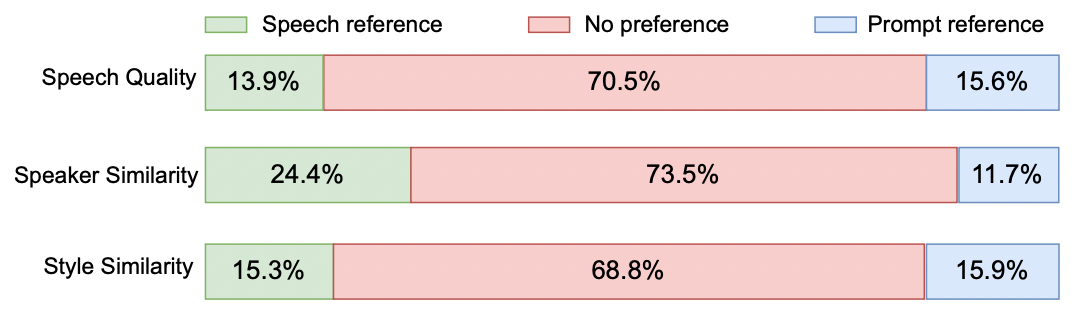
图3 ABX偏好测试结果
