以下文章来源于音频语音与语言处理研究组,作者王晴
说话人识别(Speaker Identification, SID)是一个确定说话人身份的生物识别技术。在实际应用中,确保说话人识别系统的安全性是至关重要的。说话人识别系统通常面临各种攻击,如欺骗攻击(Spoofing Attacks)和对抗攻击(Adversarial Attacks)等。对抗攻击一种是利用机器学习模型的漏洞来欺骗该模型的恶意攻击,已经成为了一种对说话人识别系统准确性和可靠性的重大威胁。为了更好的了解对抗攻击对说话人模型的影响,我们提出了一种用于说话人识别的音色保留的对抗攻击方法。近期,西工大音频语音与语言处理研究组(ASLP@NPU)论文"Pseudo-Siamese Network based Timbre-reserved Black-box Adversarial Attack in Speaker Identification" 被语音研究顶级会议INTERSPEECH2023接收。该论文提出了一种用于说话人识别的音色保留的对抗攻击方法,不仅可以利用声纹模型的弱点,还可以在黑盒攻击条件下保留目标说话人的音色。具体来说,我们通过在语音转换模型的训练过程中添加一个对抗性约束条件来生成保留目标说话人音色的假音频。我们利用一个伪孪生网络结构从黑盒声纹模型中学习,同时约束内在相似性和结构相似性。内在相似性损失是为了学习模型内在的不变性,而结构相似性损失是为了确保替代的声纹模型与固定的黑盒声纹模型共享相似的决策边界,训练好的替代模型用来生成保留音色的假音频进行攻击。在Audio Deepfake Detection Challenge 2022(ADD 2022)数据集上的实验结果表明,我们提出的方法在白盒和黑盒场景下的攻击成功率分别高达60.58%和55.38%,并且可以同时欺骗人类和机器。现对该论文进行简要的解读和分享。论文题目:Pseudo-Siamese Network based Timbre-reserved Black-box Adversarial Attack in Speaker Identification
论文网址:http://arxiv.org/abs/2305.19020
图1:发表论文截图
图2:扫码直接看论文
说话人识别系统 [1] 通常面临各种攻击,如欺骗攻击(Spoofing Attacks)[2] 和对抗攻击(Adversarial Attacks)[3] 等。欺骗攻击通常包括仿冒、重放、语音转换和语音合成等。对抗攻击是利用模型的漏洞来欺骗该模型的恶意攻击。受上述欺骗攻击和对抗攻击的启发,生成高质量的假音频以有效攻击说话人识别模型需要同时欺骗机器和人类的能力。为了欺骗机器,我们需要考虑下游的说话人识别任务,并确保假音频具有独特的说话者属性,使SID模型给出所需的决定。从人类感知的角度来看,如果假音频里的说话人音色或嵌入的语言信息与目标说话人的真实音频有明显不同,则很容易被发现。因此,在对说话人模型进行攻击时,也需要考虑音色和语言信息。本文提出了一种针对说话人识别系统的新型的音色保留对抗攻击方法,通过利用说话人模型的弱点,同时在黑盒攻击设置中保留目标说话人的音色。为此,我们在语音转换(Voice Conversion, VC)模型 [4] 的训练过程中加入了对抗约束,从而生成了保留音色的假音频。然后,我们利用伪连通网络架构从黑盒说话人识别模型中学习,同时约束内在相似性和结构相似性。内在相似性损失旨在实现内在不变性,而结构相似性损失则确保替代说话人分类器与固定黑盒说话人分类器具有相似的决策边界。通过使用替代说话人分类器作为代替模型,我们可以为黑盒分类器生成保留音色的假音频。在Aishell-3数据集 [5]上的实验结果表明,替代说话人分类器接近于黑盒说话人分类器。同时,在Audio Deepfake Detection 2022(ADD2022)[6] 挑战赛数据集上的实验结果表明,基于我们提出的方法生成的假音频在保留了原始音色的情况下,可以成功地欺骗人类和机器,并获得较高的攻击成功率。保留音色的对抗攻击
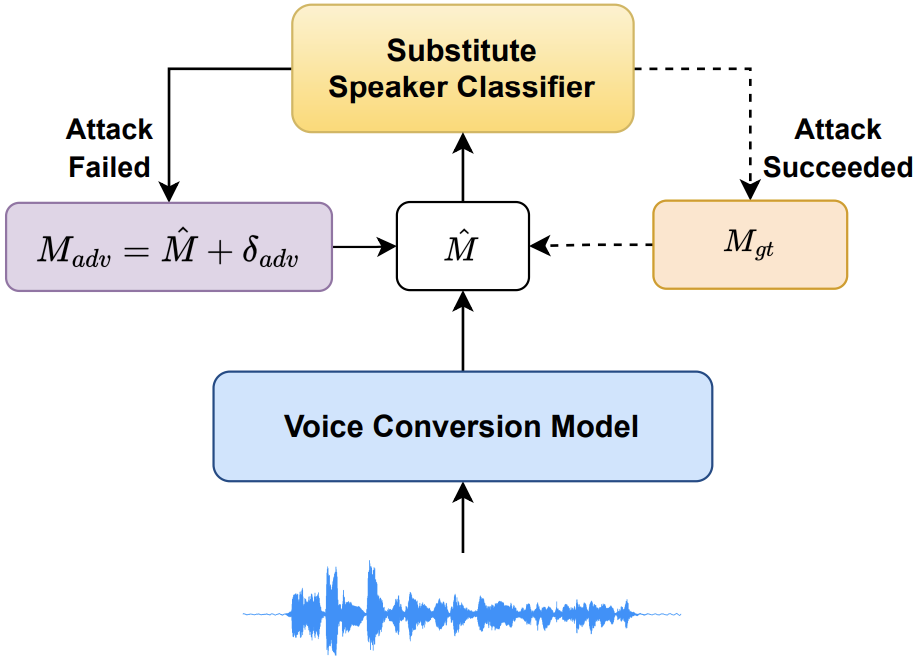
图3展示了我们提出的音色保留对抗攻击的基本原理,其中包括一个基于非自回归的语音转换模型和一个对抗攻击约束过程。我们在对抗约束过程中使用一个训练好的说话人识别模型 。梅尔谱
 是输入,代表语音转换模型预测的表示,其对应的说话人识别模型预测的说话人标签为
 ,而语音转换模型目标说话人标签为
 。对抗约束
 可定义如下:
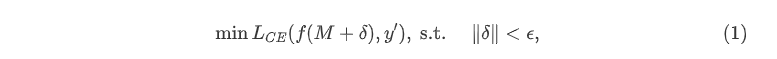
这里, 是损失函数,
 是超参数。每次迭代,
 的更新如下:
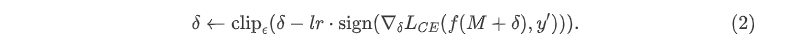
图3:音色保留对抗攻击概览
在语音转换模型训练过程中加入对抗约束,以保留目标说话人信息。在使用对抗约束进行联合训练时,我们使用语音转换模型预测的梅尔谱来攻击说话人分类器。如果攻击失败,我们会在预测的 Mel 频谱图上添加一个微小的对抗扰动,生成对抗梅尔谱 ,其定义为:
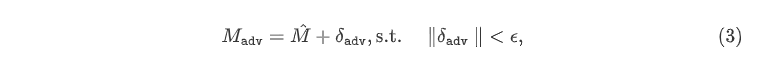
这里, 表示微小对抗扰动,
 用于控制产生的最大对抗扰动。这个微小对抗扰动可以通过以下方法优化:
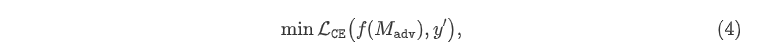
其中 的目的是让
 欺骗训练有素的说话人识别系统,使其预测出指定的目标标签。因此,带有对抗约束的联合训练可以通过以下损失函数进行优化:
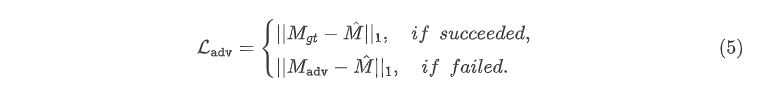
当 ,换句话说,攻击失败时,我们在梅尔谱图中添加一个对抗扰动作为对抗约束。为了迫使语音转换模型预测的梅尔谱
 能够被归类到目标说话人,我们期望使预测的梅尔谱
 与带有对抗扰动的梅尔谱
 之间的L1损失最小,从而使语音转换模型能够骗过训练好的说话人识别系统。对抗扰动
 通过等式2进行优化,直到预测标签
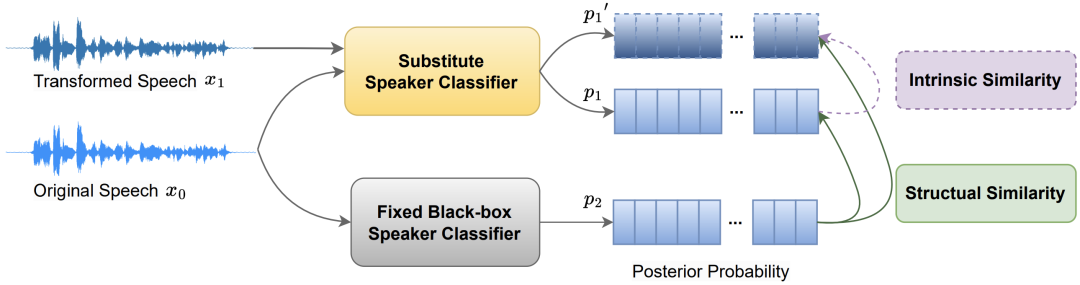
 成为目标标签。相反,当说话人分类器预测出目标说话人标签,即攻击成功时,语音转换模型仅使用原始重建损失进行优化。在更实际的情况下,我们事先并不了解黑盒设置的说话人分类器的结构或参数。因此,我们会训练一个替代的说话人分类器来进行黑盒对抗攻击。图4是基于伪孪生网络的架构概览,该结构可以从黑盒说话人分类器中学习内在相似性和结构相似性。其中,内在相似性可以学习内在不变性,而结构相似性则保证了替代说话人分类器与固定黑盒分类器具有相似的决策边界。由于事先不知道目标说话人系统的结构或参数,我们只能访问黑盒说话人分类器的输入和输出,而无法访问其内部处理过程。通过比较原始语音和转换后的语音,可以最小化内在相似性损失,目的是帮助替代说话人分类器在标签紊乱的情况下进行学习。我们希望同一说话人的后验概率在转换前后保持一致。具体来说,对于给定的语音样本
 ,通过添加高斯噪声进行转换,得到转换后的语音样本
 ,从而增加了数据分布的多样性。通过比较
 和
 的输出概率来计算内在相似性损失:
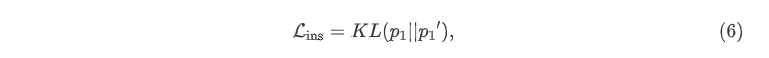
其中, 是内在相似性损失,
 和
 是替代说话人分类器输出的
 和
 的后验概率,而
 是库尔贝克-莱布勒(KL)散度。结构相似性损失是通过比较来自替代和黑盒说话人分类器的语音样本的后验概率分布来计算的。具体来说,对于给定的语音样本
 和转换后的语音样本
 ,其结构相似性损失定义如下:
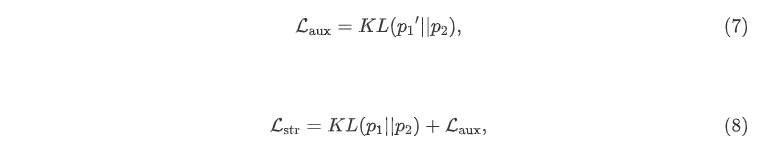
其中, 是结构相似性损失,
 是辅助相似性损失,
 是来自黑盒说话人分类器的原始语音
 的后验概率。最终的训练目标函数定义如下:
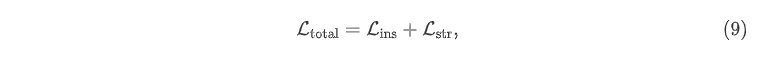
其中, 是总损失,用于限制结构相似性和内在相似性。我们之所以使用伪孪生网络结构,是因为它能有效捕捉不同分类器对相同语音样本的不同输出之间的相似性。总之,替代说话人分类器的训练过程旨在学习一个在预测说话人身份方面与黑盒说话人分类器表现类似的模型,同时还能抵御对抗性攻击。替代说话人分类器训练完成后,攻击损失按照上面介绍的方法计算。
图4:基于伪孪生网络的替代说话人分类器概览
保留音色的假音频的生成
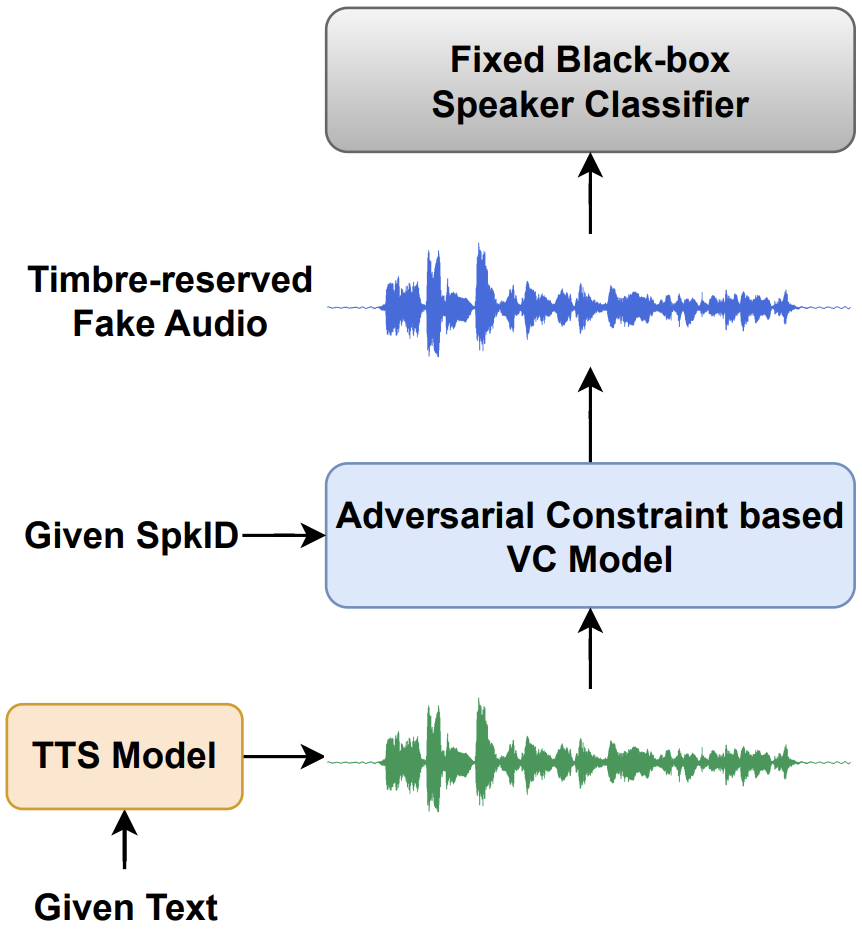
带有对抗约束的语音转换模型训练完成后,音色保留黑盒假音频的生成过程如图5所示。首先,在给定文本的情况下,我们使用基于 FastSpeech2 的语音合成系统为随机说话人生成音频。我们对语音合成模型的编码器和解码器结构进行了修改,以纳入 DelightfulTTS 2中的conformer块。然后,说话人标签和语音合成生成的音频被用作对抗约束语音转换模型的输入,以预测攻击梅尔谱。最后,使用 HifiGAN 声码器从梅尔谱中重建波形,生成音色保留的假音频,用于对固定黑盒说话人识别模型的对抗攻击。我们使用AISHELL-3 [5] 来训练伪孪生网络、说话人识别模型和语音转换模型。AISHELL-3是一个多人普通话音频语料库,包含来自218个母语使用者的88,035段录音。AISHELL-1测试集用于评估说话人识别模型的性能。为了评估我们所提出的针对音色保留对抗攻击的方法,我们采用了音频深度伪造检测(ADD2022)挑战赛的数据集 [6],这是一个专为深度伪造音频攻击和检测而设计的开源数据集。然后,我们在ADD挑战赛Track 3.1的测试集上评估我们提出的方法,该测试集由10个说话者ID和500个文本组成,用于生成假音频。我们生成的攻击样本需要满足一定的可懂度和相似度标准,同时还能骗过SID模型。通过使用ADD挑战数据集,我们开发了一种解决方案来应对对抗性攻击,同时保持音色并允许自定义文本。语音合成模型:使用类似于 DelightfulTTS 2 的 6 层conformer编码器-解码器结构,根据给定文本和一个随机说话人的音色生成音频。语音转换模型:一个预训练的语音识别模型用于提取与说话者无关的语言信息。采用非自回归语音转换模型,使用 8 层transformer编码器-解码器结构,类似于 FastSpeech2 和 HifiGAN 声码器的多波段处理。添加了说话人分类器,以对生成的独特说话人信息进行对抗约束。说话人识别模型:使用的 ECAPA-TDNN黑盒 SID 模型也被用作语音转换中的说话人分类器。在 AISHELL-1 测试集上的 EER 为 1.91%。包含 3 个 SE-Res2Block 模块,通道大小和瓶颈维度分别设置为 1024 和 256。AAM-softmax损失函数,margin为0.2,scale为30。替代说话人分类器由六个conformer块堆叠排列而成,之后是一个统计池化层,类似于 x-vector。梅尔谱对抗约束实验:上述学习率公式中的语音转换模型学习率设置为 8e-4,每个mini-batch更新 1000 次。用
 准则来衡量扰动边界。
 从 0.8 开始。添加了替代说话人分类器,以对生成的独特说话人信息进行对抗约束。
替代 SID 模型的性能
表 1 列出了替代说话人分类器与真实说话人标签和黑盒说话人分类器预测结果的比较结果,以此评估替代说话人分类器的性能。我们可以看到,91.44% 的替代分类器和黑盒分类器的预测结果相同,而与真实说话人标签相比,替代分类器的准确率为 90.16%。这表明替代说话人识别模型接近黑盒说话人识别模型。表1:替代说话人分类器预测与真实说话人标签和黑盒预测的准确率(%)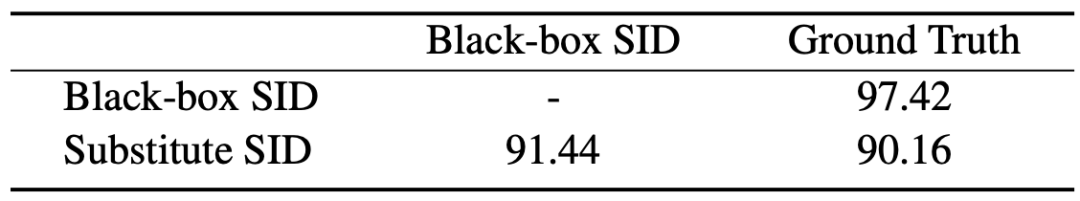
攻击成功率
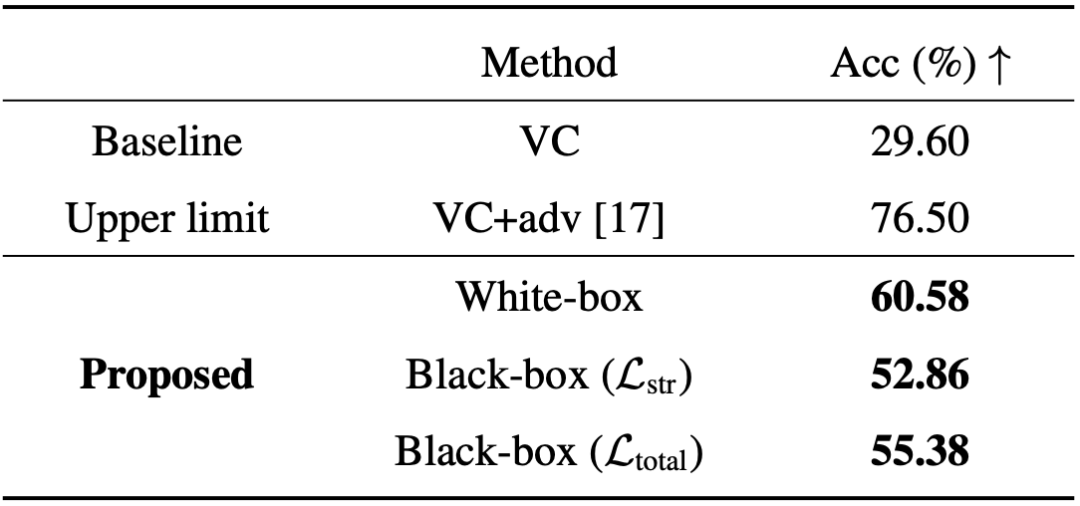
攻击成功率在表2中表示为 "Acc",用于衡量目标攻击在说话人识别中的性能。它表示根据 SID 预测的准确率,计算方法是将成功攻击的音频数量除以生成的假音频总数。Acc 值越高,表示攻击效果越好。比较中使用的第一种方法仅由原始语音转换模型生成,它是所有其他方法的基准,在表2中表示为 "VC"。第二种方法是使用 [7] 中提出的方法,在由语音转换模型生成的假音频中直接添加对抗性扰动。由于扰动是由 SID 系统优化并直接添加到波形中的,因此人类仍然可以感知。这种方法在同时欺骗人类和机器的情况下是次优的,但代表了对抗性攻击的上限,在表2中表示为 "VC+adv"。其余三种方法是基于多类型对抗约束训练的语音转换模型,如方法部分所述,分别称为 "White-box"、"Black-box( )"和 "Black-box(
 )"。如表2所示,基于语音转换模型的虚假音频的攻击成功率为29.60%,而直接对抗扰动的语音转换音频 [7] 攻击成功率达到了76.50%。同时,我们提出的音色保留策略的 Acc 结果分别为 60.58%、52.86% 和 55.38%。我们可以观察到,与原始语音转换模型生成的假音频相比,基于这三种我们提出的音色保留对抗策略生成的假音频的攻击成功率得到了显著提升,分别是30.98%、23.26%和25.78%。此外,我们提出的方法与通过对原始语音转换模型生成的假音频进行直接对抗性扰动获得的结果不相上下。
表2:各种生成方法的攻击成功率(%)
消融实验
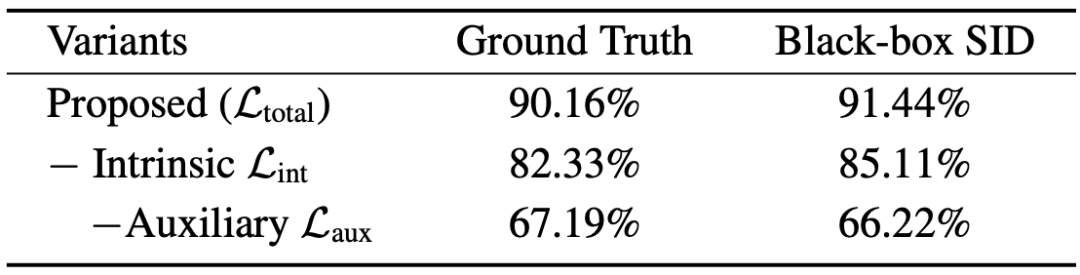
为了进一步研究伪孪生框架中每个分量的有效性,我们对损失函数中的不同分量进行了消融研究。如表3所示,替代说话人分类器预测的准确性是通过与真实说话人标签和黑盒说话人分类器预测进行比较来评估的。在消融研究中,我们首先剔除了内在相似性损失"",只保留了结构相似性"",性能下降到了82.33%和85.11%。然后,当继续去除辅助相似性损失""时,性能下降到 67.19%和 66.22%。这两种移除的损失都是在转换后语音的后验概率与替代和黑盒说话人分类器的后验概率之间计算得出的,这证明了我们提出的损失函数和数据增强方法的有效性。表3:损失函数中不同成分的消融实验(%)
生成音频质量评估
我们采用 MOSNet [8] 预测的客观平均意见得分(o-MOS)来衡量不同方法生成的伪音频的质量,如图6所示。值得注意的是,通过我们提出的策略生成的几种假音频的 o-MOS 结果始终优于直接添加对抗扰动生成的音频。这表明通过我们提出的策略生成的假音频质量更高,因为我们将对抗约束整合到了语音转换模型的训练过程中,从而避免了在假音频中直接引入额外的人类可感知的扰动。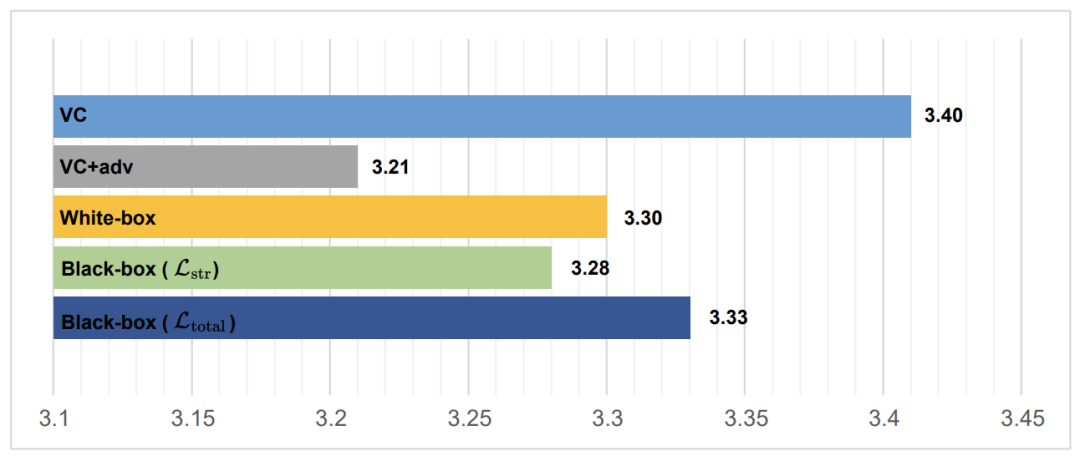
图6:不同生成方法的假音频的 o-MOS
参考文献
[1] J. H. Hansen and T. Hasan, “Speaker recognition by machines and humans: A tutorial review,” IEEE Signal Processing Magazine, vol. 32, no. 6, pp. 74–99, 2015.
[2] Z. Wu, E. S. Chng, and H. Li, “Detecting converted speech and natural speech for anti-spoofing attack in speaker recognition,” in Proc. ISCA, 2012.
[3] C. Szegedy, W. Zaremba, I. Sutskever, J. Bruna, D. Erhan, I. Goodfellow, and R. Fergus, “Intriguing properties of neural networks,” arXiv preprint arXiv:1312.6199, 2013.
[4] Y. Ren, C. Hu, X. Tan, T. Qin, S. Zhao, Z. Zhao, and T. Liu, “Fastspeech 2: Fast and high-quality end-to-end text to speech,” in Proc ICLR, 2021.
[5] Y. Shi, H. Bu, X. Xu, S. Zhang, and M. Li, “Aishell-3: A multispeaker mandarin TTS corpus and the baselines,” arXiv preprint arXiv:2010.11567, 2020.
[6] J. Yi, R. Fu, J. Tao, S. Nie, H. Ma, C. Wang, T. Wang, Z. Tian, Y. Bai, C. Fan et al., “ADD 2022: The first audio deep synthesis detection challenge,” in Proc. ICASSP. IEEE, 2022, pp. 9216–9220.
[7] Q. Wang, P. Guo, and L. Xie, “Inaudible adversarial perturbations for targeted attack in speaker recognition,” Proc. INTERSPEECH, pp. 4228–4232, 2020.
[8] C.-C. Lo, S.-W. Fu, W.-C. Huang, X. Wang, J. Yamagishi, Y. Tsao, and H.-M. Wang, “MOSNet: Deep learning based objective assessment for voice conversion,” in Proc. INTERSPEECH, 2019, pp. 1541–1545.

 西工大音频语音与语言处理研究组