文章来源于音频语音与语言处理研究组,作者郭大可、朱新发
语音合成(TTS)旨在从文本生成自然的语音。随着基于序列到序列(seq2seq)方法的普及,语音合成系统在自然度上取得了显著改善。然而,使用当前语音合成系统合成诸如有声读物这种具有大量韵律变化的长语音(long-form)时,仍难获得令人满意的表现力和自然度。这是因为合成此类语音不仅需要将语言信息转换为语音,还要将上下文语境与韵律连贯性考虑进去。近期,西工大音频语音与语言处理研究组(ASLP@NPU)的论文“HiGNN-TTS: Hierarchical Prosody Modeling with Graph Neural Networks for Expressive Long-form TTS”被语音研究旗舰会议IEEE ASRU2023接收。该论文提出一种基于图神经网络和多层次韵律建模的高表现力长文本语音合成模型HiGNN-TTS,利用文本的结构化特征完成层次化的韵律建模,实现高表现力的长文本语音合成。现对该论文进行简要的解读和分享。论文题目:HiGNN-TTS: Hierarchical Prosody Modeling with Graph Neural Networks for Expressive Long-form TTS
作者列表:郭大可,朱新发,薛浏蒙,李涛,吕元骏,姜月鹏,谢磊
图1 发表论文截图
现有的 TTS 模型在自然度和表现力方面取得了显著进展,但在长文本语音合成上,特别是在类似有声书(audiobook)等场景下,传统方法在表现力方面与人类语音仍存在明显的差距。传统TTS通常仅对单个语句进行韵律建模,而长篇语音包含多个语义相关的语句,每个语句的韵律模式受其上下文语境影响。因此,需要一种能够在单词、单句和跨句层面进行层次韵律建模的方法。
本文提出了一种名为HiGNN-TTS的层次化韵律建模方法,旨在实现长篇语音的高表现力语音合成。该方法使用图神经网络(GNN)辅助语音合成,通过扩展GNN的层次韵律建模能力,包括单词、单句和跨句层面,实现高表现力长语音合成。具体而言,该方法在语法树中添加虚拟全局节点,增强了单词节点之间的连接关系。同时使用了多层次图编码器,提取文本在词、句和跨句上下文层面的层次结构特征。此外,我们引入了来自语音的韵律监督信号,以利用语音中的韵律模式指导文本中的韵律建模,并通过GNN的消息传递能力将其传播到图的每个单词节点。主观和客观实验表明,HiGNN-TTS在层次韵律建模方面取得了显著效果,提高了合成长语音的自然度和表现力。如图3所示,HiGNN-TTS的整体架构基于Fastspeech2 [1] ,引入了一个多层次图韵律编码器和一个预训练的Mel编码器。多层次图编码器基于句法图对文本韵律模式进行层次建模。它基于先前、当前和下一句的句法图,学习词级、句级和跨句上下文的多级韵律表表征。预训练的Mel编码器通过声学信号的自监督建模语音中的韵律,这种自监督或无监督的建模方式可以帮助捕捉更广的韵律变化。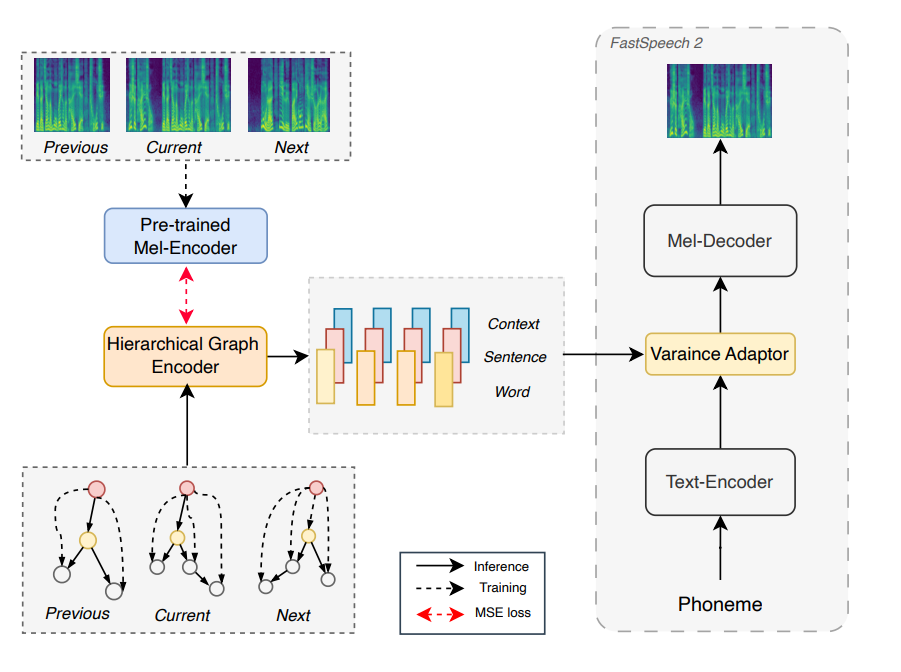
图3 HiGNN-TTS 模型结构
基于句法信息的图构建
我们在词级进行依存分析构建句法图。在句法树中,利用双词依存关系来描述词之间的语义关系。此外,基于句法树,我们引入了一个虚拟全局节点,连接树中的所有节点,构成句法图。图4为“我喜欢你”的句法图示例。不同颜色的节点表示不同的成分:红色表示虚拟全局节点,黄色表示句法图的头结点,灰色表示普通词节点;GLB、SBV 和 VOB 分别表示全局关系、主谓关系和动宾关系。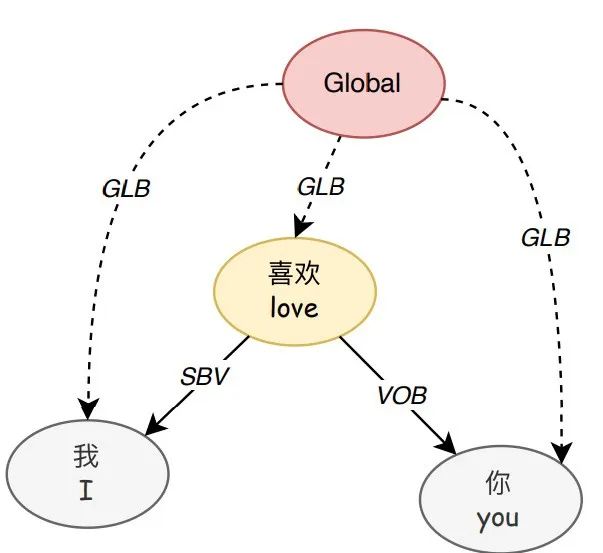
图4 句法图示例
句法图可以使用有向图表示,定义为。每个节点用表示,代表相应句子中的一个词。每条边用表示,代表从节点到节点的依赖关系。本文引入的虚拟全局节点,表示为,与所有节点连接,这些连接可以定义为。全局节点通过提供更大的感受野改善模型的感知能力,使其能够考虑到远距离的依赖关系,从而有效捕捉句子中存在的韵律模式。
我们使用从预训练的中文 BERT 中提取的 BERT embedding来初始化图节点特征。对于每个词节点,我们首先提取该词的 BERT embedding,然后进行平均池化以获取该词节点的特征。此外,全局节点使用 BERT CLS embedding进行初始化。
基于图的层次化韵律建模
我们通过层次图编码器(Hierarchical Graph Encoder)进行层次化韵律建模,如图5所示。层次图编码器接受先前、当前和下一句的句法图作为输入,捕捉当前句子内的单词级、句级以及跨句上下文级的韵律特征。我们采用门控图变换器(Gated Graph Transformer)[2] 将 编码为
 ,门控图变换器基于Transformer模型,使用自注意机制对节点特征进行加权聚合。第
 个节点特征的更新可以通过以下公式表示:
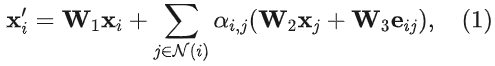
其中, 表示原始节点特征,
 表示更新后的节点特征。
 表示节点
 的邻居节点集合,
 对应节点
 与其邻居节点
 之间的边,
 表示节点
 与其邻居节点
 之间的可学习注意权重。
 、
 和
 是用于线性变换的可学习权重矩阵。
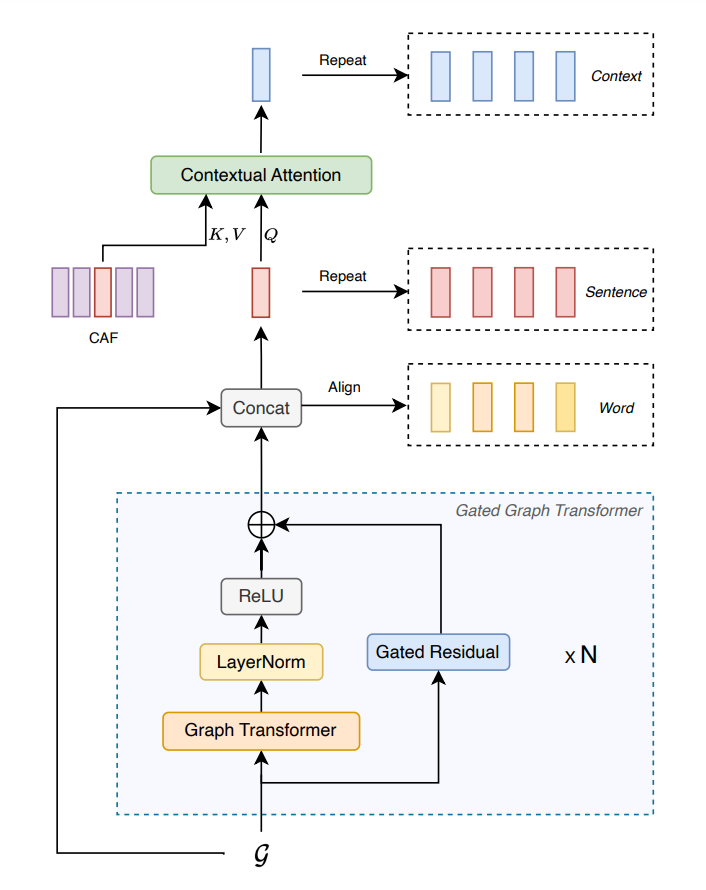
在对 编码成
 后,我们通过拼接将
 和
 融合成最终的图。由于图编码器是与声学模型联合训练的,并受到预训练 Mel 编码器输出的约束。因此,最终融合图中的节点特征不仅包含文本中的语义信息,还包括语音中的声学韵律。与 GST [3] 类似,我们对融合图中的每个节点使用 tanh 激活,以进一步增强每个节点特征的韵律多样性。
为了捕捉跨句子的上下文韵律模式,我们首先将前一句、当前句和下一句的句级表示拼接在一起,称为“Context Aggregation Features (CAF)”。接着,通过上下文注意机制学习跨句韵律表征,其中CAF被用作键和值,而当前句子级表示充当查询。上下文注意机制实际上可以被视为一种图神经网络,其中将每个句子表示视为一个节点,整个连接表示为全连接图。通过使用注意机制,计算每个句子与其他句子之间的注意权重,有效地聚合上下文信息,类似于图神经网络中的消息传递过程。
为了便于将从层次图编码器学到的层次韵律表示合并到声学模型中,我们将每个单词级表征与其相应单词的音素序列长度对齐,并将句子级和跨句子级的韵律表征重复,使其长度与当前句子的音素序列长度相同。
层次化韵律监督
我们使用预训练的 Mel-encoder 模型监督层次图编码器中学到的韵律表征。该 Mel 编码器在多说话人多风格数据集上完成预训练,从给定参考语音的 Mel 频谱图中提取句级声学韵律特征。为了获得更纯粹的韵律表征,我们使用域对抗训练(DAT)去除了语音中的与说话人相关信息,使韵律表征与说话人无关。我们从前一句、当前句和下一句的语音中提取与说话人无关的声学韵律嵌入,通过均方误差(MSE)损失直接约束图编码器中学到的相应句级韵律表征。监督信号借助 GNN 的消息传递(message passing)能力,从句级传播到单词级节点,实现了层次化的声学韵律监督。通过层次化的声学韵律监督,我们能够全面捕捉具有高动态范围的韵律变化,提高语音合成的表现力。实验
设置实验数据:标贝提供的有声书数据集,2个说话人,大约8小时。
对比系统
FS2-BERT [4]: 基于 FastSpeech2 的模型,通过使用跨句子的 BERT 嵌入考虑上下文语境。
HCE [5]: 基于 FastSpeech2 的模型,利用层次上下文编码器(HCE)从层次上下文信息中预测句子级别的风格嵌入。
ATCE [6]: 基于 FastSpeech2 的模型,具备声学和文本上下文编码器(ATCE),利用文本和音频上下文来获取上下文韵律表示。
HiGNN-TTS:本文方案。
客观测试
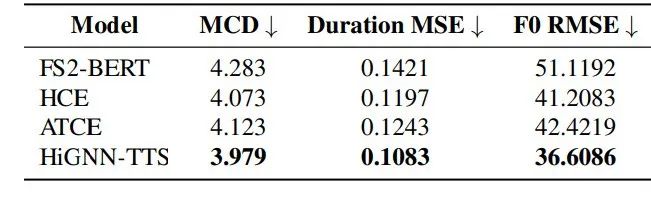
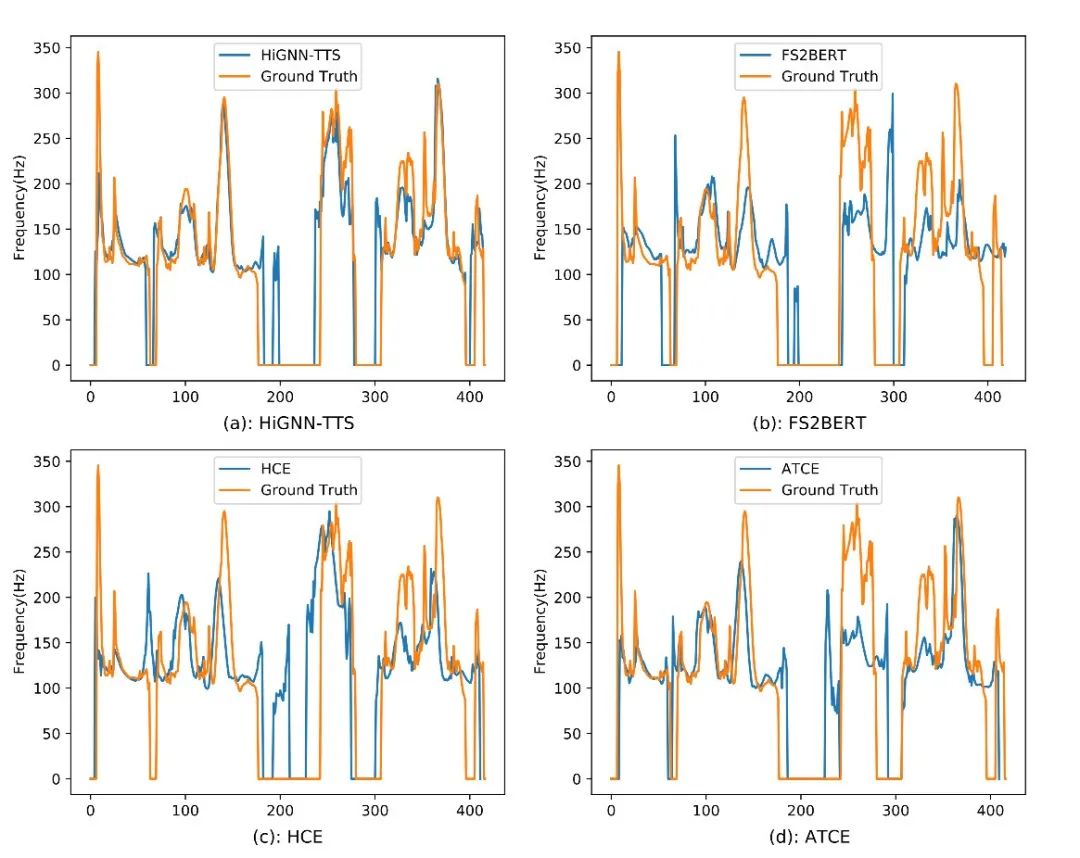
本文使用50句预留测试集对HiGNN-TTS模型进行客观评测,包括F0的均方根误差(RMSE)、时长的均方误差(MSE)和MCD。实验结果表明,HiGNN-TTS在所有指标上均优于三个对比模型。同时,还观察到HiGNN-TTS的F0 RMSE显著低于对比模型,这可以归功于HiGNN-TTS层次化的韵律建模方法,从而能够捕捉到具有高动态范围的韵律变化。进一步,通过可视化不同模型合成语音的F0曲线(图4),可以发现HiGNN-TTS的F0曲线更贴近实际录音,进一步证明了其在分层韵律变化的捕捉上的有效性。
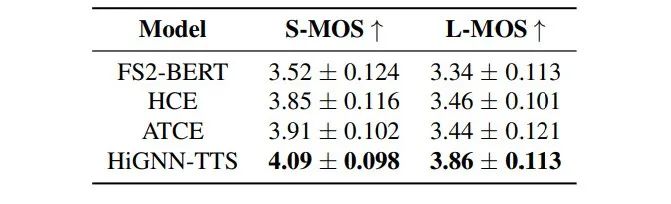
为了更全面的性能评估,我们组织了两种不同MOS测听,针对短文本(S-MOS)和长文本(L-MOS)的测试。S-MOS包括带有上下文的单个句子,每个句子大约持续5秒。而L-MOS则通过拼接多个短句子构成,每个长句持续时间约40秒。如表2所示,HiGNN-TTS在S-MOS和L-MOS上均取得了最优表现,分别为4.09和3.86。值得注意的是,由于听众在聆听长篇语音时易出现听觉疲劳,L-MOS得分始终低于S-MOS得分。即便如此,我们的层次化韵律建模方法在长篇语音中仍然展现出对所有对比模型的显著优势。更高的S-MOS和L-MOS得分表明我们的模型具备合成更具表现力语音的能力。
表2 不同模型的短文(S-)和长文(L-)合成MOS得分,95%置信区间
消融实验
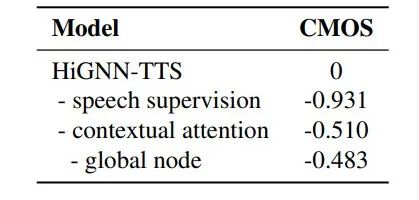
基于CMOS的消融实验结果如表3所示。我们看到,HiGNN-TTS 中所有设计对生成语音表现力产生了显著正面影响。具体而言,在去除 HiGNN-TTS 中的声学韵律监督策略时,导致了最大的 CMOS 下降。这表明声学韵律监督有助于层次图韵律编码器捕捉更大动态范围的韵律变化。此外,去除上下文注意力也导致了 CMOS 下降,这是由于缺乏跨句子的上下文韵律信息。在去除上下文注意力的基础上,进一步去除语法图中的全局节点,由于缺乏句中整体韵律,也导致了 CMOS 下降。
短篇文本:
长篇文本:
https://dukguo.github.io/HiGNN-TTS/[1] Yi Ren, Chenxu Hu, Xu Tan, Tao Qin, Sheng Zhao, Zhou Zhao, and Tie-Yan Liu, “Fastspeech 2: Fast and high-quality end-to-end text to speech,” in Proc. ICLR, 2021.[2] Yunsheng Shi, Zhengjie Huang, Shikun Feng, Hui Zhong, Wenjing Wang, and Yu Sun, “Masked label prediction: Unified message passing model for semi-supervised classification,” in Proc. IJCAI, 2021, pp.1548–1554.[3] Yuxuan Wang, Daisy Stanton, Yu Zhang, R. J. Skerry Ryan, Eric Battenberg, Joel Shor, Ying Xiao, Ye Jia, Fei Ren, and Rif A. Saurous, “Style tokens: Unsupervised style modeling, control and transfer in end-to-end speech synthesis,” in Proc. ICML, 2018, pp. 5167–5176.[4] Tomoki Hayashi, Shinji Watanabe, Tomoki Toda, Kazuya Takeda, Shubham Toshniwal, and Karen Livescu, "Pre-trained text embeddings for enhanced text-to-speech synthesis," in Proc. Interspeech, 2019, pp. 4430–4434.[5] Detai Xin, Sharath Adavanne, Federico Ang, Ashish Kulkarni, Shinnosuke Takamichi, and Hiroshi Saruwatari, "Improving speech prosody of audiobook text-to-speech synthesis with acoustic and textual contexts," in Proc. ICASSP, 2023, pp. 1–5.[6] Shun Lei, Yixuan Zhou, Liyang Chen, Zhiyong Wu, Shiyin Kang, and Helen Meng, "Towards expressive speaking style modeling with hierarchical context information for Mandarin speech synthesis," in Proc. ICASSP 2022, 2022, pp. 7922–7926、
 西工大音频语音与语言处理研究组