文章来源于音频语音与语言处理研究组,作者李玉珂、谢磊
跨语种语音合成中的零样本情感迁移(zero-shot emotion transfer)旨在将情感从源语言中的任意参考音频(reference)迁移到目标语言中的合成音频,该项技术在诸如影视剧自动配音中具有重要的应用价值。构建这样的系统面临着两方面的挑战:跨语种带来的不自然有口音问题以及如何建模不同语言的共享情感表达。近期,西工大音频语音与语言处理研究组(ASLP@NPU)和爱奇艺合作的论文“Zero-Shot Emotion Transfer For Cross-Lingual Speech Synthesis”被语音研究旗舰会议ASRU2023接收。该论文以 DelightfulTTS 为基础,通过非自回归预测编码(NPC)模块学习语种特定的韵律表征,以及使用自监督模型对语种共享的情感表征进行建模,从而实现更具表现力以及更自然的跨语种语音合成中的情感迁移。现对该论文进行简要的解读和分享。论文题目:Zero-Shot Emotion Transfer For Cross-Lingual Speech Synthesis作者列表:李玉珂,朱新发,雷怡,李海,刘俊辉,谢丹明,谢磊
合作单位:爱奇艺
论文原文:https://arxiv.org/abs/2310.03963
样例:https://ykli22.github.io/ZSET/
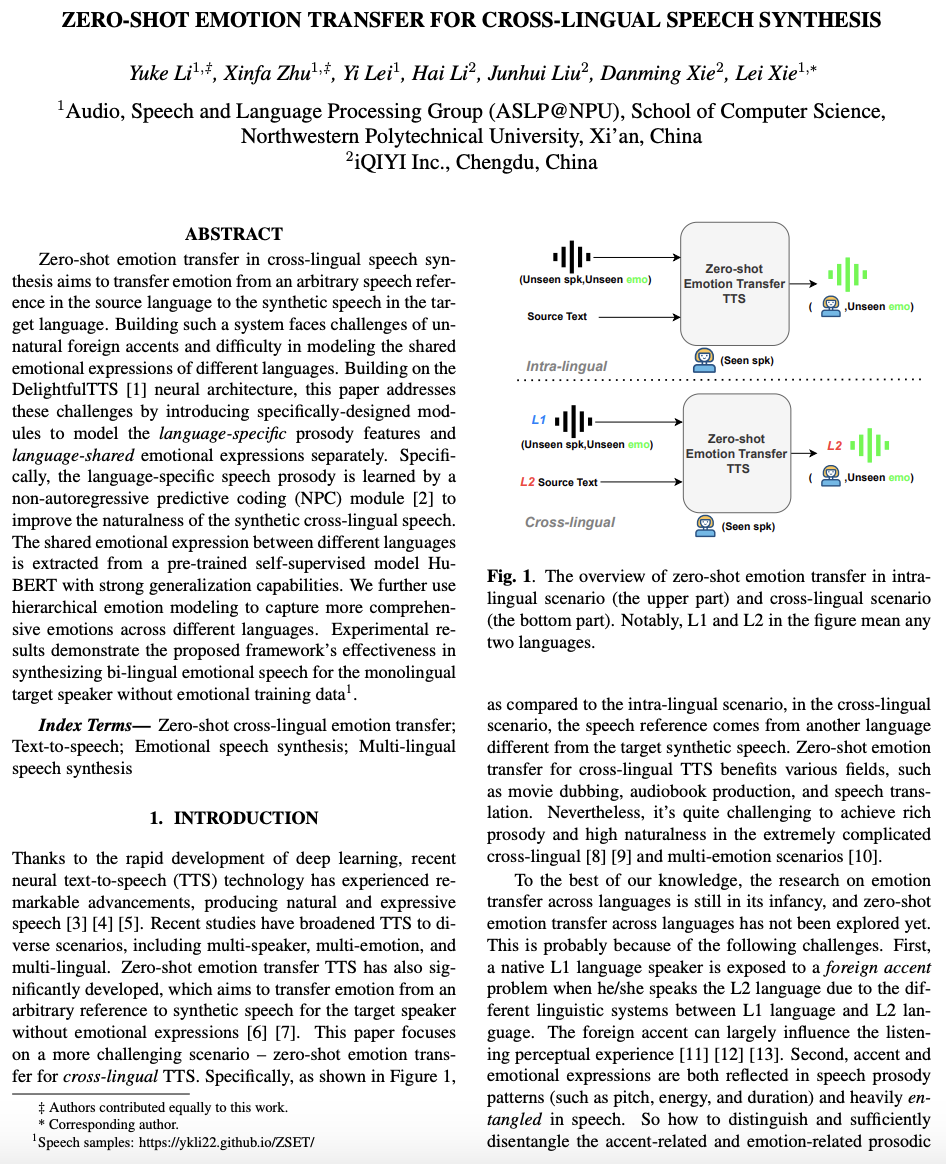
图2 扫码直接看论文
深度学习推动了语音合成技术的进步,当下语音合成系统可以合成自然且富有表现力的语音。最近的一些研究将 TTS 扩展到了多种场景,包括多说话人、多情感和多语种。零样本情感迁移 TTS 也得到了快速发展,其目的是将情感从任意参考音频迁移到没有情感表达的目标说话人的音频中。本文重点关注一个更具挑战性的场景——跨语种的零样本情感迁移(Cross-lingual zero-shot emotion transfer)。与单一语种场景相比,在跨语言场景中,参考音频来自与目标合成语音不同的另一种语言。跨语言 TTS 的零样本情感迁移具有广泛的应用,例如电影配音、有声读物制作和语音翻译等。然而,在跨语种和多情感场景中实现丰富的韵律和高自然度是相当具有挑战性的。具体来说,首先,如图 3 所示,令两种不同的语言分别为L1、L2。由于L1和 L2之间的语言系统不同,母语为L1的人在讲L2时会遇到外国口音问题。口音在很大程度上影响听觉感知体验。其次,口音和情感表达都反映在语音韵律模式(例如音调、能量和持续时间)中,那么如何区分与口音相关的韵律和与情感相关的韵律是跨语种情感迁移的关键因素。第三,从参考音频中有效提取训练集中未见(unseen)的情感表达并根据该情感表达准确生成另一种语言的语音是极具挑战的。图3 单语种(上部分)和跨语种场景(下部分)中零样本情感迁移。
其中图中的L1和L2表示任意两种语言。
本文提出了一种基于 DelightfulTTS[1] 的零样本跨语种情感迁移方法。为了解决语音表征中口音和情感耦合的问题,本文引入了非自回归预测编码(NPC)模块[2]和多层级情感编码器,将韵律变化分解为语种特定的口音特征和语种共享的情感表征,并将其重构为跨语言情感语音音频。NPC 模块使用基于自监督的语音表征重建方法,旨在根据语音的自依赖性来学习不同语言的韵律模式,以解决跨语种的口音问题。此外,多层级情感编码器利用 HuBERT 来提取与说话人无关的表征。HuBERT模型[3]由大量无标签数据训练而成,具有很强的泛化能力,可以显著提高零样本情感迁移的性能。此外,考虑到各种声学和语言特性往往被编码在自监督模型的不同层中,我们通过对不同层级的信息编码来获得不同粒度的情感表征,旨在捕捉和传达情感的微妙差异,更全面地了解不同语言之间的关系。在客观和主观评估中,所提出的方法都优于Baselinse,实现了更自然和更具表现力的跨语言情感迁移语音合成。
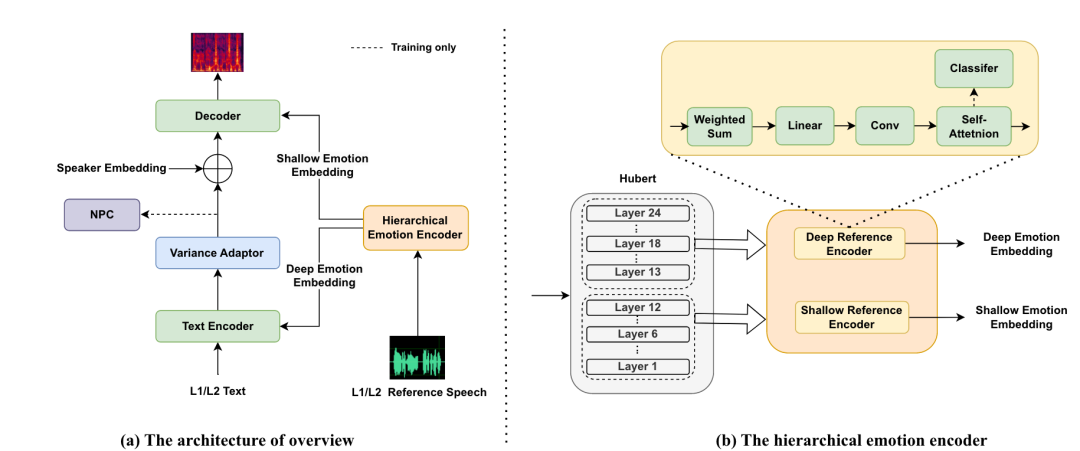
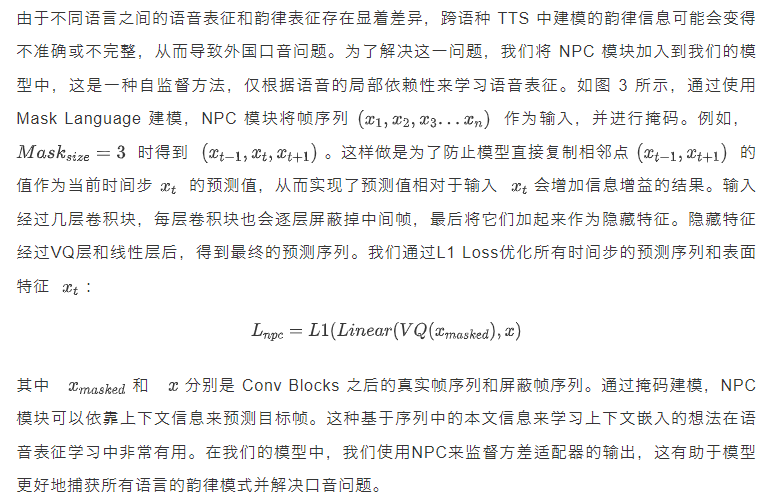
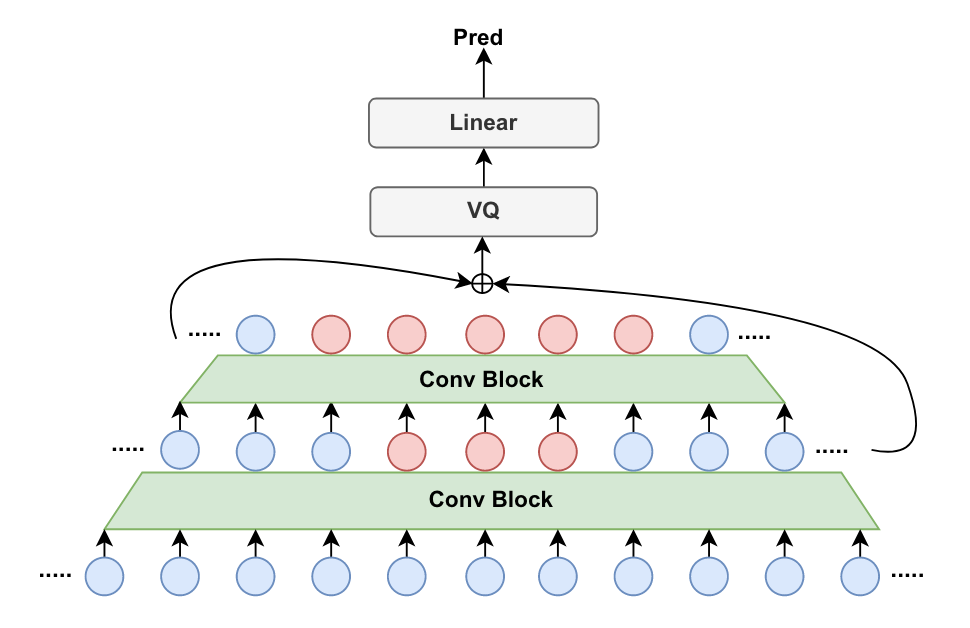
本文所提出的方法在Delightful TTS架构的基础上,增加了 NPC 模块和多层级情感模块,如图 4 所示。多层级情感编码器负责使用 HuBERT 学习多层级情感表征。然后这些表征被迁移到编码器和解码器以合成情感语音。NPC 模块专门用于训练阶段,以自监督的方式对所有语言的韵律进行建模。最后,我们使用 HiFiGAN从梅尔频谱生成语音。NPC模块
图5 NPC模块
多层级情感编码
零样本情感迁移涉及复杂多样的情感。为了增强模型对不同语言的泛化能力,我们采用了 中文版HuBERT(见下面推文),它以无监督的方式对来自 WenetSpeech 数据集的 10,000 小时中文语音数据进行了预训练 。由于 HuBERT 的不同层包含不同信息,因此我们利用不同层的 HuBERT 表征来提取多层级情感特征的策略。与仅依赖单层相比,这种方法可以提高情感迁移的性能。HuBERT 的浅层通常捕获更细粒度的信息,而深层提供更强的语义信息,但对细节的感知有限。因此,我们使用第 1 至 12 层的 HuBERT 表征提取浅层情感嵌入,并使用第 13 至 24 层的表征提取深层情感嵌入。如图 2 所示,情感编码器包括浅层参考编码器和深层参考编码器,其具有相同的结构。参考编码器对 HuBERT 不同层的表征进行加权求和,以提取情感表征。参考编码器的结构遵循 Meta-StyleSpeech [4] 中的Mel reference Encoder。为了获得情感嵌入,对训练集随机截取一段200帧的音频样本作为HuBERT的输入。然后将情感嵌入输入到全连接层,然后进入残差卷积层以捕获序列信息。多头注意力用于编码全局信息。最后,将浅层情感嵌入添加到解码器输入中,并将深层情感嵌入集成到编码器中。在训练过程中,我们使用部分情感标记数据来预训练该模块,以指导未标记数据进行情感建模。找不到中文语音预训练模型?中文版 Wav2vec 2.0和HuBERT来了,腾讯游戏知几AI团队和西工大ASLP组联合出品
训练及推理策略
在训练过程中,我们首先使用 L1语言数据预训练多层级情感编码器,该编码器利用少量标记的情感数据进行监督指导。随后,我们使用双语数据集对声学模型和情感编码器进行联合训练。这种联合训练过程对情感编码器进行微调,从而能够建立语言共享的情感空间。推理时,该模型可以使用某种语言中任意未见过的带情感音频作为参考音频,并使用另一种语言的文本作为输入。当然,使用平行数据可以在情感传递过程中带来更好的结果。多层级情感编码器提取语种共享的情感嵌入。同时,将翻译后的文本处理为音素序列并输入文本编码器。通过加入情感嵌入并将其与翻译文本对齐,确保生成的目标语言音频保留参考音频中的情感,从而实现有效的情感传递。实验设置
- 中文语料:内部数据集,包含7个说话人,共23小时中文数据。其中4名说话人有 6 种情绪,包括快乐、愤怒、悲伤、惊讶、厌恶、仇恨和恐惧,而其他说话人数据没有明显情绪。
- 泰文语料:内部数据集,包含 8 个泰语说话人,共 20小时泰语数据,其中只有 1 位说话人有情感数据。
- SCLN-GST: 一种跨说话人情感迁移框架[5],以 Global Style Token 作为参考编码器,而模型通过 SCLN 块学习说话人嵌入。
- M3:一种多说话人多风格多语言语音合成系统[6],它包含一个说话人条件变分编码器,用于对抗训练以解耦说话人信息。此外,风格信息由细粒度风格编码器提取。
- Proposed:本文提出的跨语言跨说话人零样本情感迁移框架。
主观测试
主观测试采用平均意见得分(MOS),从情感相似度和自然度方面评估了三个模型在零样本情感迁移方面的性能。测试集由30个集外的中文情感语音样本和30个集外的泰语情感语音样本组成。以中文到泰语(CN to TH)场景为例,我们准备中文参考音频和相应的泰语翻译文本,为两个中性中文说话人生成泰语样本。我们邀请了10名中文说话人和5名泰语说话人进行主观测听。结果如表 1 所示,本文提出的方法在情感相似度和自然度方面取得了最佳性能。更高的情感相似度证明了多层级情感建模的有效性。此外,所提出的方法实现了最佳的语音自然度,表明其能够生成跨语种音频并减轻口音问题。此外,SCLN-GST 模型的情感相似度和自然度很低,这可能是由于SCLN-GST是一种单语种情感迁移模型,其在跨语言情感迁移方面的表现有限。另一方面,M3 作为一种跨语种风格迁移模型,在情感迁移方面表现较差。表1 本文模型与 M3、SCLN-GST 以及消融实验在情感相似度和自然度的MOS分结果。NMOS表示自然度MOS,EMOS表示情感相似度MOS。SPKCOS 表示说话人的余弦相似度。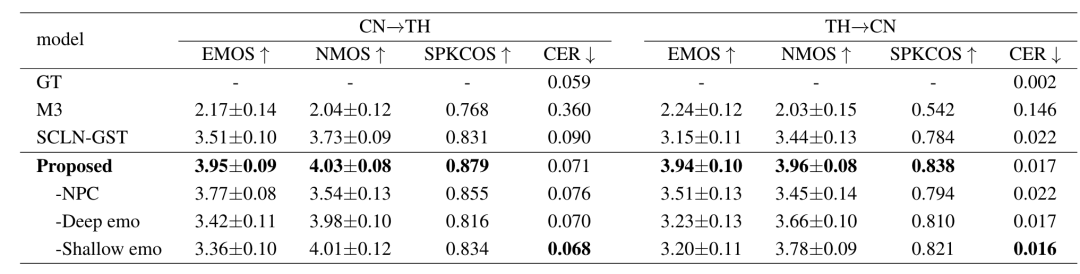
在客观评估中,我们使用合成语音的说话人余弦相似度和字错误率(CER)来衡量说话人相似度和整体语音质量。如表1所示,测试结果表明,本文模型获得了最高的说话人相似度,并实现了最接近真实音频的CER,表明其音色稳定性和可懂度均有提升。然而,SCLN-GST 和 M3 表现出比本文模型更高的 CER,这表明这两种模型在用中文和泰语迁移情感的同时可能面对发音准确度的问题。
消融实验
为了证明提出方法的有效性,我们进行了消融研究来检查NPC 模块和多层级情感建模两个关键模块的影响。具体而言,我们将完整模型的性能与三个变体进行比较:第一个没有 NPC 模块(-NPC),第二个仅使用浅层情感表征(-Deep emo),第三个仅使用深层情感表征(-Shallow emo)。如表1所示,去除NPC模块导致自然度略有下降,表明NPC模块在解决口音问题和提高合成语音的自然度方面发挥着关键作用。另一方面,当依赖单层情感表征时,情感表现力显著下降。此外,我们发现仅有深层情感表征的模型比仅有浅层情感表征的模型表现出较低的情感相似度,但是识别准确率和说话人相似度较高。这些结果表明,浅层情感表征有助于情感表达,而深层情感表征包含更多语义信息,有利于提升语音自然度和准确发音。通过采用多层级情感模块,我们可以准确捕捉不同层次的细微情感差异,从而提高生成语音的情感相似度、自然度和表现力。
样例1
中文参考音频(截取自影视剧):
中文文本:不是而且这人也太损了,他就泄漏几页,我还能让秦燕飞改改,他把整本都泄漏出去了,这是要重写啊。
泰语文本:ไม่สิ คนๆ นี้จะเลวเกินไปแล้ว ถ้าเขาปล่อยไปแค่ไม่กี่หน้า ฉันยังให้ฉินเยี่ยนเฟยแก้ให้ได้ แต่เขาเล่นปล่อยทั้งหมดออกไป นี่มันต้องเขียนใหม่เลยนะ
合成音频:
泰语文本:อายุฉันนะ มันมีเรื่องเยอะมากเลยนะ
中文文本:在我这个年纪,发生了很多事情
合成音频:
更多样例敬请访问:https://ykli22.github.io/ZSET/
[1] Yanqing Liu, Zhihang Xu, Gang Wang, Kuan Chen, Bohan Li, Xu Tan, Jinzhu Li, Lei He, and Sheng Zhao, “Delightfultts: The Microsoft speech synthesis system for blizzard challenge 2021,” CoRR, vol. abs/2110.12612, 2021.[2] Alexander H Liu, Yu-An Chung, and James Glass, “Non-autoregressive predictive coding for learning speech representations from local dependencies,” Proc.Interspeech, 2021.[3]Wei-Ning Hsu, Benjamin Bolte, Yao-Hung Hubert Tsai, Kushal Lakhotia, Ruslan Salakhutdinov, and Abdelrahman Mohamed, “Hubert: Self-supervised speech representation learning by masked prediction of hidden units,” IEEE ACM Trans. Audio Speech Lang. Process., vol. 29, pp. 3451–3460, 2021.[4]Dongchan Min, Dong Bok Lee, Eunho Yang, and Sung Ju Hwang, “Meta-style speech: Multi-speaker adaptive text-to-speech generation,” in International Conference on Machine Learning. PMLR, 2021, pp. 7748–7759.[5] Pengfei Wu, Junjie Pan, Chenchang Xu, Junhui Zhang, Lin Wu, Xiang Yin, and Zejun Ma, “Cross-speaker emotion transfer based on speaker condition layer normalization and semi-supervised training in text-to-speech,” CoRR, vol. abs/2110.04153, 2021.[6] Zengqiang Shang, Zhihua Huang, Haozhe Zhang, Pengyuan Zhang, and Yonghong Yan, “Incorporating cross-speaker style transfer for multi-language text-tospeech.,” in Proc.Interspeech, 2021, pp. 1619–1623
 西工大音频语音与语言处理研究组