语境偏置(Contextual biasing)旨在将语境知识集成到语音识别(ASR)系统中,以提高在相关领域词汇(俗称“热词”)上的识别准确率。诸多ASR实际应用场景很可能会包含训练数据中数量很少或完全没出现的词语,这些词语大多是领域相关的专有名词等,尽管这些词语对整体识别错误率的影响不明显,但在这些热词上的识别准确率对用户体验和下游任务的影响却非常大。因此语境偏置方法具有重要价值,旨在提升在这些“热词”上的识别准确率。西工大音频与语音处理研究组(ASLP@NPU)致力于语音识别领域定制和语境偏置相关的研究。近期,实验室和WeNet开源社区合作发表的论文“Spike-Triggered Contextual Biasing for Mandarin End-to-End Speech Recognition”被语音领域旗舰会议IEEE ASRU 2023接收。该论文提出了一种基于尖峰触发(Spike-triggered)的深度语境偏置方法,同时支持显式与隐式的偏置方式,两种偏置方式都能够在给定热词上取得显著的改进,并可与浅融合偏置方法级联以获得更好的效果。此外,该文还提出了训练阶段上下文采样增强策略,并进一步改进了热词筛选算法。现对该论文进行简要的解读和分享。论文题目:Spike-Triggered Contextual Biasing for Mandarin End-to-End Speech Recognition
作者列表:黄凯勋,张奥,张彬彬,徐天翼,宋星辰,谢磊
合作单位:WeNet开源社区
论文地址:https://arxiv.org/abs/2310.04657
图2 扫码直接看论文
背景动机
在过去的研究中,端到端模型的语境偏置方法大致可以分为两类:基于浅融合的语境偏置,如基于 Trie、WFST 的方法 [1],以及基于神经网络的语境偏置(称为深度偏置) [2, 3, 4, 5, 6, 7]。最近,由于对偏置短语改进效果更好以及更易于在端到端模型中集成,深度偏置的方法变得更加流行。
之前的大多数深度偏置方法上下文信息的集成过程都是隐式的,其偏置过程完全在端到端模型内部进行。而浅融合偏置往往通过在解码的过程中改变模型输出的后验来实现偏置,其偏置过程是显式的。虽然隐式的偏置方法可能取得更好的效果,但统一的结构使得在推理过程中对不同热词的偏置程度的控制变得十分困难。C-CIF [5] 提出了一种基于CIF语境偏置模型的协同解码方法,利用上下文解码器获取热词输出的分布,与模型原本的解码器协同解码以获得最终假设。由于协同解码的过程是在最后的输出分布上进行的,因此可以通过为不同热词设置权重,直接控制每个热词的偏置程度。C-CIF结合了浅融合偏置和深度偏置的优点,但由于依赖CIF模型能够将声学编码从帧级别转化到字级别的特性,只能在CIF模型中使用。
为了解决这个问题,我们提出了一种基于尖峰触发的深度语境偏置方法,可以在 AED 模型上同时支持隐式和显式的语境偏置。同时,我们提出了一种训练时上下文采样增强方法,并对热词筛选算法进行了优化。实验表明,在基于 WenetSpeech 的开源普通话偏置词数据集上,我们提出的方法相对于基线模型字错误率(CER)相对下降 32.0%,热词部分的CER相对下降 68.5%,当与基于 WFST 的浅融合方法结合使用时,热词CER相对下降 69.9%。我们的方法对于在训练集中出现次数很少甚至从未出现过的罕见词也有着良好的偏置效果。
在之前的研究中,我们提出了基于热词短语预测网络的热词语音识别方案,探索了适用于 CTC 、AED 和 Transducer 等主流 ASR 模型的深度偏置方案,并在 WeNet 上进行了开源,以下是相关工作的推文链接:
受 [8] 启发,我们应用了其中尖峰触发的思路进行语境偏置。由于 CTC 损失的性质,在后验上会有许多发射尖峰,一个尖峰大致对应到解码结果中的一个字,通过寻找这些发射尖峰,能够将帧级别的信息转为字级别的信息,协助之后的语境偏置过程,并且使显式偏置成为了可能。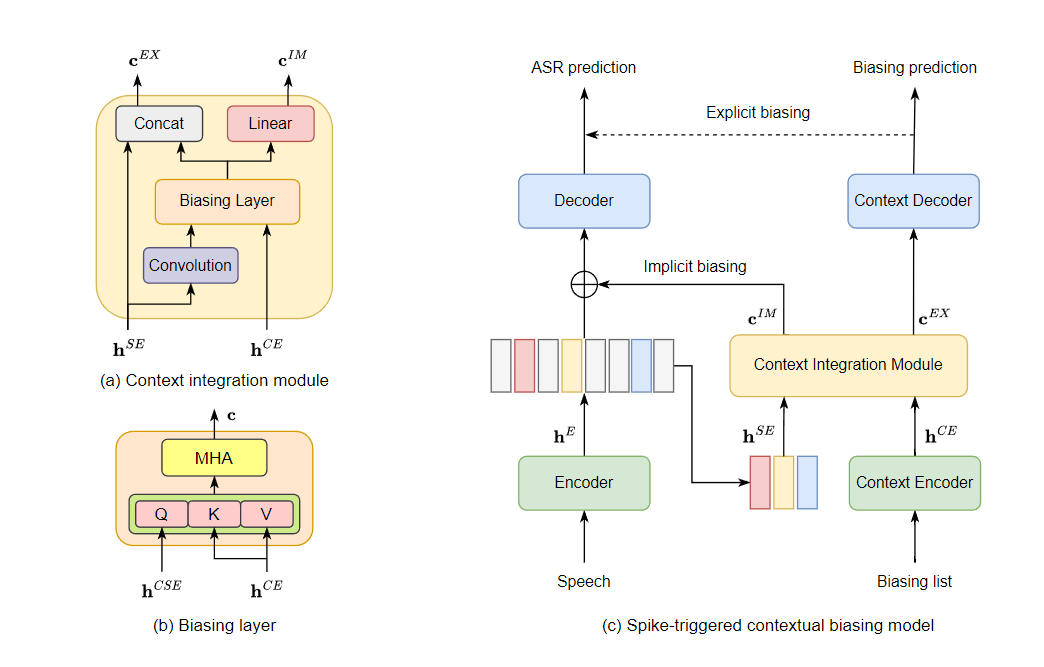
图3 基于尖峰触发的 AED 偏置模型结构
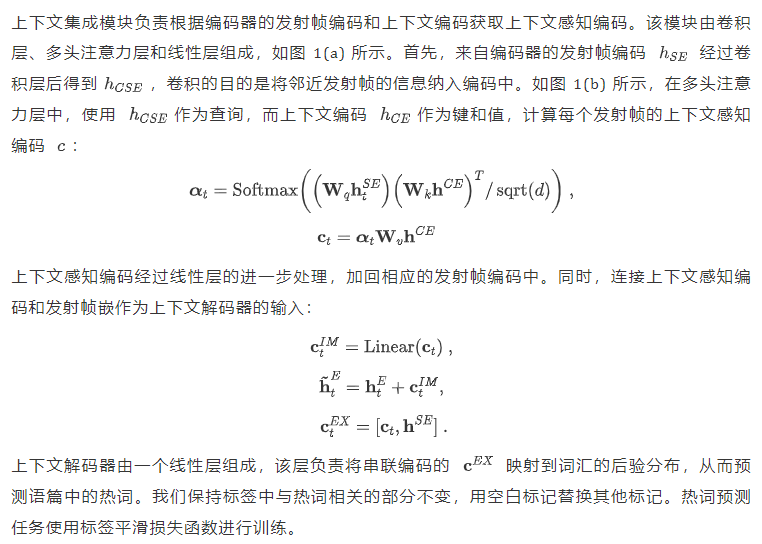
为了实现上下文偏置,如图 3 所示,我们在 AED 模型中添加了上下文编码器、上下文集成模块、上下文解码器,下面将分别对这些结构进行介绍。在训练过程中,我们根据文本标签和 CTC 后验,使用维特比算法来计算后验概率最高的发射帧序列。在推理阶段,我们采用与 CTC 贪婪搜索类似的方法。我们将输出非且和上一帧数处标记不同的帧视为发射帧。由于英语 ASR 模型通常使用字节对编码(BPE)标记作为建模单元,而这些标记没有根据发音进行分割,因此推理过程中选择的发射帧与普通话 ASR 模型相比准确性较低。这一局限性影响了尖峰触发上下文偏置方法在英语 ASR 模型上的有效性。
隐式与显式偏置
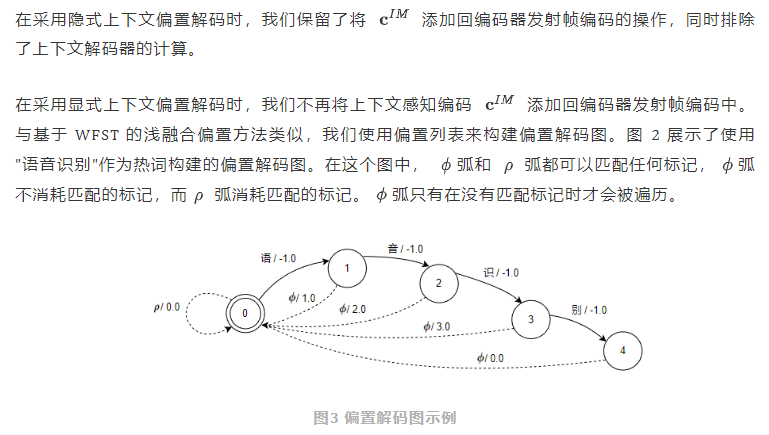
在采用隐式上下文偏置解码时,我们保留了将添加回编码器发射帧编码的操作,同时排除了上下文解码器的计算。
我们在偏置解码图中使用上下文解码器的后验概率进行波束搜索,路径得分为上下文解码器后验概率与偏置解码图得分之和,使用波束搜索的解码路径为 ASR 后验概率引入偏置。具体来说,如果解码路径在一个发射帧解码了某个标记,就在该帧的 ASR 后验对应标记上添加偏置得分。与 C-CIF 中的显式偏置相比,由于应用了偏置解码图,对后验的偏置会更加准确。
热词短语筛选方法
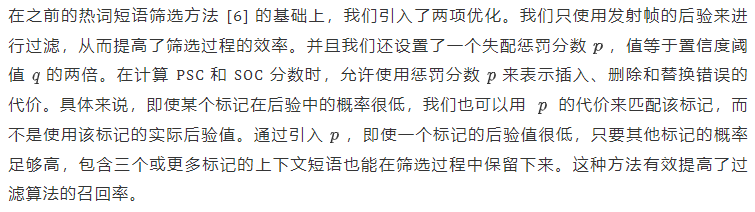
热词采样增强策略
在模型训练过程中,我们以一定的概率将采样出的热词短语中的某个字替换成发音相同的字,同时也替换抄本标签中对应的字,如图 4 所示。通过这一步骤,模型必须学习到热词短语中的信息才能准确识别出被替换的字,提高了模型应用上下文信息的能力。
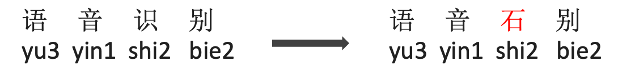
图4 热词采样增强示例
数据与配置
本文的实验都是在中文开源数据集WenetSpeech偏置词数据集[7]上进行的,其中包含从 Wenetspeech 全集中挑选的 1000 小时子集。测试集分为三类:人名、地名和机构名称,每个数据集都有其对应的热词列表,包含在训练集中出现 5 到 700 次的命名实体。我们使用完整的 1000 小时的训练集进行训练,合并三个测试集的热词列表(共 298 个热词)进行测试。
为了评估模型处理罕见热词的能力,我们从 WenetSpeech 全集中挑选部分数据以构建 few-shot 测试集。具体来说,我们选择在训练集中出现次数不超过 0、3、10 和 50 次的命名实体得到 few-shot 热词列表,然后选取包含这些热词的数据构建 few-shot 测试集。每种 few-shot 测试集包含 400 条数据,热词列表包含 100 个热词。
除了字错误率(CER)之外,我们还使用偏置字错误率(B-CER)和无偏字错误率(U-CER)评估结果。U-CER 对和热词列表无关的字进行评估,而 B-CER 则对和偏置列表相关字进行评估。对于插入错误,如果插入的字与热词列表相关,则计入 B-CER,否则计入 U-CER。
对比热词偏置模型与基线
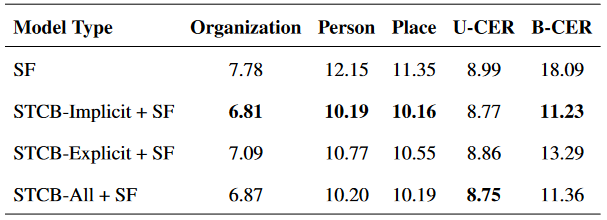
我们测试了所提出的模型(STCB)的热词增强效果,并与基线模型和基于上下文短语预测网络的神经网络热词增强模型(CPPN)[4] 进行对比。如表 1 所示,在每种测试集上,相比于基线模型,所提出的模型均在 CER 上取得了显著改进。使用隐式偏置时, CER 平均相对减少 32.0%,B-CER 平均相对减少 68.6%。此外,STCB 模型使用隐式偏置推理时热词增强效果优于同样是隐式偏置的 CPPN 方法。表1 在不同测试集上的 CER 结果,U-CER与B-CER为三个测试集的平均结果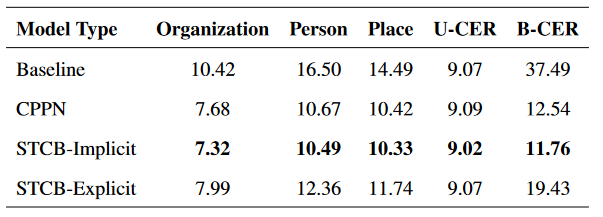
Few-shot 热词增强
为了评估模型对于罕见词的增强能力,我们在 few-shot 测试集上进行了测试。如表 2 所示,对于隐式和显式偏置方法,与基线模型相比,0-shot 测试集上的 B-CER 相对下降了 59.1% 和 44.3%,而在 10-shot 测试集上相对下降了为 38.0% 和 31.8%。结果表明,我们所提出的方法即使对在训练集中从未出现过的热词也能够带来显著的改进。表2 在 few-shot 测试集上的 B-CER 结果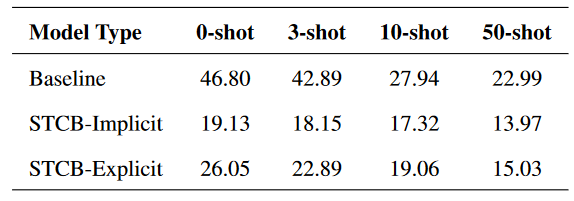
对比浅融合方法
在该实验中,我们测试了基于浅融合的热词增强方法以及将浅融合方法与所提出的方法级联使用时的效果。如表 3 所示,浅融合热词增强方法在三个测试集上也取得了较好的效果,而将我们的方法与浅层融合方法相结合后,无论使用显式偏置还是隐式偏置,都取得了进一步的改进。但同时结合显式偏置、隐式偏置与浅融合时却没有提高。我们认为这是由于显式偏置和隐式偏置所能够提供给模型的信息是相似的。而浅层融合方法提供的信息与基于神经网络得热词增强方法则不同,所以在结合使用时可以有所改进。上下文短语筛选方法
表 4 展示了应用原本的热词筛选算法 [6] 与我们改进的热词筛选算法的结果,改进后得热词筛选算法在进行筛选时具有更高的召回率和精确率,并在所有测试集上都取得了更好的 CER 结果。表4 应用不同上下文短语筛选算法的 CER、召回率和精确率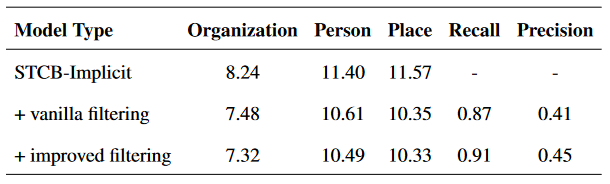
消融
如表 5 所示,我们对所提出的方法进行了消融实验。对于隐式偏置方法,我们分别去除了上下文集成模块中的卷积层、上下文采样增强策略和偏置损失。结果表明,这些步骤的缺失会削弱热词增强的效果。对于显式偏置方法,我们与使用 C-CIF 的显式偏置策略 [5] 进行了对比,我们的方法取得了更好的热词增强效果。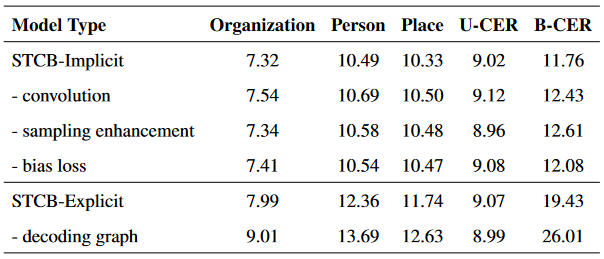
[1] Z. Chen, M. Jain, Y. Wang, M. L. Seltzer, and C. Fuegen, “End-to-end contextual speech recognition using class language models and a token passing decoder,” in IEEE International Conference on Acoustics, Speech and Signal Processing, ICASSP 2019, Brighton, United Kingdom, May 12-17, 2019. IEEE, 2019, pp. 6186–6190.[2] G. Pundak, T. N. Sainath, R. Prabhavalkar, A. Kannan, and D. Zhao, “Deep context: End-to-end contextual speech recognition,” in 2018 IEEE Spoken Language Technology Workshop, SLT 2018. IEEE, 2018, pp. 418–425.[3] F. Chang, J. Liu, M. Radfar, A. Mouchtaris, M. Omologo, A. Rastrow, and S. Kunzmann, “Context-aware transformer transducer for speech recognition,” in IEEE Automatic Speech Recognition and Understanding Workshop, ASRU 2021. IEEE, 2021, pp. 503–510.[4] Kaixun Huang, Ao Zhang, Zhanheng Yang, Pengcheng Guo, Bingshen Mu, Tianyi Xu, and Lei Xie, “Contextualized end-to-end speech recognition with contextual phrase prediction network,” in Annual Conference of the International Speech Communication Association, INTERSPEECH 2023, 2023, pp. 4933–4937.[5] Minglun Han, Linhao Dong, Shiyu Zhou, and Bo Xu, “Cif-based collaborative decoding for end-to-end contextual speech recognition,” in IEEE International Conference on Acoustics, Speech and Signal Processing, ICASSP 2021. 2021, pp. 6528–6532, IEEE.[6] Zhanheng Yang, Sining Sun, Xiong Wang, Yike Zhang, Long Ma, and Lei Xie, “Two stage contextual word filtering for context bias in unified streaming and nonstreaming transducer,” in Annual Conference of the International Speech Communication Association, INTERSPEECH 2023, pp. 3257–3261.[7] Yaoxun Xu, Baiji Liu, Qiaochu Huang, Xingchen Song, Zhiyong Wu, Shiyin Kang, and Helen Meng, “Cbconformer: Contextual biasing conformer for biased word recognition,” in IEEE International Conference on Acoustics, Speech and Signal Processing, ICASSP 2023, 2023.[8] Zhengkun Tian, Jiangyan Yi, Jianhua Tao, Ye Bai, Shuai Zhang, and Zhengqi Wen, “Spike-triggered nonautoregressive transformer for end-to-end speech recognition,” in Annual Conference of the International Speech Communication Association, INTERSPEECH 2020, Helen Meng, Bo Xu, and Thomas Fang Zheng, Eds. 2020, pp. 5026–5030, ISC 
 西工大音频语音与语言处理研究组