
 西工大音频语音与语言处理研究组
风格语音转换(Stylistic Voice Conversion)旨在将源语音的风格转换为目标风格。当前大多数风格语音转换方法依赖于预定义的标签或参考语音来控制风格转换过程,这导致了风格多样性受限以及风格表示的直观性和可解释性方面存在不足。为了解决上述问题,西工大音频语音与语言处理研究组和喜马拉雅合作的论文PromptVC被ICASSP2024接收,该论文提出了一种基于潜在扩散模型(LDM)的风格语音转换方法,采用潜在扩散模型生成由自然语言提示(Prompt)驱动的风格向量。在训练期间,风格向量由风格编码器提取,然后独立训练LDM从噪声中对风格向量进行采样,该过程以自然语言描述作为条件。为了提高风格转换的表现力,利用HuBERT提取离散Token,并用K-Means中心簇替换离散Token作为语言内容,从而最小化源语音中的残余风格信息。此外去重相同的离散Token,并使用可微的时间预测器重新预测每个标记的时长,以适应相同语言内容在不同风格下的时长。主观和客观实验结果表明了本文提出的方法的有效性。现对该论文进行解读。
论文题目:PromptVC: Flexible Stylistic Voice Conversion in Latent Space Driven by Natural Language Prompts
合作单位:喜马拉雅
作者列表:姚继珣,杨宇光,雷怡,宁子谦,胡彦妮, 潘宇,印晶晶,周鸿斌,卢恒,谢磊
论文原文:https://arxiv.org/abs/2309.09262
样例网址:https://yaoxunji.github.io/prompt_vc/
为了以直观方式灵活控制风格转换,我们提出了一种利用潜在扩散模型以自然语言提示为条件生成风格向量风格语音转换方法—PromptVC。主体框架是端到端的VC模型,用来重构受风格编码器控制的目标波形。同时训练潜在扩散模型从噪声中采样风格编码器的输出。在推理过程中,潜在扩散模型受自然语言提示的引导,生成目标风格向量,然后转换模型根据生成的风格向量生成转换后的语音。同时,为了有效地最小化语言内容中的残余风格信息,我们利用HuBERT+Kmeans从源语音中提取离散标记。然后,通过可微分的时长预测器,对这些标记进行去重和预测每个标记的持续时间。此外,我们用K-Means中心嵌入替代离散标记,这些嵌入包含有关语言内容的更多相对位置信息,有助于缓解变调的问题。我们还引入了一个韵律编码器,以捕捉音素级韵律表示,以实现更好的韵律建模和更自然的语音。
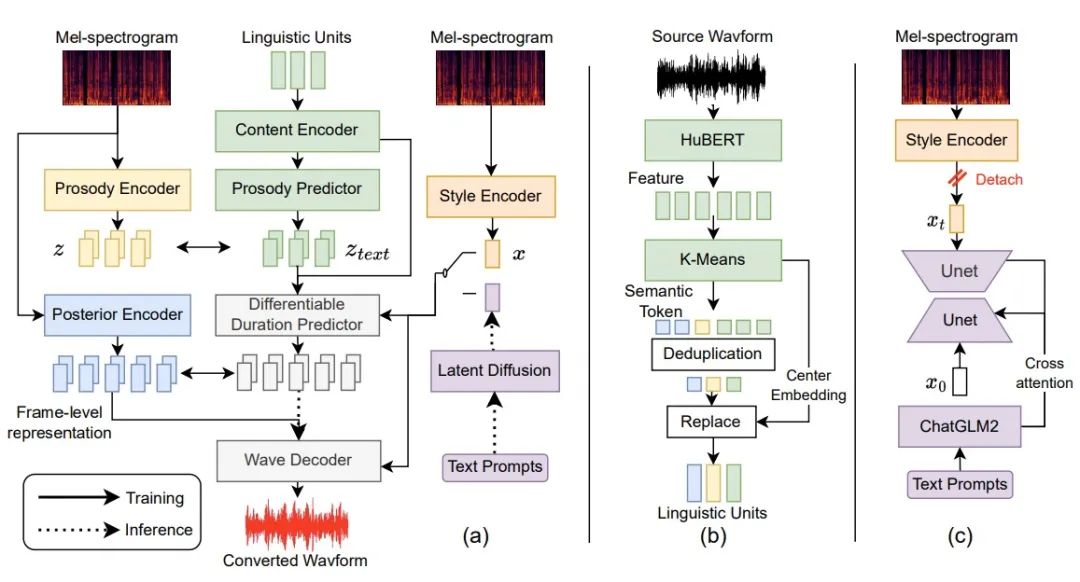
图3 PrmoptVC结构图,子图 (a) 描述了 PromptVC 的架构,实线表示训练阶段,虚线表示推理阶段。子图 (b) 和 (c) 分别说明了语言单元提取的过程和潜在扩散模型的训练过程
为了高效减少语言内容中的残余风格信息,我们引入了一种新颖的语言内容提取方法,利用离散标记从源语音中解耦语言内容并最小化残余的风格信息,如图3(b)所示。离散标记通常称为语义标记,是使用预训练的HuBERT模型和K-Means聚类模型从源语音中提取的。我们利用HuBERT的最终层对K-Means模型进行聚类。与传统的音素后验概率图(PPG)相比,包含更少的内容无关信息。此外,相同语言内容在不同风格下的持续时间可能存在变化。然而,传统的语音转换将语音处理成与原始语音相同的时长。为了适应不同的风格表达,我们对相同的语义标记进行去重,目的是使用时长预测器预测每个标记的持续时间。为了避免发音问题,我们用相应的中心嵌入替换去重的标记,表示为语言单元。与离散去重标记相比,语言单元包含更多的相对位置信息,有助于最小化来自原始风格的残余信息,并且可以在不同的风格条件下转换为不同的时长。
潜在扩散模型
实验数据
我们使用一个内部的中文多说话表现力语料库来训练 VC 模型。该语料库包含 400 小时的语音数据,采样率为 24kHz。从这个语料库中,我们选择了 50,000 个包含一系列语音特色的句子,包括六种情感、两种不同场景(新闻和小说)以及六种不同音色(三男三女)。随后,我们邀请了 13 名专业标注者为这 50,000 个句子提供自然语言提描述,以训练潜在扩散模型。
基线模型和验证指标
对比的基线系统包含两个:第一个基线系统是 StyleSpeech [9],我们将原始音素输入替换为我们方法中使用的语言单元。第二个基线系统称为 MixEmo [10],它采用了一种排序方法来表示与情感或风格相关程度的度量。
为了解决上述问题,西工大音频语音与语言处理研究组和喜马拉雅联合推出PromptVC,该工作近日被语音研究顶级会议ICASSP2024接收。该论文提出了一种基于潜在扩散模型(LDM)的风格语音转换方法,采用潜在扩散模型生成由自然语言提示(Prompt)驱动的风格向量。
实验结果
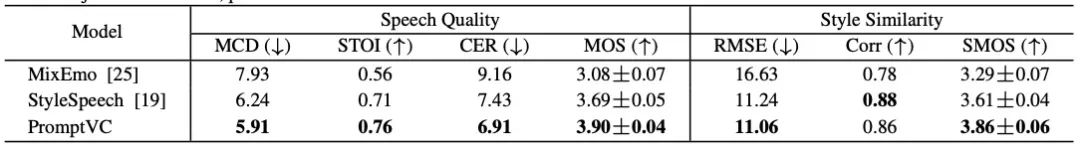
由于基线系统利用参考语音进行风格语音转换,我们首先研究了使用参考语音的 PromptVC 的性能,结果如表1所示。在语音质量方面,PromptVC 实现较低的 MCD 和 CER 分数以及较高的 STOI 结果,超越了基线系统。此外,MOS 结果表明,PromptVC 在音质方面表现更好。这些结果表明了 PromptVC 在语音质量上优于基线系统。
另一方面,PromptVC 在 RMSE 和 SMOS 性能方面表现出色,特别是与 MixEmo 相比。而 PromptVC 的音高相关性结果为 0.86,与 StyleSpeech 中观察到的 0.88 相近。此外,PromptVC 的 SMOS 结果明显优于两个基线系统。这表明由 PromptVC 生成的转换语音在风格上与目标语音更相似。
基于上述观察,PromptVC 在使用参考语音进行风格语音转换方面表现优异。因此,我们继续进行ABX偏好测试,旨在比较在我们提出的系统中使用参考语音与使用自然语言提示进行风格语音转换的性能。ABX偏好测试的结果显示在图4 中,在风格相似性测试中,结果显示52.6%的结果表示“无偏好”,而19.6%的结果更喜欢“Prompts”。这些结果表明,PromptVC有效地实现了由自然语言提示引导的风格控制目标,实现了对风格表达的精确控制。我们还评估了生成语音与地面真实样本之间语音质量的接近程度。结果显示Reference和Prompts偏好的百分比分别为18.8%和17.3%。这表明由自然语言描述控制的风格语音转换也可以生成高质量的语音。
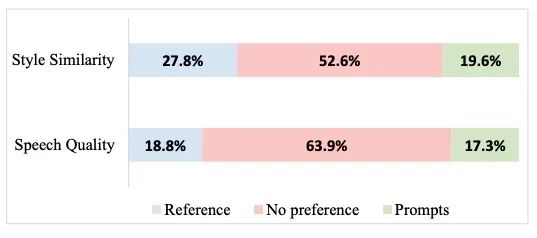
图4 ABX偏好测试结果
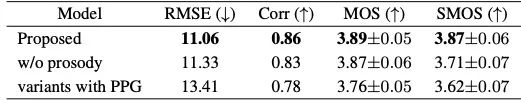
由于风格解耦和韵律建模在风格语音转换中起着重要作用,我们将提出的语言单元替换为传统使用的PPG并移除韵律编码器来进行消融研究。从表2的结果中我们可以得出以下结论:(1) 在删除韵律编码器的情况下,SMOS结果低于我们提出的系统。这突显了韵律编码器在提高风格相似性和生成语音自然度方面的贡献。(2) 当语言表征从我们提出的语言单元切换到PPG时,观察到SMOS、RMSE和Corr值的显著下降。这表明我们提出的方法具有更优越的解耦性能,能够有效地减少语言内容中的残余风格信息。在语言内容中保留原始风格信息会导致生成语音中风格相似性降低。消融研究结果进一步证明了PromptVC中每个组件的有效性。
[1]Berrak Sisman, Junichi Yamagishi, Simon King, and Haizhou Li, “An overview of voice conversion and its challenges: From statistical modeling to deep learning,” IEEE/ACM Trans. Audio Speech Lang. Process., vol. 29, pp. 132–157, 2020.
[2]Kun Zhou, Berrak Sisman, Mingyang Zhang, and Haizhou Li, “Converting anyone’s emotion: Towards speaker-independent emotional voice conversion,” in Proc. INTERSEPEECH, 2020, pp. 3416–3420.
[3]Andy T. Liu, Po-Chun Hsu, and Hung-yi Lee, “Unsupervised end-to-end learning of discrete linguistic units for voice conversion,” in Proc. INTERSEPEECH, 2019, pp. 1108–1112.
[4]Carl Robinson, Nicolas Obin, and Axel Roebel, “Sequence-to-sequence modeling of F0 for speech emotion conversion,” in Proc. ICASSP, 2019, pp. 6830-6834.
[5]Nirmesh Shah, Mayank Singh, Naoya Takahashi, and Naoyuki Onoe, “Nonparallel emotional voice conversion for unseen speaker-emotion pairs using dual-domain adversarial network virtual domain pairing,” in Proc. ICASSP, 2023, pp. 1–5.
[6]Kun Zhou, Berrak Sisman, Rui Liu, and Haizhou Li, “Seen and unseen emotional style transfer for voice conversion with A new emotional speech dataset,” in Proc. ICASSP, 2021, pp. 920–924.
[7]Manuel Sam Ribeiro, Julian Roth, Giulia Comini, Goeric Huybrechts, Adam Gabrys, and Jaime Lorenzo-Trueba, “Crossspeaker style transfer for text-to-speech using data augmentation,” in Proc. ICASSP, 2022, pp. 6797–6801.
[8]Zhichao Wang, Qicong Xie, Tao Li, Hongqiang Du, Lei Xie, Pengcheng Zhu, and Mengxiao Bi, “One-shot voice conversion for style transfer based on speaker adaptation,” in Proc. ICASSP, 2022, pp. 6792–6796.
[9]Kun Zhou, Berrak Sisman, Carlos Busso, and Haizhou Li, “Mixed emotion modeling for emotional voice conversion” arXiv preprint arXiv:2210.13756, 2022.
[10]Dongchan Min, Dong Bok Lee, Eunho Yang, and Sung Ju Hwang, “Meta-stylespeech: Multi-speaker adaptive text-to-speech generation,” in Proc. ICML, 2021, pp. 7748–7759.
