期刊介绍:IEEE Signal Processing Letters (影响因子: 3.9) 是一本旨在快速传播原创的、前沿的思想和及时的重要贡献的期刊,涵盖了信号处理、图像处理、语音处理、语言处理和音频处理等领域。
论文题目:IIFC-Net: A Monaural Speech Enhancement Network with High-Order Information Interaction and Feature Calibration作者列表:魏文炳,胡英*,黄浩,何亮
单位:新疆大学计算机科学与技术学院、清华大学电子工程系
论文链接:https://ieeexplore.ieee.org/abstract/document/10352601
研究背景
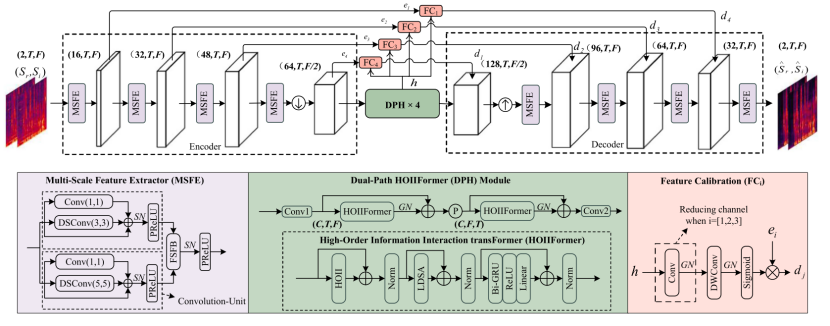
最近,许多基于Transformer[1]风格的双路径模型在语音增强方面取得了令人印象深刻的表现。然而,它们的高参数量和高计算复杂性阻碍了它们的实际应用。在本文中,我们提出了一个基于高阶信息交互和特征校准的低参数量、低复杂度的单通道语音增强网络(IIFC-Net)。该网络包括高阶信息交互Transformer(HOIIFormer),其中使用高阶信息交互(HOII)模块代替 Transformer 中的多头自注意力。IIFC-Net利用双路径HOIIFormer模块分别沿时间维度和频率维度对远程依赖关系进行建模,并通过HOII模块有效捕获深层信息。我们还设计了一个特征校准(FC)模块来增强目标语音的频率成分,并通过可视化分析进行了验证。
图1展示了IIFC-Net的整体架构,它由一个编码器、四个双路HOIIFormer模块,四个FC模块和一个解码器组成。首先将混合语音的复频谱图送入编码器。该编码器由四层多尺度特征提取(MSFE)模块和一个将特征映射的频率维度减半的下采样操作组成。随后,将特征映射传递给四个连续的双路HOIIFormer模块,每个模块依次沿着时间维度和频率维度对上下文信息建模。四个连续的双路HOIIFormer模块的最终输出分别馈送到四个FC模块中,以校准编码器中每个MSFE的输出。校正后的特征与前一个MSFE模块的输出沿着通道维度进行连接,然后馈送到解码器中相应的MSFE模块中。最后,通过短时傅里叶逆变换(ISTFT)重建目标语音波形。
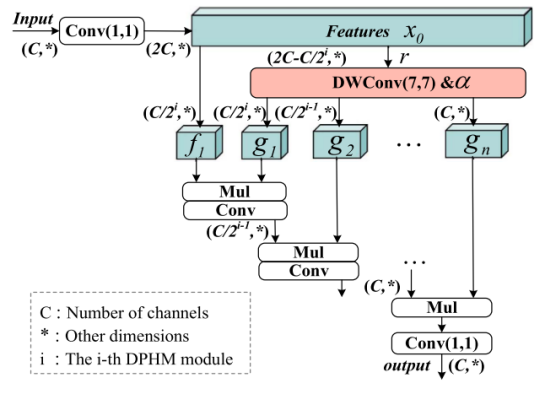
图2. HOII模块的结构示意图
基于Transformer风格的双路径网络可以有效地对帧间和帧内信息进行建模。然而,Transformer中的MHSA表现出二次复杂度,并且仅限于二阶空间信息交互。为了解决这些困难并有效利用基于Transformer风格的双路径网络的优势,我们提出了一个执行高阶信息交互的HOII模块来代替MHSA。如图2所示,输入x经过一个二维卷积进行升通道。随后,沿着通道维度将其分为f1和r,i表示DPH模块的第i层。为了更好地捕获频谱中的上下文信息,采用卷积核大小为(7,7)的深度卷积(DWConv)对特征r进行建模。将DWConv的输出沿着通道维度进一步划分为n个子特征,然后f1与g1进行逐元素相乘,相乘后经过卷积提升通道。最终的输出与g2进行相同的操作,以此类推。在HOII块中,每个门控卷积操作可以视为频谱中不同空间信息之间的相互作用。通过这种相互作用,目标语音的相关特征得到进一步增强,而不相关的噪声特征被削弱。通过多次交互,获得的深层特征包含了更丰富的全局信息,有助于提高网络的建模能力。
FC模块
为了在解码器中恢复目标语音的细粒度信息,我们引入了从编码器到解码器的跳跃连接。然而,在编码器中,由MSFE模块的每一层提取的特征包含不同程度的干扰,如果直接输入到解码器中,可能会影响目标语音的正确重建。所以我们提出了FC模块,利用从四个连续的DPH模块中获得的深层特征h分别校准浅层特征ei, i∈{1,2,3,4}。FC的细节如图1所示。为了匹配特征ei的通道维度,FCi首先利用核大小为(1,1)的二维卷积层来减少h的通道数。该二维卷积层的输出经过核大小为(3,3)的DWConv,再经过GN和sigmoid激活操作,得到权重矩阵w。我们可以通过w和ei的元素相乘得到校准后的特征。下面,我们将对FC的能力进行可视化分析,图3(a)和(b)分别显示了e4和d1的频谱图。可以直观地看到,在FC块的校准下,d1的特征映射在频谱中降低了噪声分量,同时增强了目标语音的谐波分量。
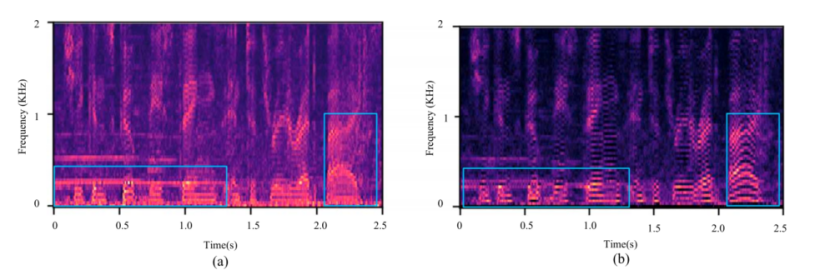
图3. 可视化分析。(a)和(b)分别表示编码器中第4层MSFE的输出,e4,和相对应的FC模块的输出,d1。
实验结果
我们全部的实验分别在VoiceBank+DEMAND (VCTK)[2]数据集和WHAMR![3]数据集上完成。
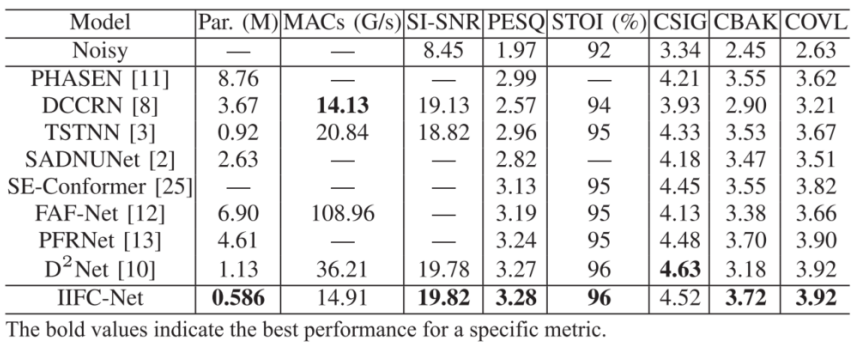
我们分别在VCTK数据集和WHAMR!数据集上验证了IIFC-Net的去噪能力和同时去噪去混响能力。表1. 在VCTK数据集上与其他模型的去噪性能比较
表2. 在WHAMR!数据集上与其他模型的去噪去混响性能比较
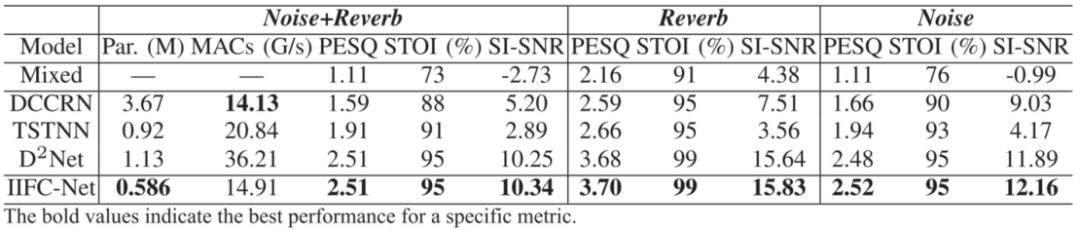
我们首先在VCTK数据集上与7种基线方法进行了降噪性能比较,如表1所示。所提出的IIFC-Net在评估指标上的性能优于所有基线,并且参数仅为0.586 M。此外,与同样采用Transformer风格的双路径结构的TSTNN和D2Net相比,IIFC-Net在参数量和MACs都较低的情况下取得了良好的效果,使其更适合嵌入式系统。我们还在WHAMR!数据集上与3种基线方法进行了去噪和去混响性能的比较。如表2所示,IIFC-Net在所有三种测试场景(仅存在噪声、仅存在混响和同时存在噪声与混响干扰)上均优于其他基线方法。
为了探究IIFC-Net中一些模块设计的有效性,我们在 VCTK数据集上进行了消融实验。表3. 在VCTK数据集上的消融实验
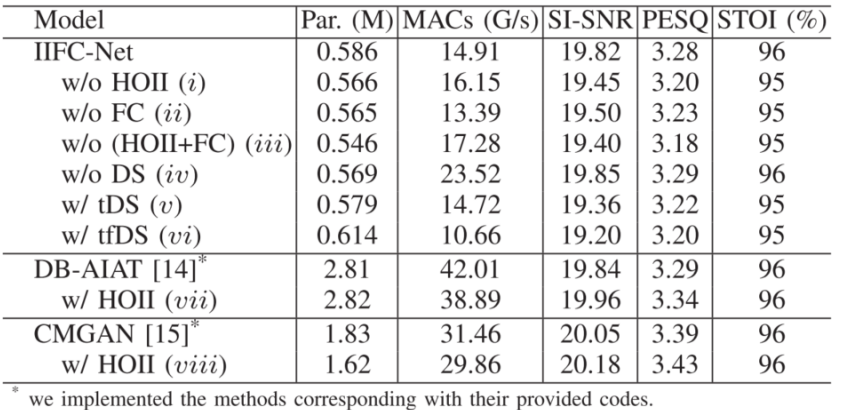
如表3所示,(i)、(ii)和(iii)分别表示用MHSA代替HOII、移除FC块、同时移除FC块和用MHSA代替HOII。去除HOII模块 (i)后,PESQ降低0.08,MACs增加1.22。这表明,与MHSA相比,HOII不仅降低了复杂性,而且提高了对全局信息的建模能力。(vii)和(viii)表示DB-AIAT[4]和CMGAN[5]这两种基于Transformer的方法中MHSA被HOII取代,从实验结果可以看出我们提出的HOII模块具有很好的泛化能力。从操作(ii)的结果以及图三 (a)和(b)的对比中,我们可以验证FC模块的有效性。编码器中的最后一个操作是下采样(DS),为了探索该操作对语音增强模型的影响,我们进行了以下消融实验:(iv),(v)和(vi)分别对应于不进行下采样,仅沿T维度进行下采样,以及沿T维度和F维度进行下采样。结果表明,对于语音增强模型,沿频率维度执行一次DS是首选策略。
[1] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N Gomez, Lukasz Kaiser, and Illia Polosukhin, “Attention is all you need,” Advances in neural information processing systems, vol. 30, 2017.[2] C. Valentini-Botinhao, X. Wang, S. Takaki, and J. Yamagishi, “Investigating RNN-based speech enhancement methods for noise-robust text-tospeech,” in Proc. 9th ISCA Speech Synth. Workshop, 2016, pp. 146–152.[3] M. Maciejewski, G. Wichern, E. McQuinn, and J. Le Roux, “WHAMR!: Noisy and reverberant single-channel speech separation,” in Proc. IEEE Int. Conf. Acoust. Speech Signal Process., 2020, pp. 696–700.[4] G. Yu, A. Li, C. Zheng, Y. Guo, Y. Wang, and H. Wang, “Dual-branch attention-in-attention transformer for single-channel speech enhancement,” in Proc. IEEE Int. Conf. Acoust. Speech Signal Process., 2022, pp. 7847–7851.[5] R. Cao, S. Abdulatif, and B. Yang, “CMGAN: Conformer-based metricGAN for monaural speech enhancement,” in Proc. Interspeech, 2022, pp. 936–940.
 语音小管家