
 语音小管家
2023年被大家称为人工智能元年,在GPT技术不断爆火的背景下,人工智能技术也在不断的发展和演化。各种AI工具也层出不穷,其中 语音克隆技术 也是尤为引人瞩目的产品之一。
而OpenVoice作为一款强大的多语言即时语音克隆AI工具,可以为用户提供高效、个性化的语音克隆服务,是一款值得推荐的项目。
项目介绍
其核心功能是通过提供发言者的短音频片段(参考语音),实现声音的高效克隆。
这意味着您可以使用OpenVoice来克隆任何人的声音,而且不限于特定语言。无论您是想要模仿某位名人的声音,还是需要在不同语言之间进行语音转换,OpenVoice都能够满足您的需求。
项目地址:https://github.com/myshell-ai/OpenVoice
特色功能:
准确的音色克隆:OpenVoice 可以准确克隆参考音色并生成多种语言和口音的语音。
灵活的音色控制:OpenVoice 可以对语音风格(例如情感和口音)以及其他风格参数(包括节奏、停顿和语调)进行精细控制。
零样本跨语言语音克隆:生成语音的语言和参考语音的语言都不需要出现在大规模说话人多语言训练数据集中。
项目贡献开发者:
秦增一,麻省理工学院&MyShell
赵文亮,清华大学
于绪敏,清华大学
Ethan Sun,MyShell
如何使用它?
提前创建好Python3.9及以上的虚拟环境
gitclonehttps://github.com/myshell-ai/OpenVoice.git 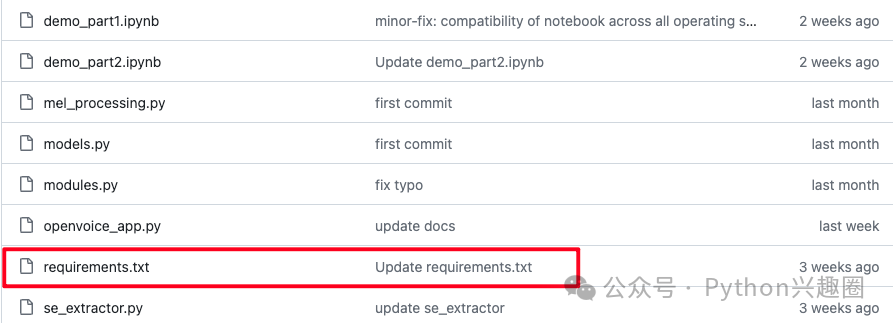
pip install -r requirements.txt 模型包下载需要魔法,小编已提前准备好,如无法下载可在公众号内回复 ov模型获取!
import os
import torch
import se_extractor
from api import BaseSpeakerTTS, ToneColorConverter

ckpt_converter = 'checkpoints/converter'
# 使用GPU进行计算
device = 'gpu'
output_dir = 'outputs'

# 加载基础模型
tone_color_converter = ToneColorConverter(f'{ckpt_converter}/config.json', device=device)
tone_color_converter.load_ckpt(f'{ckpt_converter}/checkpoint.pth')
# 创建输出目录
os.makedirs(output_dir, exist_ok=True)
# 训练音频
reference_speaker = 'resources/example_reference.mp3'
target_se, audio_name = se_extractor.get_se(reference_speaker, tone_color_converter, target_dir='processed', vad=True)
# TTS配置
ckpt_base = 'checkpoints/base_speakers/ZH'
base_speaker_tts = BaseSpeakerTTS(f'{ckpt_base}/config.json', device=device)
base_speaker_tts.load_ckpt(f'{ckpt_base}/checkpoint.pth')
source_se = torch.load(f'{ckpt_base}/zh_default_se.pth').to(device)
save_path = f'{output_dir}/output_chinese.wav'
text = "今天是1月26号,早安!"
src_path = f'{output_dir}/tmp.wav'
# TTS转换,speed为语速
base_speaker_tts.tts(text, src_path, speaker='default', language='Chinese', speed=0.9)
# 数字水印内容
encode_message = "@Python_fy"
# 运行转换
tone_color_converter.convert(
    audio_src_path=src_path,
    src_se=source_se,
    tgt_se=target_se,
    output_path=save_path,
message=encode_message) def load_model(path="default"):
if path == "default":
# resume_path = hf_hub_download(repo_id="M4869/WavMark",
# filename="step59000_snr39.99_pesq4.35_BERP_none0.30_mean1.81_std1.81.model.pkl",
# )
resume_path = "C:/Users/Number/.cache/huggingface/hub/models--M4869--WavMark/step59000_snr39.99_pesq4.35_BERP_none0.30_mean1.81_std1.81.model.pkl"
model = my_model.Model(16000, num_bit=32, n_fft=1000, hop_length=400, num_layers=8)
checkpoint = torch.load(resume_path, map_location=torch.device('cpu'))
model_ckpt = checkpoint
model.load_state_dict(model_ckpt, strict=True)
model.eval()
return model Traceback (most recent call last):
File "C:\Python39\lib\site-packages\whisper_timestamped\transcribe.py", line 1885, in get_vad_segments
_silero_vad_model, utils = torch.hub.load(repo_or_dir=repo_or_dir, model="silero_vad", source=source)
File "C:\Python39\lib\site-packages\torch\hub.py", line 539, in load
repo_or_dir = _get_cache_or_reload(repo_or_dir, force_reload, trust_repo, "load",
...省略若干调用链...
File "C:\Python39\lib\http\client.py", line 289, in _read_status
raise RemoteDisconnected("Remote end closed connection without"
http.client.RemoteDisconnected: Remote end closed connection without response ov模型获取!应用场景
个性化语音助手:定制属于自己的个性化语音助手,为用户提供更加亲切贴心的服务体验。
语音内容创作:为视频、广播等内容创作提供真实、个性化的配音声音。
语音合成应用:用于各类语音合成应用领域,如教育、娱乐等。
