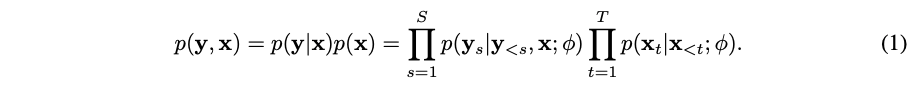我们介绍了一个文本到语音(TTS)模型,称为BASE TTS,它代表具有涌现能力的大自适应流TTS。 BASE TTS是迄今为止最大的TTS模型,在10万小时 的公共领域语音数据上进行了训练,实现了语音自然度的新技术。 它部署了一个10亿个参数的自回归transformer,将原始文本转换为离散codes(“speechcodes ”),然后是一个基于卷积的解码器,该解码器以增量的、可流的 方式将这些 speechcodes 转换为波形。 此外,我们的语音编码是使用一种新颖的 speech tokenization 技术构建的,该技术具有说话人ID解纠缠和字节对编码(BPE)压缩的特点。 与广泛报道的大型语言模型在不断增加的数据量上训练时的“涌现能力” 相呼应,我们表明,使用10K+小时和500M+参数 构建的BASE TTS变体开始在文本复杂句子上表现出自然韵律。 我们设计并共享了一个专门的数据集来衡量文本到语音的这些突发能力。我们通过对基线(包括公开可用的大规模文本到语音系统:YourTTS、Bark和TortoisetsTTS进行评估,展示了BASE TTS的最先进的自然性。
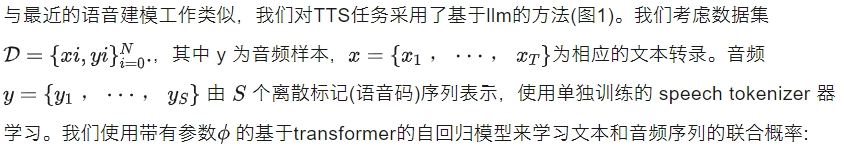
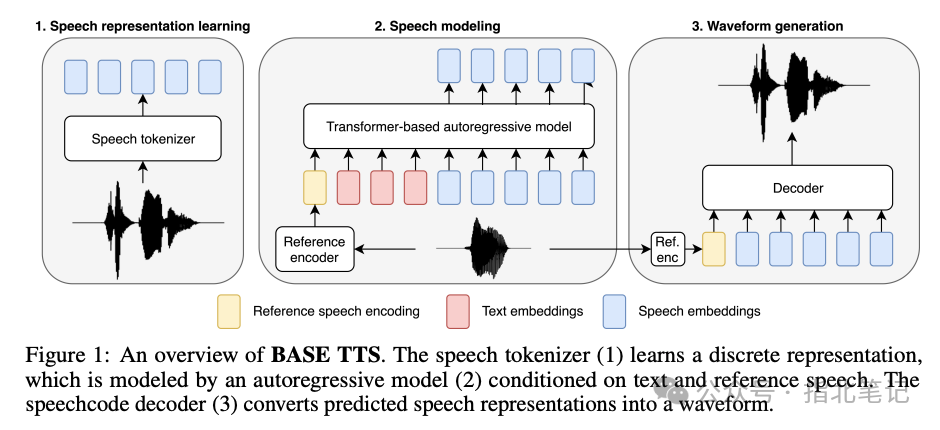
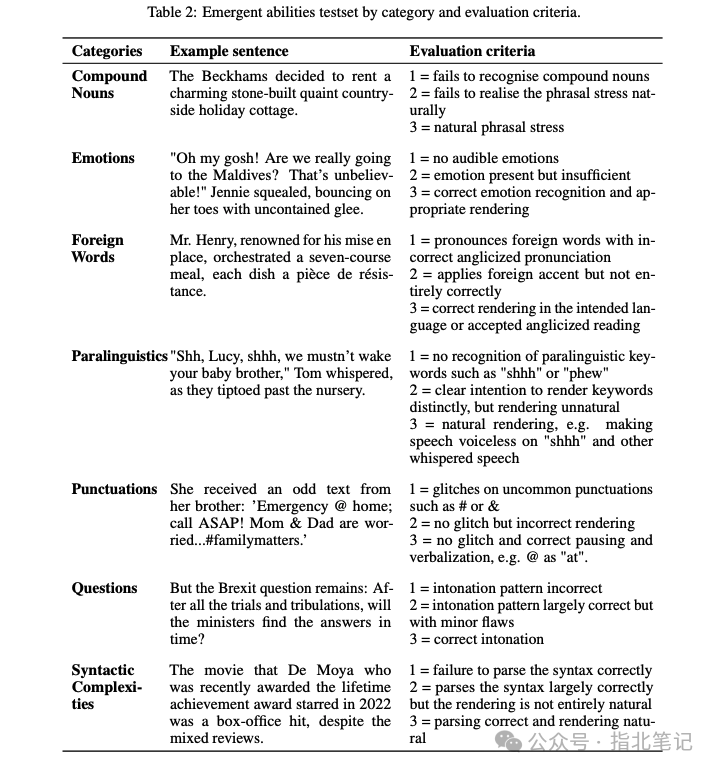
Introduction 生成式深度学习模型正在快速发展。自然语言处理(NLP)和计算机视觉(CV)正在经历一个根本性的转变,从具有监督训练的专业模型,到可以在有限的明确指令下完成各种任务的广义模型。 在NLP中,问答、情感分析和文本摘要等任务现在可以由大型语言模型(LLM)执行,而LLM并不是专门针对这些任务的。 在CV中,从数以亿计的图像标题对中学习的预训练模型在图像到文本的基准测试中取得了最佳性能,同时在文本到图像的任务中提供了非常逼真的结果。 这一进步是由基于transformer的架构实现的,它使用比以前的模型多出许多数量级的数据来推动改进。 类似的进步现在也出现在语音处理和文本到语音(TTS)领域,利用数千小时数据的模型推动合成更接近人类的语音。 在第5节中深入描述的其中一些模型依赖于因果语言建模任务,如AudioLM或VALL-E,而其他模型则使用非因果模块,如SoundStorm或SpeechX,或扩散解码器。 直到2022年,领先的Neural TTS模型几乎完全是在几百小时的录制音频上进行训练的。这样的系统可以为目标说话者创造出发音清晰、偶尔具有表现力的语音,但通常无法推广到少量训练数据之外,从而呈现出具有真正表现力的模糊复杂文本。为了达到如此高水平的表达能力,TTS系统过去不得不依赖于特定语音现象的标记数据集;即便如此,为某些类型的文本输入实现类似人类的韵律仍然是难以捉摸的。例如,在英语中,如果没有准确的句法解析和语义理解,复合名词和疑问句就很难正确呈现。 本文介绍了具有涌现能力的大型自适应流TTS。它是一个多语言、多说话的大型TTS (LTTS)系统,在大约100K小时的公共领域语音数据上训练(是之前[17]的两倍)。 BASE TTS遵循将TTS作为下一个令牌预测问题 的方法,受到LLM成功的启发。这种方法通常与大量的训练数据相结合,以实现强大的多语言和多说话者能力(例如一次语音克隆)。我们的目标是提高TTS的总体质量,并研究缩放如何影响模型为具有挑战性的文本输入产生适当韵律和表达的能力,类似于LLM如何通过数据和参数缩放获得新能力,这种现象在LLM文献中被称为“涌现”或“涌现能力”。[32]将大型语言模型的突发能力定义为“在小规模模型中不存在但在大规模模型中存在的能力”;例如,他们表明,在一系列少数射击任务中,模型能力从10^18到10^22训练FLOPs保持在较低水平,但从10^22到10^24进行了剧烈的跳跃。为了验证这一假设也适用于LTTS,我们提出了一个评估方案来评估LTTS中潜在的突发能力,并从文献中确定了七个具有挑战性的类别[27-31]:**复合名词(compound nouns)、情感(emotions)、外来词(foreign words)、副语言学(paralinguistics)、标点(punctuations)、疑问句(questions)和句法复杂性(syntactic complexities)**。详见3.3节。 我们设计BASE TTS来模拟文本令牌的联合分布,然后是离散的语音表示,我们称之为speechcodes 。通过 audio codecs 对语音进行离散化是我们设计的核心 ,因为它可以直接应用为llm开发的方法,这些方法是最近LTTS工作的基础。 具体来说,我们使用具有交叉熵训练目标的仅解码器自回归transformer对speechcodes进行建模 。尽管它很简单,但该目标可以捕获表达性语音的复杂概率分布,从而缓解早期神经TTS系统中出现的过平滑问题 。作为一种隐式语言模型,一旦在足够的数据上训练了足够大的变体,BASE TTS在韵律呈现方面也会有质的飞跃。 此外,我们提出了建立在WavLM自监督学习(SSL)语音模型之上的 speaker-disentangled speechcodes。我们遵循[16],其中引入了通过离散激活SSL模型构建的语义tokens 。我们将这种方法扩展到更好地控制由 speechcodes 捕获的信息。我们的策略是将自回归语音编码预测器(“speechGPT”)的职责限制为分段内容、韵律和持续时间 ,同时指定一个独立的 speechcode-to-waveform 解码器(称为“speechcode decoder”),重建说话者身份和记录条件。我们表明,这种基于卷积的 speechcode decoder 具有计算效率,与基于扩散的解码器基线相比,将整个系统的合成时间减少了70%以上。 我们介绍了BASE TTS,据我们所知,这是迄今为止最大的TTS模型,具有1B个参数,并在由10万小时公共领域语音数据组成的数据集上进行了训练。在主观评估中,BASE TTS比公开可用的LTTS基线模型表现得更好。 我们演示了如何将BASE TTS扩展到更大的数据集和模型大小,以提高其为复杂文本呈现适当韵律的能力 。为此,我们开发并提供了一个“涌现能力”测试集,它可以作为大规模TTS模型的文本理解和渲染的主观评估基准。我们在此基准测试中报告了BASE TTS不同变体的性能,显示随着数据集大小和参数数量的增加,质量有单调的提高。 我们引入了建立在 WavLM SSL 模型之上的新颖的离散语音表示 ,旨在仅捕获语音信号的 phonemic 和 prosodic 信息。我们证明,这些表示优于基线量化方法。我们还表明,尽管压缩率很高(仅400比特/秒),但它们可以用简单,快速和可流式 的解码器解码为高质量的波形。 BASE TTS Overview 预测的 speech tokens 与 speaker embeddings 连接,并使用由线性层和卷积层组成的单独训练的 speechcode decoder 解码成波形。
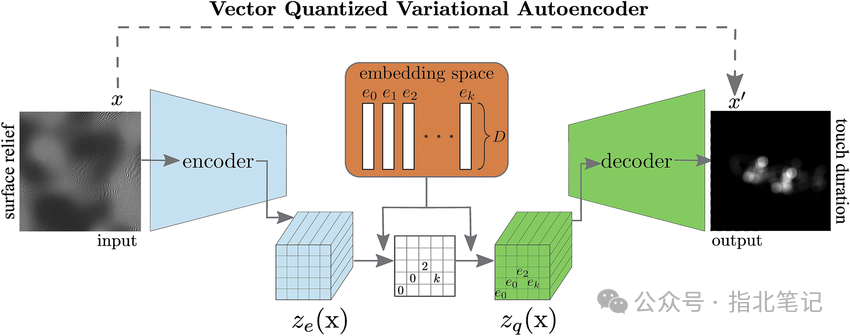
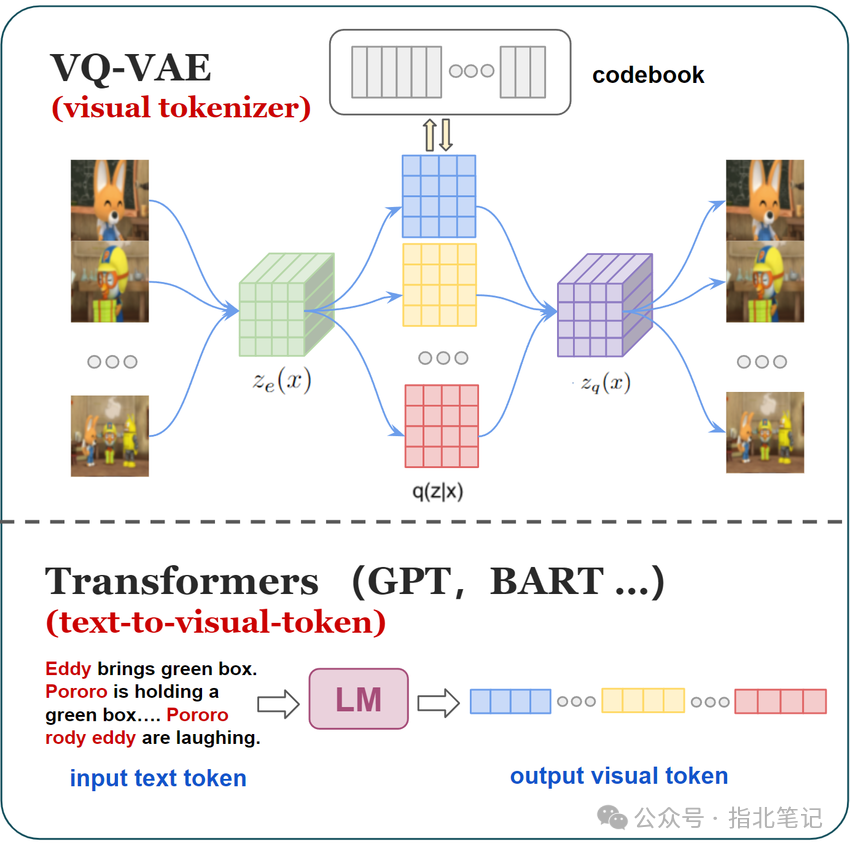
Discrete speech representations 离散表示是LLM成功的基础,但在语音中识别紧凑且信息丰富的表示不如在文本中那么明显,并且探索较少 。对于BASE TTS,我们首先使用 Vector Quantized Variational Autoencoder(VQ-VAE )基线进行实验,其中基于自编码器的架构通过 discrete bottleneck 重建 mel-spectrograms ,如第2.2.1节所述。VQ-VAE是语音和图像表示的成功范例,尤其是作为TTS的建模单元。 然而,在第2.2.2节中,我们介绍了一种通过基于wavlm的语音编码学习语音表示的新方法。在该方法中,我们将从WavLM SSL模型中提取的离散化特征以重建 mel-spectrogram 。我们使用额外的损失函数来促进speaker disentanglement ,并使用字节对编码(BPE)压缩产生的语音编码来减少序列长度 ,使我们能够用 transformer 建模更长的音频。 这两种表示都被压缩 (分别为325 bits/s 和400 bits/s ),与流行的音频 codecs (例如[17]中的6k比特/秒)相比,允许更有效的自回归建模。通过这种级别的压缩,我们的目标是从语音编码中去除可以在解码过程中重构的信息(speaker,audio noise等),以确保 speechcodes 的容量主要用于编码 phonetic 和 prosodic 信息 。
Autoencoder-based speech tokens 我们的基线离散化方法是一个经过训练的VQ-VAE来重建mel谱图。编码器和解码器是带有残差连接的卷积神经网络,将语音表示下采样到25Hz的频率。为了(部分地)将说话人信息从语音表示中分离出来,我们引入了一个全局参考编码器。该编码器学习一个固定大小的话语级表示,在使用VQ-VAE解码器重建之前将其连接到语音编码。
从非正式听力中,我们发现基于自编码器的speech tokenizer 产生的 speechcode仍然包含说话人信息 。这促使我们开发具有改进的说话人解纠缠的表征。
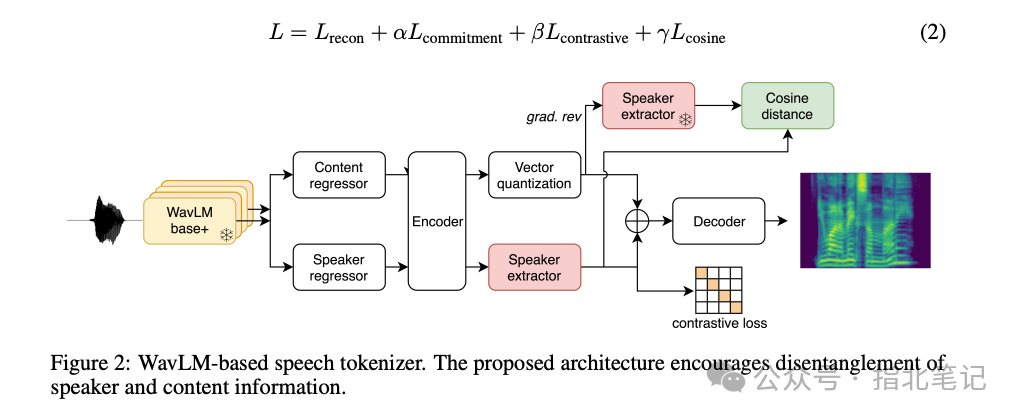
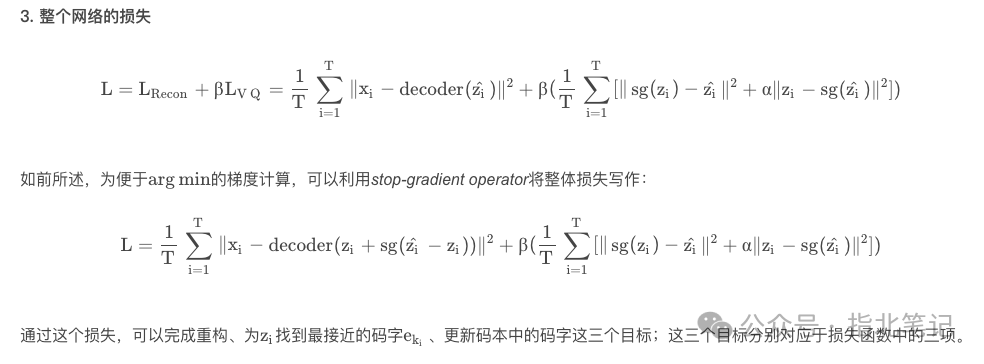
WavLM-based speechcodes 我们的目标 是开发包含 phonetic 和 prosodic 信息的 speechcode,但这些语音编码不受说话人身份、录音条件和音频信号中其他虚假特征的干扰 。 为此,我们引入了一种基于从预训练的 WavLM 模型中提取的特征的 speech tokenizer,该模型进一步使用损失进行训练,以鼓励分离说话者身份 。我们的方法类似于[43]中引入的方法,并进行了修改,降低了代码的比特率 。speech tokenizer 的整体架构如图2所示。 我们首先将波形通过WavLM模型并提取隐藏状态。这些隐藏状态然后通过单独的content 和speaker 线性回归器 传递。然后将这些回归器的输出送入卷积残差编码器 [44]。内容编码通过vector quantization 模块传递,该模块为每一个WavLM帧(即20ms的语音)输出一个 speechcodes 。 speaker encodings 通过基于transformer的 speaker extractor[15]来获得 speaker embedding。模型只提取,我们只使用不能用于 identification 的非特定特征。 speaker embeddings 与 speechcodes 连接,并使用 convolutional decoder 解码成 spectrogram。然后,我们计算解码和目标谱图之间的L1距离 ,并将其用作重建损失 。虽然L1不是最优重建目标,但我们优先考虑了有利于自回归建模的表征[45],并相应地证明,当使用我们的 speechcode decoder 对学习到的表征进行解码时,最终的音频质量可以保持在很高的水平 ,参见第2.4节。 speaker embeddings 用于对比损失 ,最大化来自同一 speaker 的样本之间的相似性,并最小化来自不同 speaker 的样本之间的相似性[46]。 此外,我们通过将内容回归器的输出传递给冻结的 speaker extractor ,提取 embeddings。并应用梯度反转 来最大化 speaker embeddings 与 embeddings 之间的余弦距离 [47]。我们假设这鼓励了内容和说话者信息之间的分离。 这里说的 maximize cosine distance 的输入是 context regressor的输出。但是图上画的是 VQ 后的输出。此处并没有错,可以看下VQ的细节,见: https://blog.csdn.net/RachelRicher/article/details/125439445 VQ 用于提取 speechcode,speaker extractor 用于提取 speaker embedding. 除了更好地解除说话人信息的纠缠 外,我们还认为使用预训练的WavLM模型的特征作为输入(而不是联合学习的音频编码)可以使 speechcodes 对 recording conditions 更具鲁棒性 。我们的直觉是,WavLM是用数据增强来训练的,以鼓励从背景噪声中解脱出来 。除了矢量量化器的承诺损失 外,总损失由这些损失的加权组合给出:
Byte-pair encoding on speechcodes 基于wavlm的语音表征以 50 Hz 的频率学习,以确保它们能够及时提供足够的分辨率,即使在快节奏的语音中也能区分单个音素 (英语音素的平均长度往往不低于20ms[48])。
我们应用字节对编码BPE[41]将 speechcodes 的平均序列长度减少了约40%,以减轻transformer 序列长度的二次 内存增加 ,并最大限度地降低自回归模型的复杂性 。
与文本的BPE类似,我们迭代地将最频繁的speechodes对加入到新的tokens中,并将它们添加到词汇表中,直到达到预定的词汇表大小。
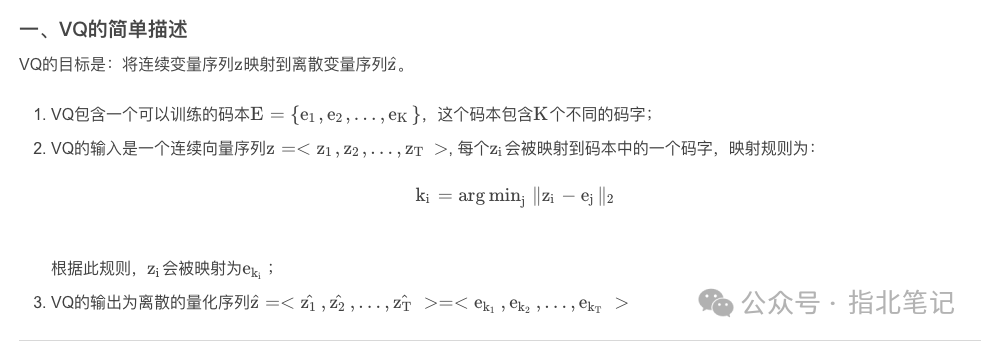
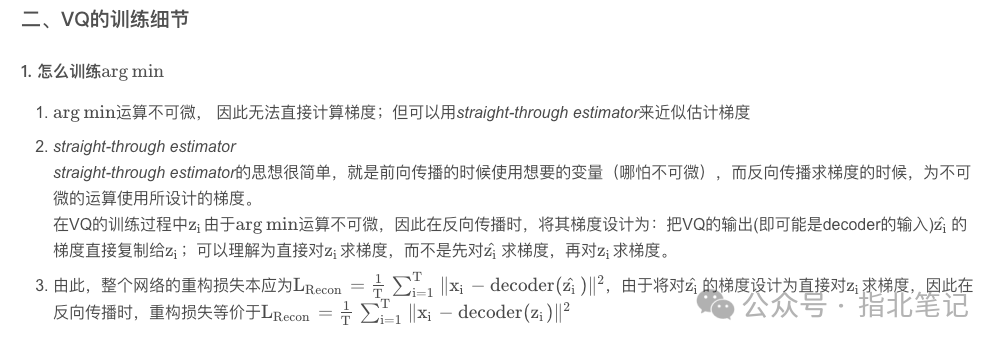
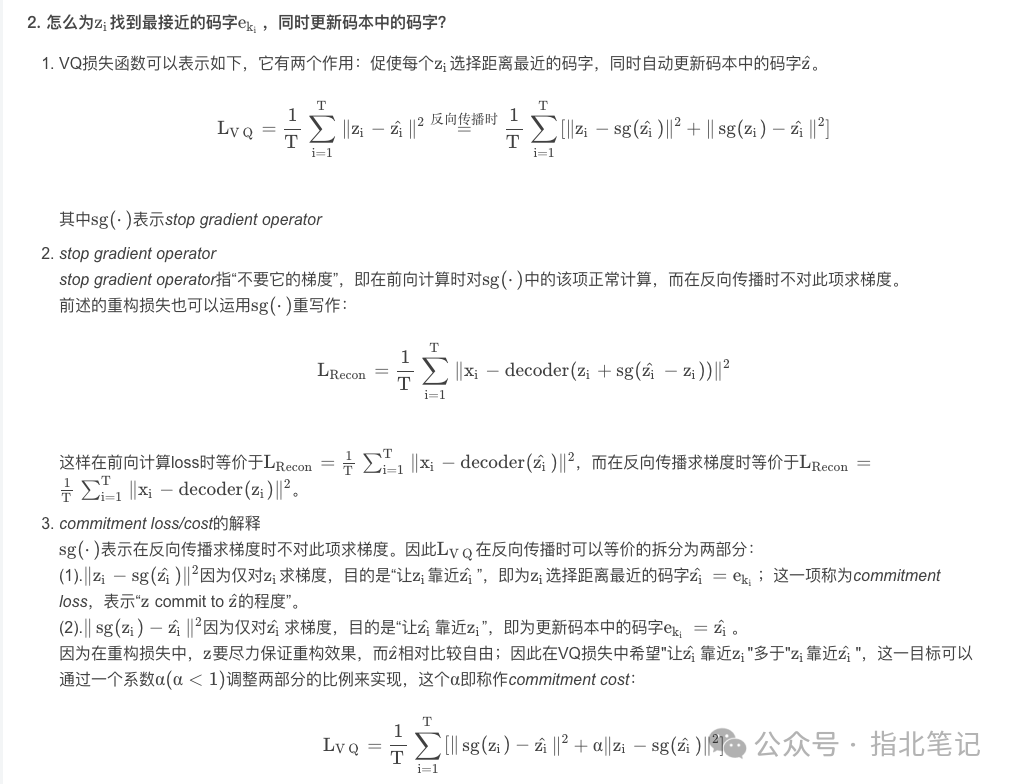
连续向量 VQ 后为一个离散的码字,码字可以用索引表示,索引与word id 对等,可以应用 BPE 编码。SpeechGPT 输出 BPE 编码后,可以再拆成原有的码字索引,按索引查询对应的码字向量。VQ 相关可以看: https://blog.csdn.net/RachelRicher/article/details/125439445 Autoregressive speech modeling (SpeechGPT) 我们训练了一个 GPT-2 架构的自回归模型,我们称之为“SpeechGPT”来预测基于文本和参考语音的 speechcodes。 参考语音由来自同一说话人的随机选择的话语组成,该话语被编码为固定大小的embedding。 参考speech embedding、文本和 speechcodes 被连接到一个序列中,该序列由基于transformer的自回归模型建模。我们对文本和语音使用单独的 positional embeddings 和单独的预测头 。 我们从头开始训练自回归模型,而不需要对文本进行预训练 (例如[50]中所做的)。 为了保留文本信息来指导韵律 ,我们还训练了SpeechGPT,目的是预测输入序列的文本部分中的下一个token ,这样一来,SpeechGPT在一定程度上是一个纯文本的LM。与语音损失相比,我们对这种文本损失应用了较低的权重 。
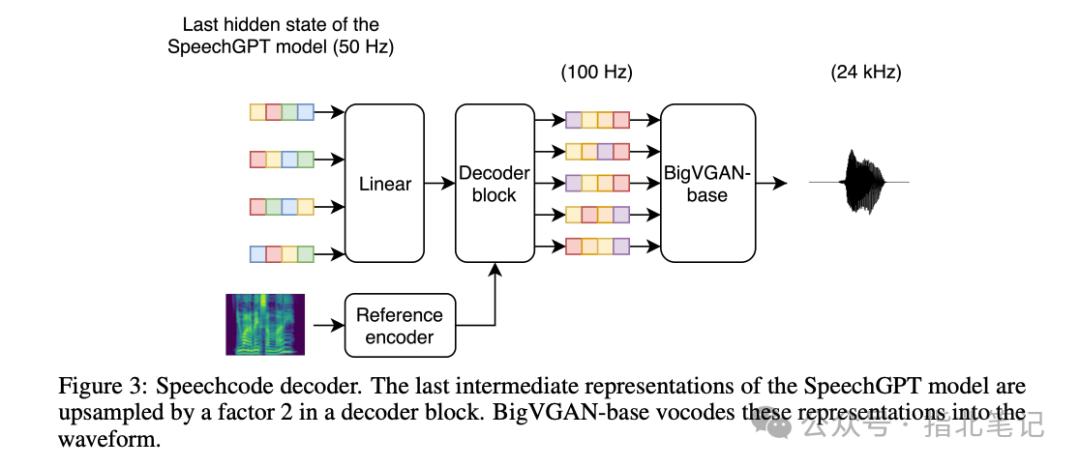
Waveform generation 我们的基线使用了一个 diffusion-based 的 spectrogram 解码器和一个单独训练的 UnivNet vocoder,如[21]中提出的。 基于扩散的TTS解码可以生成高质量的语音,但它的推理速度很慢,不能增量地生成样本——这种缺乏流性 的情况迫使我们一次获得整个序列的音频输出。此外,[21]中的扩散模型预测 spectrograms,并且需要一个单独训练的vocoder 来生成音频,使训练和推理管道复杂化。 我们提出的解码器受到[23]的启发,以端到端方式进行训练以预测波形。我们的变体使用 speechcodes 作为模型的输入,而不是 phoneme编码和prosody latents。 此外,为了使模型更具可扩展性,我们将LSTM层替换为卷积层来解码中间表示。基于 HiFi-GAN decoder block 的输出被馈送到BigVGAN声码器来预测波形。 在训练中,我们使用与[23]相同的对抗性和非对抗性损失。我们称我们提出的系统为“speechcode decoder”,如图3所示。除了简化整个系统之外,我们假设端到端训练 decoder 和 vocoder 可以产生更高质量的语音。 在实践中,speechcodes解码器将自回归变压器的最后一个隐藏状态作为输入,而不是speechcode。我们这样做是因为dense latent representation提供了比单个语音代码更丰富的信息,如下[21]。 在训练期间,我们将文本和目标代码提供给训练后的SpeechGPT(参数冻结),然后根据最后的隐藏状态调整解码器。输入SpeechGPT的最后隐藏状态有助于提高语音的分段和声学质量 ,但也将解码器耦合到特定版本的SpeechGPT 。这使得实验变得复杂,因为它迫使两个组件总是按顺序构建。这一限制需要在今后的工作中加以解决。
Experimental setup 我们设计并进行了实验来验证BASE TTS的体系结构及其质量、能力和计算性能。首先,我们比较了基于自动编码器和基于wavlm的语音编码所获得的模型质量。然后,我们评估了语音码的两种声学解码方法:基于扩散的解码器和语音码解码器。在完成了这些架构上的消融之后,我们评估了BASE TTS在3种数据集大小和模型参数上的突发能力,由一位语言学专家进行了评估。此外,我们运行主观MUSHRA测试来测量自然度,以及自动可理解性和说话人相似度测量。我们还报告了与其他开源文本到语音模型的语音质量比较。
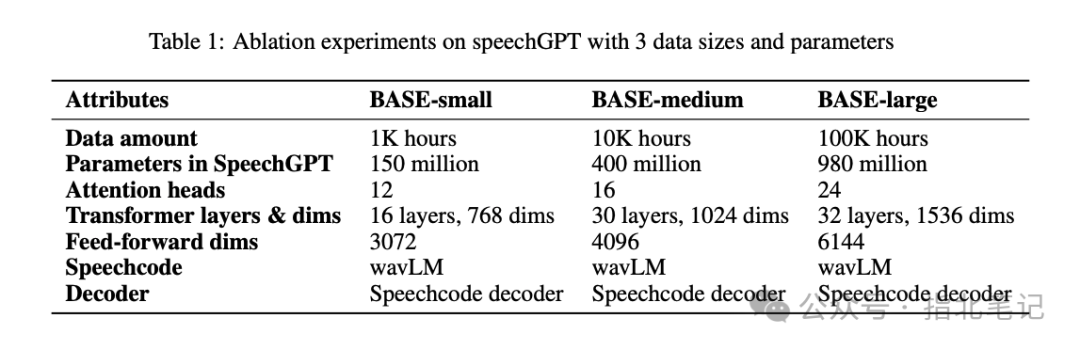
Dataset 为了验证我们的假设,即能力随着数据的规模而出现,我们开始为我们最大的LTTS模型使用最大的语音数据集进行训练。我们创建了一个由10万小时未标记的公共领域语音数据组成的数据集 。整个数据集以英语数据为主(超过90%),其次是德语、荷兰语和西班牙语 。 我们首先从网上下载mp3文件,并将它们重新采样为24 kHz单声道LPCM文件 ,每个采样16位编码为有符号整数。 绝大多数 数据集都是在非工作室 条件下记录的,并且包含噪声 ,我们避免了额外的信号处理或去噪,以测试我们的模型从噪声背景数据中生成干净语音的能力 。接下来,我们使用结合语音活动检测(VAD)的ASR模型来执行语音分割和自动语音识别。 ASR模型将整个演讲分成30秒或更短的片段 。然后,我们使用VAD将超过20秒的句子分割 ,并在训练期间将它们重新组合成更长的句子 ,只要它们的总长度不超过40秒 。因此,我们将BASE TTS暴露给长度在0到40秒之间 、包含一个或多个句子的语音片段 ,这样模型既可以对非常短的输入具有鲁棒性,也可以从更长的上下文中学习。 为了生成数据集的转录文本,我们最初依赖于ASR转录。我们发现,与自然现象相比,ASR倾向于产生更少的标点符号 。例如,它过度生成逗号而不是冒号和分号,并且很少生成括号。 然后,我们执行部分文本恢复(类似于[56]),方法是: 逐句匹配ASR文本与源文本,如果差异足够小(长度不长/短3倍,且在一定的编辑距离内),则将前者替换为后者。 我们将大约1/2的文本恢复到“original” ,导致文本中各种 引号增加300%,括号增加20000%。这导致我们的模型在括号和其他“rare”标点符号上不再有频繁的声学伪影。 Training and hyperparameters 我们分三步训练模型。由于使用离散语音表示,我们依赖于训练数据中约50小时的交叉熵验证损失来指导我们的训练、重新启动和停止决策。所有模型都在使用NVIDIA®V100 gpu的AWS P3dn实例集群上进行训练。 首先,我们训练两个speech tokenizer 器变体:第2.2.1节中的VQ-VAE标记器和第2.2.2节中的WavLM标记器。由于英语数据的压倒性存在,我们在3.1节中通过保留所有来自非英语语言的数据来训练两个变体,但将来自单个英语使用者的语音量限制在200小时以内-来自说话者的多余数据被随机丢弃。我们使用256 的 WavLM speechcode 和8196 的VQ-VAE codebook 大小。随后使用BPE算法和大小为8192的词汇表 压缩 WavLM speechcodes。我们首先优化 ground truth spectrograms 上的重建损失,对波兰语等“少数”语言(占总数据的0.2%)上的重建音频进行完整性检查,以确保足够的 speechcode 覆盖。 其次,我们使用随机初始权值在整个训练数据集上训练SpeechGPT 。模型的输入是:来自说话人的随机参考语音段、文本和相应的目标语音段 。我们将参考语音段转换为 mel-spectrogram,并将其馈送到 reference encoder。目标语音段被VQ-VAE或WavLM标记,形成目标 speechcodes。我们将编码的引用与输入文本嵌入和 speechcodes 嵌入连接起来,并将它们提供给自回归转换器。该模型在文本标记(权重为0.01)和 speechcodes(权重为1.0) 上进行了交叉熵损失优化。 为了理解数据和模型大小的重要性,我们使用2.2.2节中描述的WavLM speechcodes 构建了另外两个版本的SpeechGPT (BASE-small & BASE-medium),参数和语音数据的数量在表1中不断增加。 最后,我们使用借鉴于[23]的改进的对数似然最大化GAN训练方案训练第2.4节中描述的speechcodes decoder。该模块的总参数大小约为1.5亿个。
Evaluation methodology MUSHRA (Multiple Stimuli with Hidden Reference and Anchor)在美国英语和西班牙语的母语听众的竞争系统中。我们使用从0到100的MUSHRA量表。我们不会设置上/下锚,也不会让听众给这些锚打0分或100分。通过这种方式,我们能够在固定的评估预算中对目标系统进行更多的评级。对于每个报告的MUSHRA测试,25-50个测试人员提供50-100个文本片段的评级,范围在5-40秒之间,这样我们就可以在每个系统的每次测试中获得大约17-20小时的总有效侦听时间。 Linguistic expert evaluation of "emergent abilities"为了衡量BASE TTS更好地理解文本的能力,我们用英语手工创建了一个“突发能力测试集”,其中包含7类文本:问题、情感、复合名词、句法复杂性、外文词汇、副语言学和标点符号 。在表2中,我们给出了每个类别的一个示例,以及语言专家如何在离散的3分制上对TTS输出进行评级。这些句子被设计成包含具有挑战性的任务——解析花园小径句,将短语重音放在冗长的复合名词上,产生情感或低声说话,或者为“qi”等外文单词或“@”等标点符号产生正确的音素——BASE TTS没有明确训练过这些任务。我们的假设是,随着BASE TTS模型容量的增加和对更多数据的训练,模型将开始获得这些能力,因为有证据表明,这些维度的缩放会导致定性能力的跳跃。我们在附录A中共享完整的测试集。 Automated objective evaluations 来测试TTS的鲁棒性,特别是缺失、重复或幻觉合成和说话人相似度的问题。我们使用ASR模型通过比较测试集文本(真实值)和合成语音的ASR输出来计算单词错误率(WER)。此外,我们采用基于WavLM特征微调的说话人验证模型1,从原始录音和合成语音中获得说话人嵌入,然后计算它们之间的余弦距离,得到说话人相似度度量(speaker similarity metric, SIM)。
对于主观评价,我们以95%的置信区间报告平均MUSHRA分数。此外,为了确定两个系统之间差异的显著性,我们进行了t检验;如果p值< 0.05,我们认为差异显著。为了帮助可视化,我们用粗体标记统计上更好的系统。
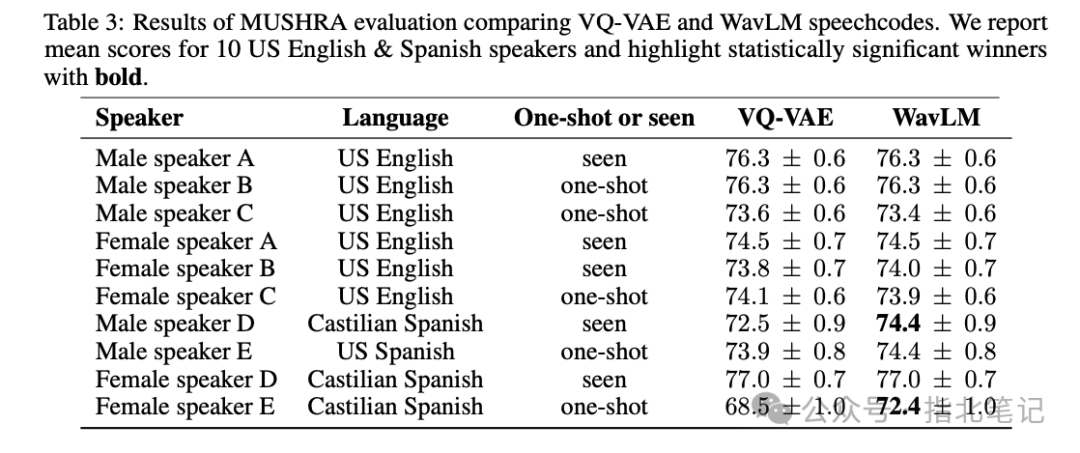
Results VQ-VAE speechcode vs. WavLM speechcodes 我们对6名美国英语和4名西班牙语(卡斯蒂利亚语和美国语)使用者进行了MUSHRA评估,以全面测试两种语音标记化方法的质量和通用性,同时使用了训练中看到的说话者(“seen”条件)和未看到的说话者(“one-shot”条件)的测试数据。 在英语语音的平均MUSHRA得分方面,VQ-VAE和基于WavLM的系统基本持平(VQ-VAE: 74.8 vs WavLM: 74.7,差异无统计学意义)。然而,对于西班牙语语音,基于WavLM的模型在统计上显著优于VQ-VAE模型(VQ-VAE: 73.3 vs WavLM: 74.7)。 请注意,英语数据占我们数据集的90%左右,而西班牙语数据仅占2%。我们假设 speechcode 的改进对于低资源语言更为重要,而纯粹的数据量可以弥补不完美的表示 。这一假设的进一步验证需要在未来的工作中解决。 由于基于wavlm的系统的性能至少与VQ-VAE基线一样好,甚至更好,因此我们在进一步的实验中使用它来表示BASE TTS。在表3中,我们显示了按speaker 分类的结果,以提供有关每个speaker性能的更多详细信息。
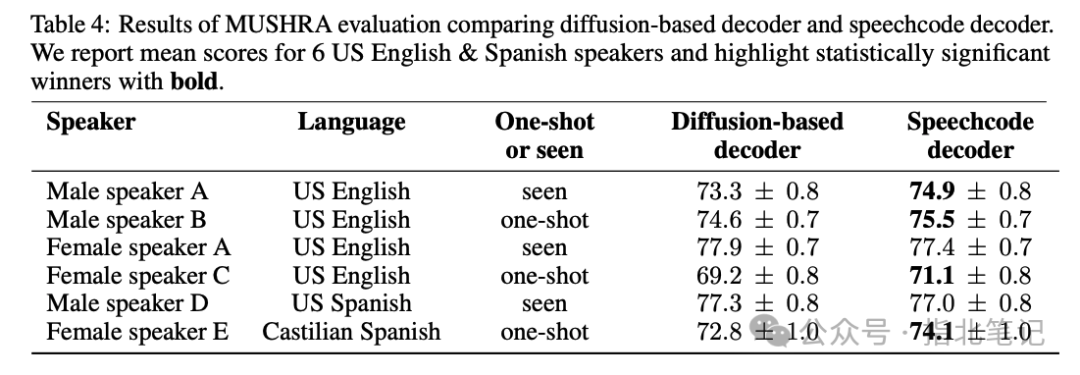
Diffusion-based decoder vs. speechcode decoder BASE TTS通过提出端到端 speechcode decoder,简化了基于基线扩散的解码器,如第2.4节所述。我们的方法提供了streamability和3倍的推理速度提高 。为了确保这种方法不会降低质量,我们针对基线对所提出的 speechcode decoder 进行了评估。表4给出了我们对4名美国英语和2名西班牙语使用者进行的MUSHRA评估结果。对于6个声音中的4个,带有speechcode decoder 的 BASE TTS 变体在平均 MUSHRA 得分方面优于基于扩散的基线。对于其余的人来说,这种差异在统计上并不显著。我们得出的结论是,speechcode decoder 是首选的方法,因为它不会降低质量,而且对于大多数语音来说,它带来了质量的提高,同时提供了更快的推理 。我们的研究结果表明,结合两个强大的生成模型进行语音建模是多余的,可以通过去掉扩散解码器来简化。
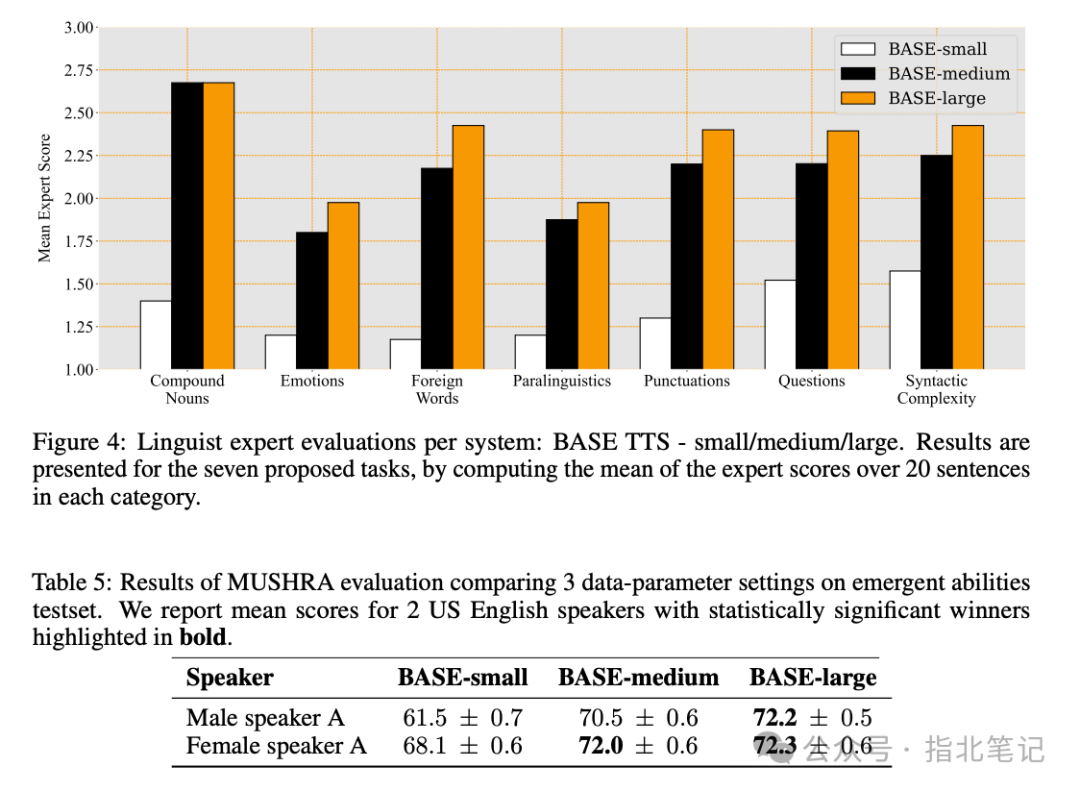
Emergent abilities - Data and model size ablation 在本节中,我们报告了我们对假设的验证,即LTTS中的数据和参数扩展带来了定性不同的结果,类似于将LLM从10^22个标记训练到10^24个标记,当llm“突然”开始掌握少量数字加法,在高于偶然水平的上下文中识别单词,并用专家语音字母表转录语音时。 如3.3所述,我们对 2 种美式英语语音进行了MUSHRA和语言学专家对"Emergent abilities”的判断。我们按照BASE-small、BASE-medium和BASE-large系统报告所有分数,如表1所示。在表5中的MUSHRA结果中,我们观察到从BASE-small到BASE-medium的语音自然度显著提高,但从BASE-medium到BASE-large的语音自然度提高较少 ——只有男性说话者A的差异在统计上是显著的。 我们报告了三个系统的语言专家判断结果,以及每个类别的平均得分,见图4。首先,我们看到跨类别从BASE-small到BASE-medium的普遍跳跃 。BASE-small似乎从根本上无法解释情绪、副语言学和外来词(平均得分< 1.25,得分下限为1),并且在任何类别中从未达到平均得分1.75 。相比之下,在BASE-medium中,模型掌握了复合名词,并在所有类别中取得了显著的飞跃;基础中等从不低于任何类别的平均得分1.75 。从BASE-medium到BASE-large,我们观察到除了复合名词以外的所有类别都有持续但逐渐减少的改进 ,复合名词的性能已经饱和。结合naturness MUSHRA的研究结果,我们认为,将基于GPT的TTS模型从1000+小时扩展到10000+小时,将模型大小从 100 million 扩展到 500 million,是我们的TTS开始出现“emergent abilities”的点 。 按类别检查结果,我们观察到情绪 和副语言学 仍然是所有模型变体中最具挑战性的任务 ,即使BASE-large的平均得分也在2.0左右,这表明模型可以识别相关关键词并做出反应,但韵律质量对于专家判断仍然不完美。相比之下,BASE-medium在英语复合名词上的表现接近上限,而在大多数其他类别(外语词、标点符号、疑问句、句法复杂性)上则略落后于BASE-large。我们仍然希望进一步扩展和从纯文本LLM中注入文本知识可以帮助我们缩小剩余的性能差距。
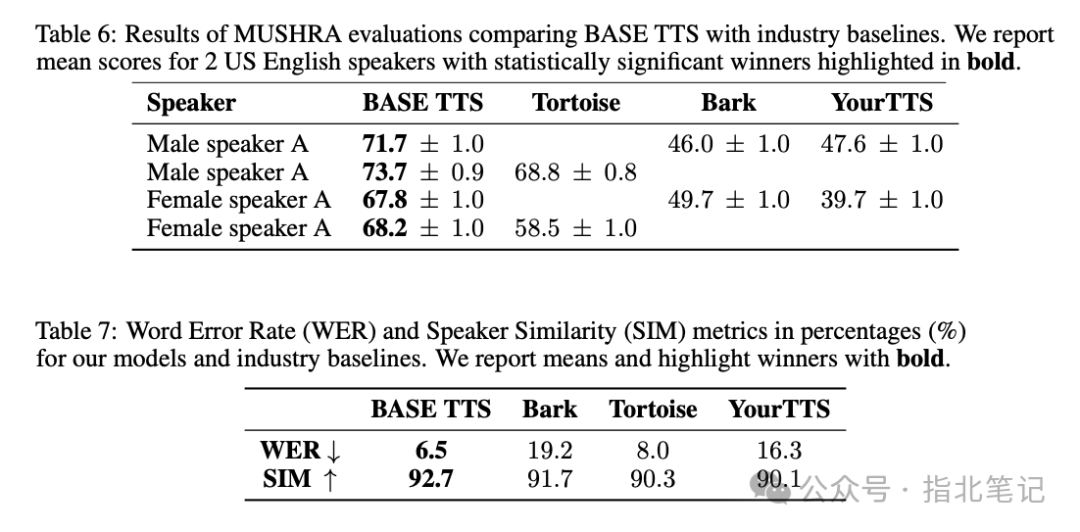
BASE TTS vs. industry baselines 我们选择了三个具有公开可用的预训练模型的行业基线:YourTTS,Bark和Tortoise。我们只在 one-shot 设置中进行比较,使用10秒的参考剪辑,为两个美国英语使用者,BASE TTS之前没有接受过培训或评估。 如表6所示,在测试的两名美国英语使用者中,BASE TTS在MUSHRA中的自然度得分明显高于基线系统。 我们进一步对10个说话者和307个样本分别进行了WER和speaker相似度的客观评价,如表7所示。总的来说,BASE TTS产生最自然的语音,与输入文本的不对齐最少,并且与参考说话者的语音最相似,在自然度和WER方面紧随其后的是Tortoise。Bark和YourTTS在自然度和WER上的表现要差得多,尽管Bark在说话人相似度上相对接近BASE TTS。
Synthesis efficiency gain due to speechcode decoder speechcode decoder 能够 streaming,即增量生成语音 。将此特性与自回归的SpeechGPT相结合,我们的系统的第一字节延迟低至100ms —— 只有少数解码的 speechcodes 就足以产生可理解的语音。 这种最小的延迟与基于扩散的解码器形成对比,后者需要一次性生成整个语音序列(一个或多个句子),其中第一字节延迟等于总生成时间。 此外,我们观察到,与扩散基线相比,语音码解码器使整个系统的计算效率提高3倍 。我们运行基准测试,在批处理大小为1的NVIDIA®V100 GPU上生成1000个持续时间约为20秒的语音。使用扩散解码器的10亿个参数的SpeechGPT平均合成时间为69.1秒,而使用语音码解码器的相同的SpeechGPT平均合成时间为17.8秒.
Related work Text-to-speech as language modeling. 近年来,由于将语言模型扩展到大数据和模型大小非常容易,将TTS问题作为下一个令牌预测变得越来越流行。 使用这种方法的第一个模型是于2022年发布的TortoiseTTS。它将gpt2风格的 speechcode 语言模型与 diffusion decoder 和现成的 vocoder 相结合,实现了显着的 few-shot 能力。 VALL-E采用了类似的方法:将模型缩放到60k小时的语音数据,并使用预训练的音频编码器EnCodec进行语音编码提取。VALL-EX 用70k小时复制了VALL-E,并使用目标语言标记作为提示符,在英语和汉语之间增加了跨语言语音翻译任务。 VioLa扩展了VALL-EX的文本到文本翻译和语音到文本识别任务。SpeechX扩展了VALL-E,增加了噪声抑制、目标说话人提取、干净和噪声语音编辑和语音去除任务。 虽然VALL-EX, VioLA和SpeechX是多功能模型,报告在单词错误率和说话人相似度方面的性能有所提高,但在核心TTS方面(如自然度或韵律改善)没有影响。VALL-E报告了与行业基线相比的显著改善,但我们无法进行比较,因为该模型无法公开获得。在这里,我们提出了一个利用10万小时数据的多语言和多使用者TTS,在英语和西班牙语中具有很强的自然性结果。评估显示,与 Tortoise-TTS 相比,语音自然度有所改善。定性语言分析显示了“emergent abilities” - BASE TTS 可以呈现复杂的韵律模式,从文本中获取线索,而不需要明确的情感标签。
Discrete speech representations. 在音频生成AI中,第一批用于GPT-TTS的声学编码器是VQ-VAE、SoundStream和EnCodec,它们是基于矢量量化产生离散声学标记的深度学习音频压缩技术。这些声学编码器被证明优于 Mel-spectrograms,但忽略了语义信息,并且由于缺乏解纠缠而不必要地复杂。
AudioLM 结合了 SoundStream tokens 和语义BERT tokens。SpeechTokenizer和RepCodec旨在通过添加自监督嵌入基于预测的损失来捕获语义。
BASE TTS通过利用来自自监督嵌入的语义信息和从声学标记中分离说话者信息来构建声学标记。然后,它对这些标记应用字节对编码以减少内存需求,允许模型在更长的序列上进行训练。
LTTS simplifies modeling. 自Tacotron 2以来,一个成功的TTS范式已经将语音创建分为三个子系统
前端负责文本规范化,字音素转换和SSML标签处理,例如标记重音;
Mel-spectrogram生成器,推断语音信号的振幅并负责模型表达性;
可以诱导专家知识来提高其性能,例如使用预先计算的特征、粗粒度或细粒度的韵律信息和风格控制。它在transformer、flow和diffusion等架构中也被证明是成功的。
这些系统需要一个复杂的pipeline。在早期阶段发生的任何错误都会传播到下一个阶段。BASE TTS和其他LTTS模型正在打破这些限制。我们通过只需要大量的音频来简化数据准备,其中文本可以从语音到文本系统中获得,并且不需要音素提取。基于gpt的架构通过实现基于提示的多功能任务制定,专家反馈的集成,以及作为快速微调的基础模型(例如针对特定任务,一组speaker或一个新的场所)而蓬勃发展。BASE TTS表明,端到端方法可以在少数音频示例和多语言设置中实现高表达性,标志着西班牙语的高质量标准。
Contextual and emotional TTS. 这通常需要独立的、专用的TTS子系统。多种方法依赖于使用语境化词嵌入来预测韵律表示。虽然这些模型的韵律预测器通常会生成适当的韵律,但它们通常会忽略可能导致戏剧性变化的强烈文本线索,例如情绪或语音线索,如大喊大叫或低语。情境感知情感TTS系统甚至更为有限。他们通常倾向于基于文本的情绪预测器和情绪可控的TTS系统。这些系统需要具有强制说话风格的高质量录音以及注释的音频和文本数据,由于人类语音中可表达的情感数量众多,限制了它们的实用性。BASE TTS的优势在于它是一种既具有声学感知又具有语义/语法感知的语言模型。在本文中,我们系统化了一种方法来产生和评估具有广泛风格的文本的紧急上下文理解,而不需要监督训练或注释。
BASE TTS has data efficiency built-in. 低资源TTS专注于通过语音转换、数据生成、建模技术或录音脚本优化来减少所需的高质量训练数据量。这源于从不同风格或语言的多个说话者那里摄取大量数据的早期困难。在这个方向上的一个进步是zero-shot inference,如Bark和[60,91],其目的是克隆一个声音,只有几秒钟的录音。由于利用了更大的数据集、更大的模型和专用的扬声器编码器,BASE TTS和最近的LTTS模型在数据效率方面树立了新的标准.
Conclusion 我们介绍了BASE TTS,这是一种 GPT 风格的TTS系统,使用新颖的基于SSL的 speechcode 作为中间表示和 speechcode decoder,提供了一种高效、可流的替代diffusion。无论从参数还是训练数据来看,这都是我们已知的同类模型中最大的一个。我们展示了新的最先进的TTS结果对照基线,包括Tortoise, Bark和YourTTS。我们提出了一种新的方法来衡量TTS模型的文本理解,并表明使用10K小时的数据和4亿个参数构建的LTTS模型开始表现出对文本的高级掌握,从而能够实现上下文适当的韵律。从 BASE TTS 在英语和西班牙语上的强大表现中,我们第一次看到了一种多语言 TTS 方法,它实现了高表达性,适应文本线索,数据效率高,仅使用公共领域数据,并且适用于流式TTS用例,例如为LLM输出语音。我们的方法指向LTTS模型的潜在缩放定律,其中需要更大量的语音和其他(文本,图像)数据来支持多模态目标并在TTS中开辟新的领域。
我们的方法仍然存在一些局限性:
BASE TTS偶尔会产生幻觉和截断,我们会产生比文本预期的额外或不完整的音频。这是自回归LM方法的固有问题,音频数据和asr生成的文本之间的不对齐使问题变得更糟; 为gpt式TTS选择正确的离散表示是至关重要的。需要更多的研究来确定 speechcodes 的不同属性如何转化为端到端系统质量。我们只报告一个speechcodes 配置的结果,为以后的工作留下更全面的研究。
参考文献 https://arxiv.org/pdf/2402.08093v2.pdf https://amazon-ltts-paper.com/ https://blog.csdn.net/RachelRicher/article/details/125439445 
 语音小管家