近日,OpenAI官方公布了一项引人瞩目的技术成果:其语音模型仅需15秒样本即可精准复刻人声(OpenAI语音模型“炸场” 15秒样本即可复刻人声)。尽管官方表示目前不会广泛发布此项技术,但这一消息仍在业界引起了不小的震动。
事实上,自2023年以来,微软公司的VALL-E(3秒克隆你的声音,微软推出DALL-E表亲VALL-E)和Natural Speech 3(微软NaturalSpeech语音合成推出第三代,网友惊呼:超自然!)等技术也不断宣传可以“使用3秒样本复刻人声”。随着人工智能技术的不断发展,声音作为生物特征识别的一种,其安全性和应用前景成为公众关注的焦点。
在这波讨论中,关于“基于语音的身份验证”是否应被淘汰的观点尤为引人注目。有鉴于此,我们特别邀请到清华大学人工智能研究院听觉智能中心主任郑方教授,针对这一热议话题做专家评述。以下是郑方教授的观点:
OpenAI关于“基于语音的身份验证”的描述是很笼统的、模糊的。有别于人脸等生物特征,语音生物特征(Voice Biometric)也即声纹(Voiceprint),有其独特性。声纹可以认为是兼具生理特性的行为特征,“生理”特性代表其稳定性和唯一性,“行为”特征又表明其不易伪造性。
声纹身份认证的高安全性表现为以下三个方面。
一、声纹(语音生物特征):不易伪造易被检测
声音中蕴含的信息量是巨大的,分为三个层次,语言信息、副语言信息和非语言信息(如下图表示),例如内容、身份、语种、口音、情感、健康状况、年龄、性别等。伪造声音要完全复制这些元素而毫无破绽,难度极大。
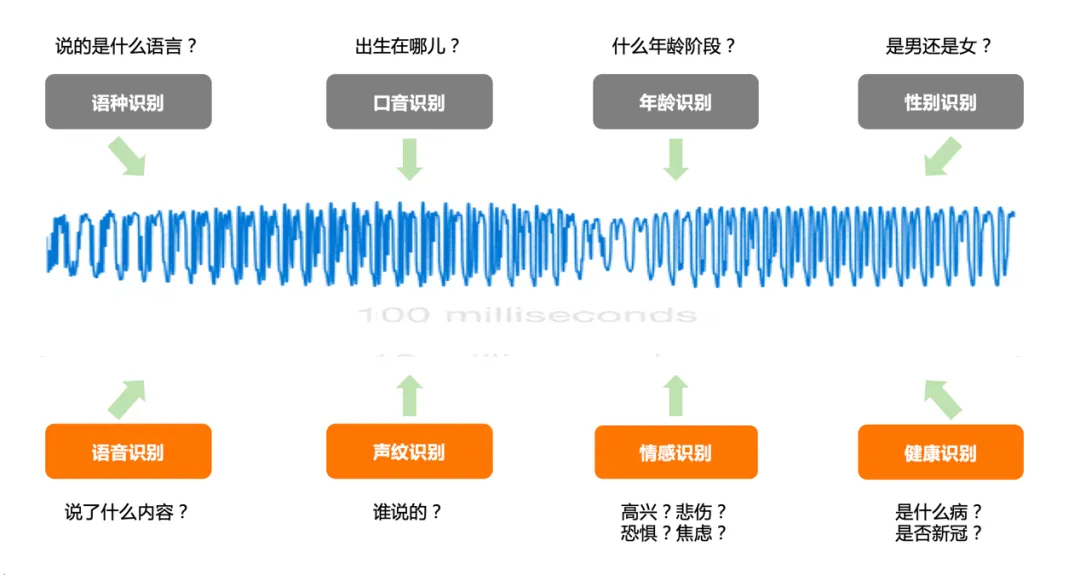
形简意丰的语音信号
基于深度学习和大数据的方法,由于其不可解释性和对大数据的依赖性,也许要准确无误地检测出未知方法的伪造音很困难,但基于类脑感知和类脑决策的鉴伪方法,则可以方便地、准确地检测出伪造音的破绽,而且其天然所具有的增量式学习(incremental learning)机制可以低成本地、有效地检测新型未知类型的伪造音。人类听觉易被欺骗,伪造音对人类可能是个挑战,但在基于上述思路的鉴伪面前等于是在“裸泳”。最新研究表明,这种具有可解释性的、基于类脑感知和类脑决策的伪造音检测错误率几乎为0%,这在很大程度上保证了声纹识别对伪造音的免疫力。语音信号“形简意丰”的特点,使得声纹识别与其他生物特征不同,根据认证时对说话内容的形式要求可以分为文本无关(随意说)、文本相关(固定文本)和文本提示(随机文本)三种类型。其中基于数字串的文本提示的声纹识别被中国人民银行称为“动态声纹密码”,它具有隐私泄漏少、安全性高、意图真实性强等优势。它实际上是一次一密的随机密码,以8位数字串为例就有1亿个可能的串,这种随机性和动态性使得文本提示的声纹识别更加难以被预测和破解,这是其他所有生物特征所不具备的特点。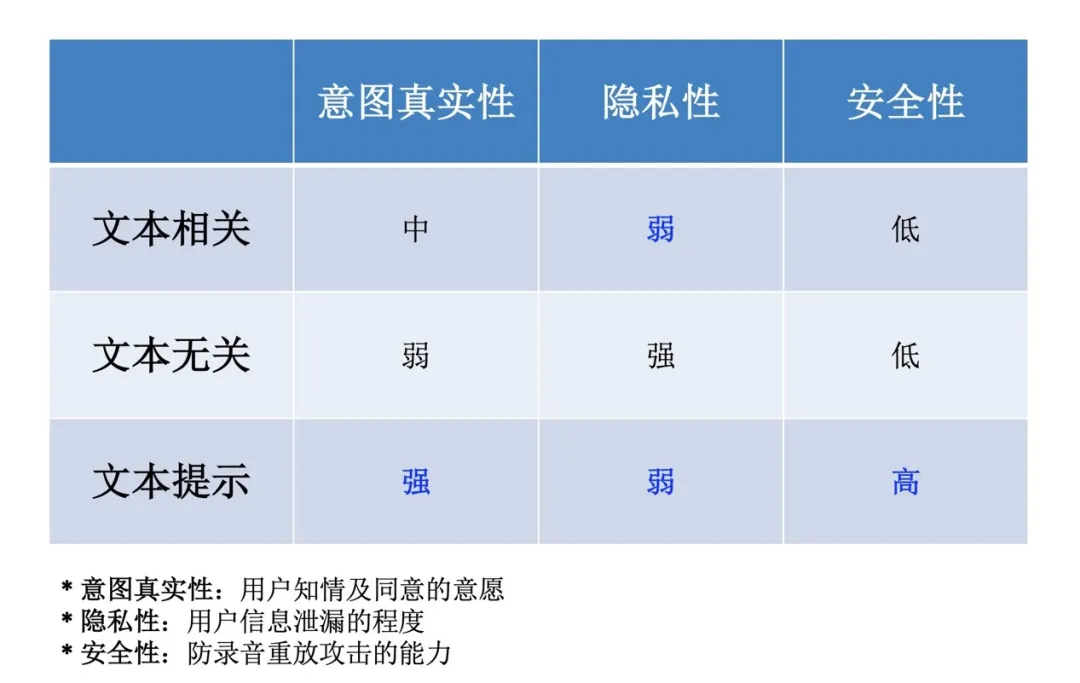
不同文本相关性的声纹
对应的意图真实性、隐私性和安全性比较
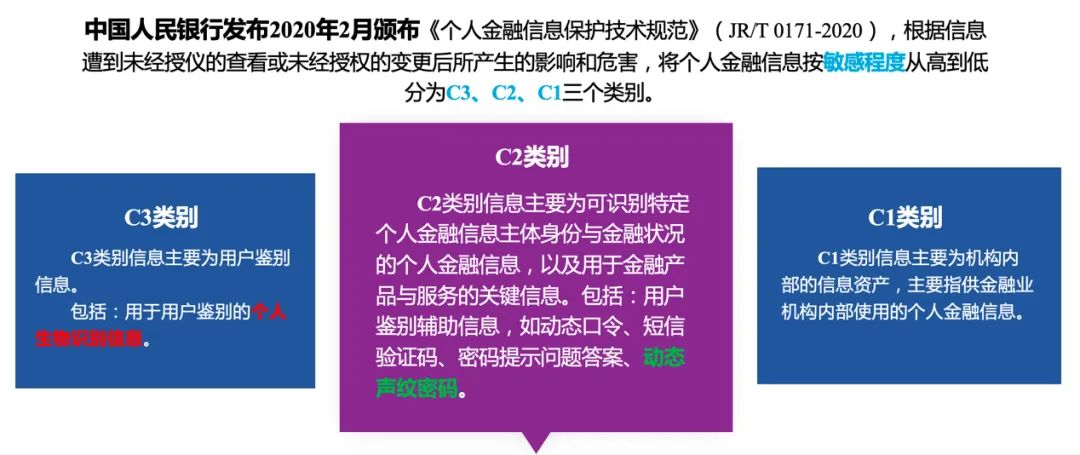
相较于其他生物特征,
动态声纹密码的隐私敏感程度是低的
三、用户加密行为的叠加,让声纹识别披上坚不可摧的铠甲安全是不能完全依靠技术去保障的,安全问题是“三分技术、七分管理”,让用户自己有能力、便捷地参与安全管理,可以大幅度地提高安全性。语音信号的特点,使得声纹身份认证很容易叠加用户加密行为,而不增加额外负担和成本。用户加密行为有两种:第一是用户可以指定某个/些字词(明文)读成其他任意发音(密文,可以是本语言、跨语言,甚至混合语言),第二种是用户可以指定某些字/词的发音对调(用户自定义发音次序,比如见“3”读成“6”,见“6”读成“3”)。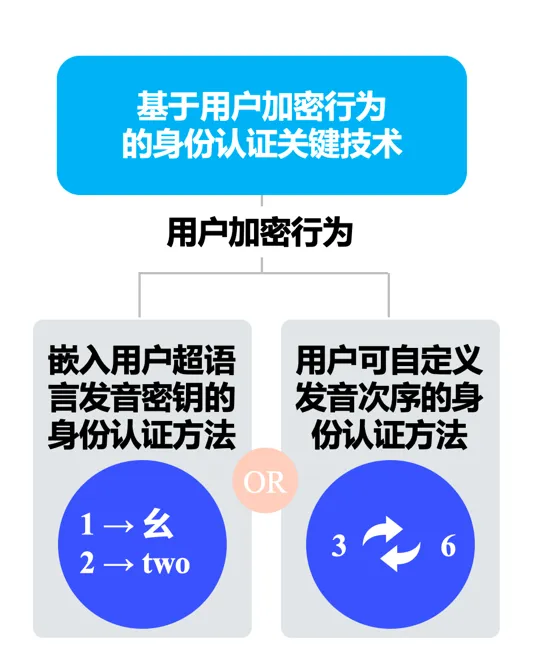
用户加密行为的两种方式
这种用户参与式的安全管理方式,攻击者攻破声纹身份认证的几率几乎为零。我们两次攻防比赛没有一家成功攻破的事实,证明了这一点。综上所述,声纹用于身份认证的安全性是极高的,这既是由语音信号本身的特性决定的,也与现有的算法优势和用户参与度密不可分。因此,基于语音的身份验证不仅不应该被淘汰,反而应该得到大力推广和应用。当然,这并不意味着我们可以忽视其中的安全风险和挑战。相反,我们应该继续加强技术研发和管理措施,确保声纹识别技术的安全、可靠和高效应用。
 声纹圈
