
 语音小管家
本项目希望通过开源社区的力量复现Sora,由北大-兔展AIGC联合实验室共同发起,当前资源有限仅搭建了基础架构,无法进行完整训练,希望通过开源社区逐步增加模块并筹集资源进行训练,当前版本离目标差距巨大,仍需持续完善和快速迭代,欢迎Pull request。
项目阶段
基本的
设置代码库并在景观数据集上训练无条件模型。 训练可提高分辨率和持续时间的模型。
扩展
在景观数据集上进行text2video实验。 在 video2text 数据集上训练 1080p 模型。 具有更多条件的控制模型。
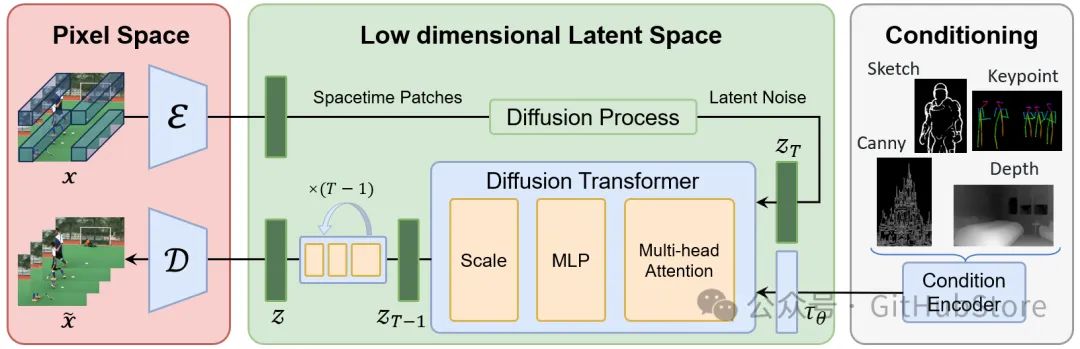
仓库结构
├── README.md
├── docs
│   ├── Data.md                    -> Datasets description.
│   ├── Contribution_Guidelines.md -> Contribution guidelines description.
├── scripts                        -> All training scripts.
│   └── train.sh
├── sora
│   ├── dataset                    -> Dataset code to read videos
│   ├── models
│   │   ├── captioner
│   │   ├── super_resolution
│   ├── modules
│   │   ├── ae                     -> compress videos to latents
│   │   │   ├── vqvae
│   │   │   ├── vae
│   │   ├── diffusion              -> denoise latents
│   │   │   ├── dit
│   │   │   ├── unet
|   ├── utils.py
│   ├── train.py                   -> Training code
要求和安装
Python >= 3.8 Pytorch >= 1.13.1 CUDA 版本 >= 11.7 安装所需的包:
git clone https://github.com/PKU-YuanGroup/Open-Sora-Plan
cd Open-Sora-Plan
conda create -n opensora python=3.8 -y
conda activate opensora
pip install torch==1.13.1+cu117 torchvision==0.14.1+cu117 torchaudio==0.13.1 --extra-index-url https://download.pytorch.org/whl/cu117
pip install -r requirements.txt
cd VideoGPT
pip install -e .
cd ..
用法
数据集
Video-VQVAE (VideoGPT)
训练
cd src/sora/modules/ae/vqvae/videogpt VQ-VAE 特定设置
--embedding_dim :码本嵌入的维数 --n_codes 2048 :码本中的代码数量 --n_hiddens 240 :残差块中隐藏特征的数量 --n_res_layers 4 :剩余块的数量 --downsample 4 4 4 :编码器的 T H W 下采样步长
训练设置
--gpus 2 :分布式训练的GPU数量 --sync_batchnorm :使用 > 1 GPU 时使用 SyncBatchNorm 而不是 BatchNorm3d --gradient_clip_val 1 :训练的梯度裁剪阈值 --batch_size 16 :每个 GPU 的批量大小 --num_workers 8 :每个 DataLoader 的工作人员数量
数据集设置
--data_path :hdf5 文件或包含 train 和 test 文件夹以及视频子目录的文件夹的路径 --resolution 128 :训练的空间分辨率 --sequence_length 16 :时间分辨率,或视频剪辑长度
重建
python rec_video.py --video-path "assets/origin_video_0.mp4" --rec-path "rec_video_0.mp4" --num-frames 500 --sample-rate 1 python rec_video.py --video-path "assets/origin_video_1.mp4" --rec-path "rec_video_1.mp4" --resolution 196 --num-frames 600 --sample-rate 1 