近期,上海交通大学听觉认知与计算声学实验室的论文“Attention-based Encoder-Decoder End-to-End Neural Diarization with Embedding Enhancer”被语音领域顶级期刊IEEE/ACM Transactions on Audio, Speech and Language Processing (TASLP) 接收。该论文首次将基于注意力机制的编码器-解码器结构成功应用于说话人日志任务。并提出了一系列方法解决了TS-VAD系统的两阶段复杂性问题,以及端到端说话人日志系统的收敛慢,难以泛化到训练过程中未见到的说话人个数的问题。基于论文中提出的新方法,该论文的系统在三个说话人日志标准数据集CALLHOME, DIHARD II, AMI上都取得了最优的结果。除了说话人日志任务,该论文提出的系统还可以被单独用作一个语音类型检测模型,并在相关任务上展现了极强的能力。

Attention-based Encoder-Decoder End-to-End Neural Diarization with Embedding Enhancer

作者列表:陈正阳,韩冰,王帅,钱彦旻

论文地址:https://ieeexplore.ieee.org/document/10438838


背景动机


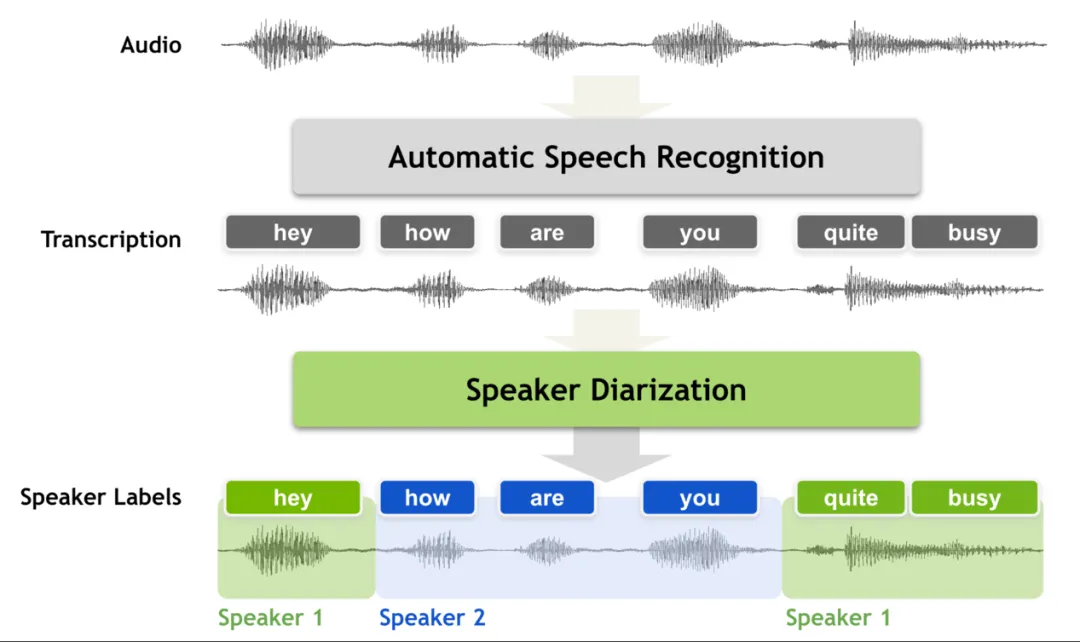
说话人日志(speaker diarization)任务旨在解决“谁在什么时候说了话“的问题。在多人语处理音场景中,是非常重要的前处理/后处理技术,以获得每个人的说话区域。为了解决说话人日志任务中的说话人语音重叠问题并充分利用神经网络的强大建模能力,越来越多的研究者将研究目光从传统的基于聚类的说话人日志算法转向基于神经网络的算法。在基于神经网络的方法中,有两大算法最受关注,(1)目标说话人语音检测(Target Speaker Voice Activity Detection, TS-VAD), (2)端到端说话人日志(End-to-End Neural Diarization, EEND)。其中,TS-VAD系统有着非常好的性能,被广泛应用于各种说话人日志比赛。但由于TS-VAD系统需要额外的说话人注册信息,所以一般需要一个额外的说话人日志系统提供初始的说话人日志结果,并通过额外的说话人嵌入网络提取说话人注册向量。这使得TS-VAD系统略显复杂。相比而言,EEND系统接受语音输入并直接输出说话人日志结果,有着极为简洁的架构。但是,现有的EEND系统往往基于说话人置换目标进行训练,收敛比较慢。而且,EEND系统很难泛化到训练集未见到的说话人个数的情况。为了解决上面两种方案存在的问题:
  • 我们首次成功地将基于注意力机制的编码器-解码器结构来解决说话人日志问题。
  • 我们提出将teacher-forcing策略用于训练过程,解决了传统EEND收敛慢的问题
  • 我们提出了一种迭代式的解码策略来逐个输出每个人的diarization结果
  • 我们提出了一种帧级别说话人嵌入特征的增强模块,可以使得网络更好的泛化到没有见过的说话人个数的情况。

方案

基于注意力-编码器-解码器架构的端到端说话人日志系统
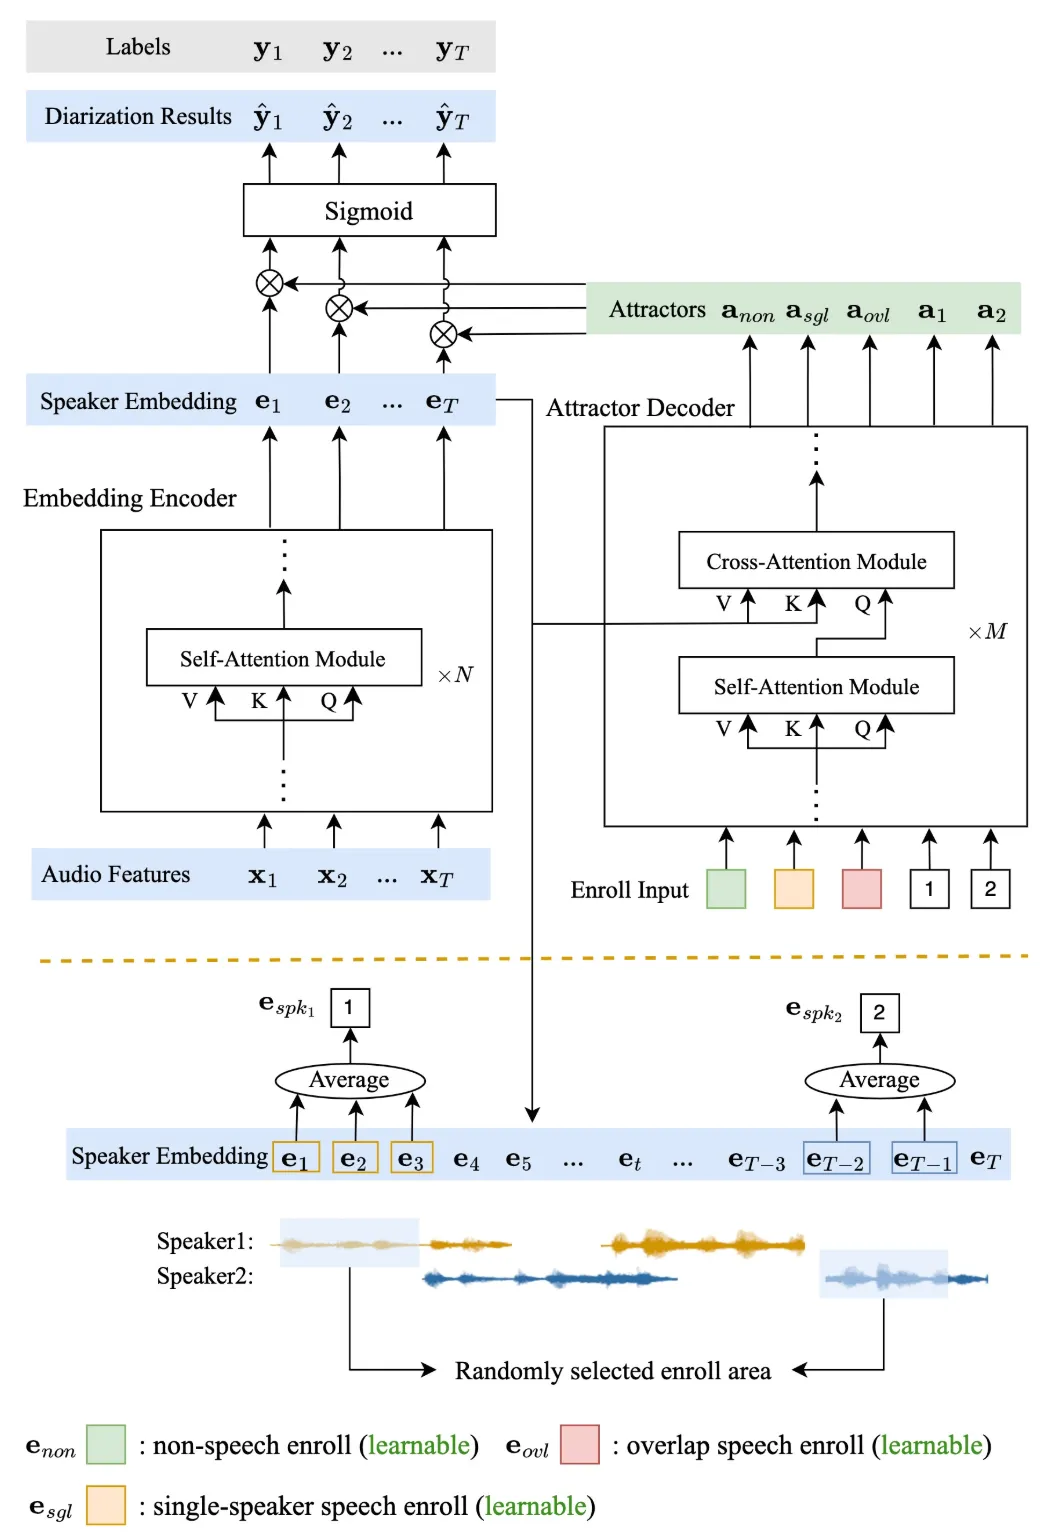
我们所提出的基于注意力-编码器-解码器架构的端到端说话人日志系统(AED-EEND)如图1所示。虚线的上部分显示了AED-EEND的编码器和解码器结构。左边的编码器是由一系列的自注意力模块堆叠而成,它以语音特征序列作为输入,并输出帧级别的说话人嵌入向量 (speaker embedding)。右边的解码器是由一些列自注意力模块和交叉注意力模块堆叠而成。解码器以说话人注册向量(Enroll)作为输入(含有数字1和2的方块分别代表说话人1和说话人2的注册向量),同时,对于交叉注意力模块,Enroll向量会被用作query, 编码器输出的帧级别speaker embedding会被用作key和value。这种设计方式可以使得帧级别speaker embedding信息被聚合到与之相关的Enroll向量的位置。最后,我们把加码器的输出命名为吸引子(attractor)。我们将每一个attractor独立地和帧级别的speaker embedding做内积,并通过sigmoid函数,便可以得到这个attractor对应说话人在每个时间点说话人的概率。
由于我们并不想像TS-VAD一样,通过外部的speaker Encoder来引入说话人Enroll向量。如虚线下面的图所示,我们直接通过平均帧级别speaker embedding中属于特定人的连续embedding序列得到这个人的Enroll向量。在训练过程中,由于我们知道说话人日志的真实标签,我们可以通过标签随机选取属于特定人的单人语音区域对应的speaker embedding序列来进行平均。这种在训练过程中使用真实标签来辅助训练的方式很像语音识别任务中的teacher-forcing策略,我们也把我们这种训练策略命名为teacher-forcing。
此外,图中还有三个彩色的Enroll向量。这三个向量是三个可学习的向量,在训练过程中会被更新。分别代表了非语音(non-speech), 重叠语音(overlap speech)和单人语音(single-speaker speech)的Enroll向量。也就是说,这三个注册向量输出的attactor和speaker embedding做内积并过sigmoid,会得到特定语音类型在每个时刻的概率。

图1 AED-EEND结构示意图

帧级别说话人嵌入特征增强模块

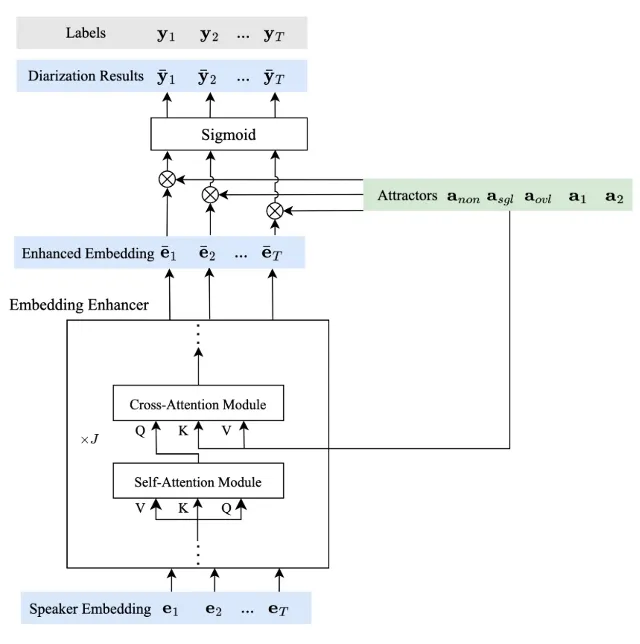
论文[4]显示,在只包含1-4说话人的仿真数据集上训练的EEND模型,在真实数据上很难泛化到更多的说话人个数的情况。我们发现,帧级别的speaker embedding其实只建模了相对的说话人身份信息,并没有建模绝对的说话人身份。这种相对说话人身份的区分能力,往往取决于仿真数据集中的最大说话人个数。为了增强帧级别speaker embedding的说话人身份区分能力,我们在图2中设计了一个与图1 Decoder对称的结构。这里我们把帧级别speaker embedding作为query输入到交叉注意力模块,而把attractor作为key和value。这样我们就能更好地把attractor的信息聚合到帧级别speaker embedding, 从而提升帧级别speaker embedding的说话人区分性。

图2:帧级别说话人嵌入特征增强模块

迭代式解码策略

迭代流程总览

在训练过程中我们通过真实标签得到了每个人的Enroll向量,在测试过程中,我们同样可以参照TS-VAD [1]系统,先使用一个额外的说话人日志系统得到初始说话人日志结果。并根据每个人单人说话的区域得到每个人的Enroll向量,但这种方式会引入额外的系统,为了解决这个问题,我们这里提出了一种迭代式解码策略。
如图3所示,在每次迭代过程中,我们会输出一个新的人的说话人日志结果, 在每一次的迭代过程共有三个关键步骤:
1. 计算未被预测的单人区域(黑色线)
  • 在第一次迭代过程中,可以输入图1中的single-speaker speech enroll得到
  • 在后续的迭代过程中,可以通过之前未被预测的单人区域减去最新预测结果中的单人区域得到
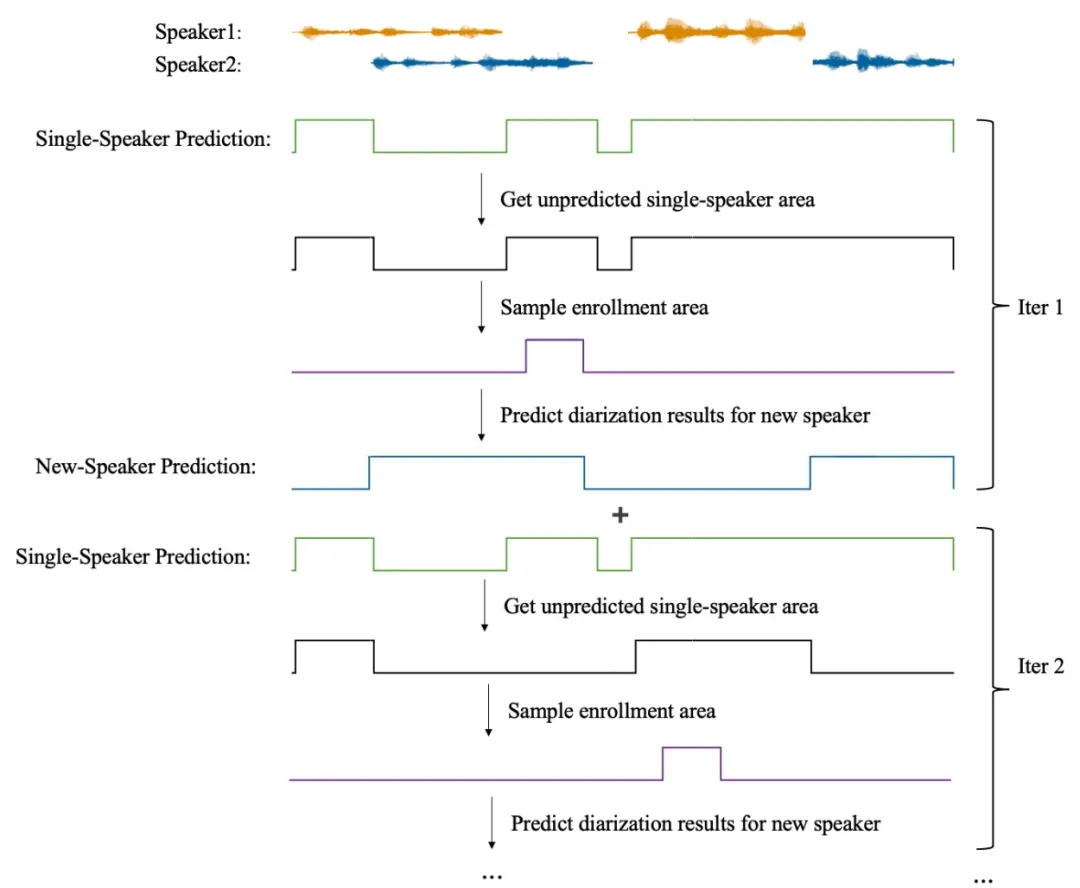
2. 从未被预测的单人区域中采样部分连续区域(紫色线条)作为新的人的注册区域,并得到对应的Enroll向量
3. 将Enroll向量输入系统得到attractor,并和帧级别speaker embedding做内积得到这个人的说话人日志结果
4. 重复以上步骤直至达到结束条件


图3 迭代式解码策略


注册区域采样策略

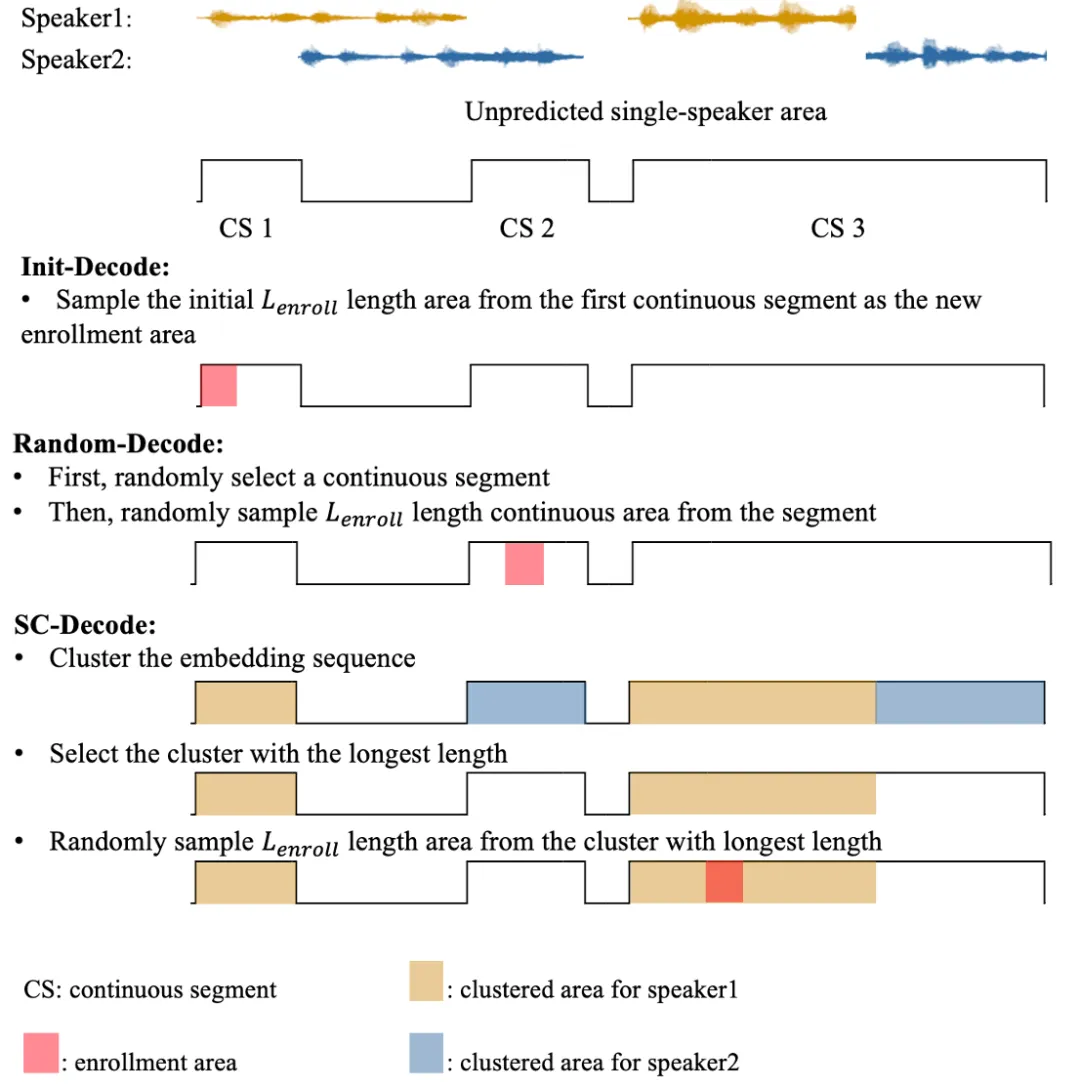
在解码过程的第2步,我们需要从未被预测的单人语音区域采样一个连续的只包含一个人的区域作为新的人的注册区域。在图4中,我们首先会把未被预测的单人语音区域分为几个连续的区域(图中的CS1, CS2, CS3), 基于这个分割,我们提出了三种注册区域采样策略:
• Init-Decode: 在这个采样策略中,CS1的初始Lenroll长度的部分会被用作注册区域。在测试过程中,Lenroll会被设定的非常短,以保证注册区域指包含一个人。
• Random-Decode:在这个采样策略中,我们首先会随机选取一个连续的区域,比如CS2, 然后从CS2中随机选取Lenroll长度作为注册区域。
SC-Decode: 前两个采样策略并没有对注册区域中只有一个人这个假设做显示的限制。在这个采样策略中,我们首先会对所有的未被预测的单人区域部分对应的speaker embedding做谱聚类,然后选取类别长度最长的那个区域随机采样Lenroll的部分作为注册区域。然而,SC-Decode因为需要对整个未被预测的单人区域做聚类,速度较慢。为此,我们还提出了SC-Decode-Local, 在这个采样策略中,我们只对最长的连续区域(图中的CS3)做聚类,同样选取最长的类别做采样。


图4 注册区域采样策略


迭代式解码停止策略

在解码过程中,我们会事先设定一个停止解码长度(SDL),如果图三中最长的连续区域(CS3)小于了SDL,则停止解码。在测试过程中,我们把SDL设为了1s,也就是说,我们认为,一个人一旦参与了某段对话,他最短的连续单人说话人的长度会大于1s。


实验

实验数据以及配置

仿真数据

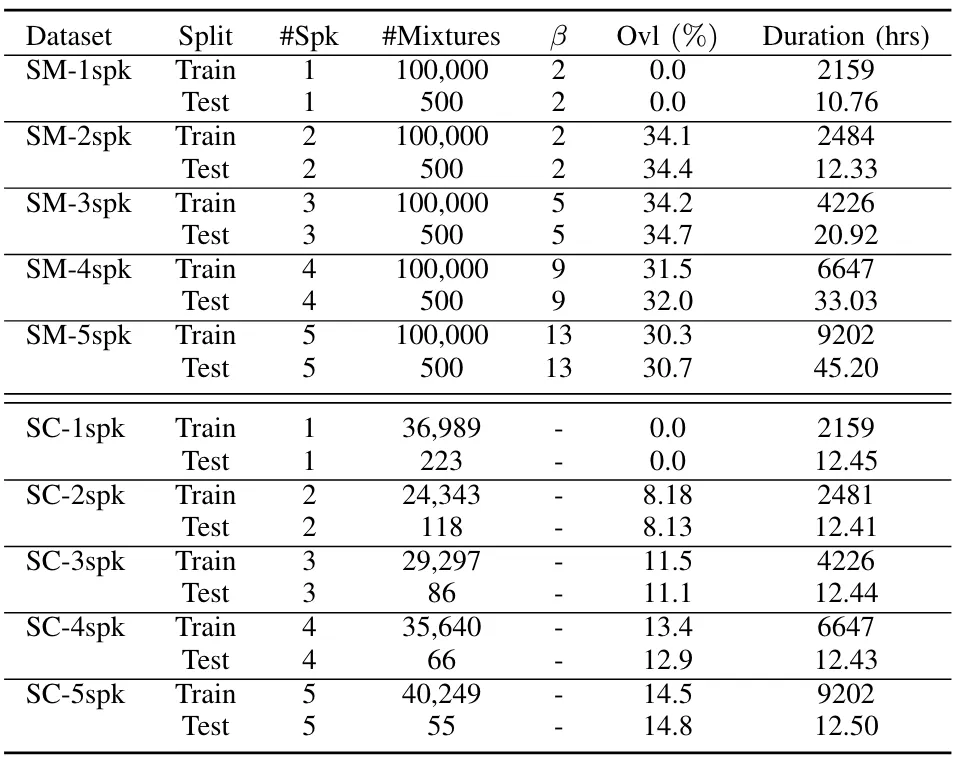
端到端说话人日志系统往往需要大量的有标注数据进行训练,而真实的有标注数据往往比较少。为此我们基于NIST SRE和Switchboard仿真了一些数据。如图表1所示,我们首先根据论文[2]的仿真策略,仿真了每个句子中有1-5个人的SM (simulation mixture)数据。然而,SM的数据的语音重叠比例往往比较高,与真实数据低重叠率有一些不匹配。同时,我们还参考论文[6]仿真了不同说话人个数的SC(Simulation Conversion)数据,以更好地匹配真实数据的语音重叠比例。

表1 仿真数据


真实数据

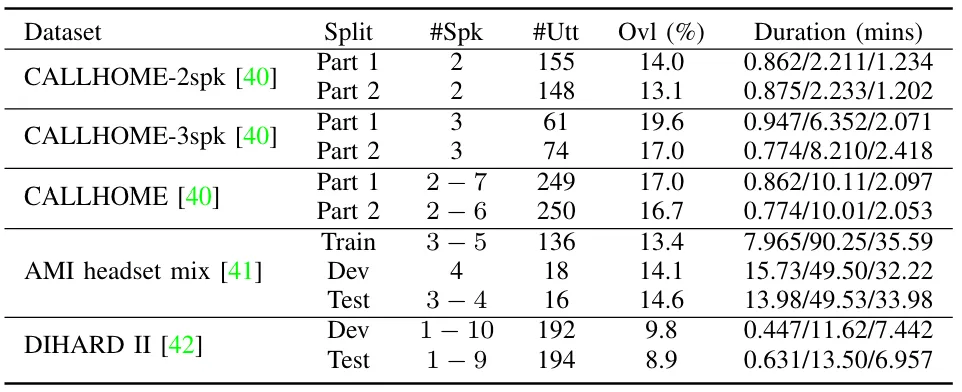
基于仿真数据训练好的模型,我们会进一步将模型在真实数据上进行微调并测试。如表2所示,我们将使用来自CALLHOME,AMI和DIHARDII的数据进行微调和测试。

表2 真实数据


实验结果

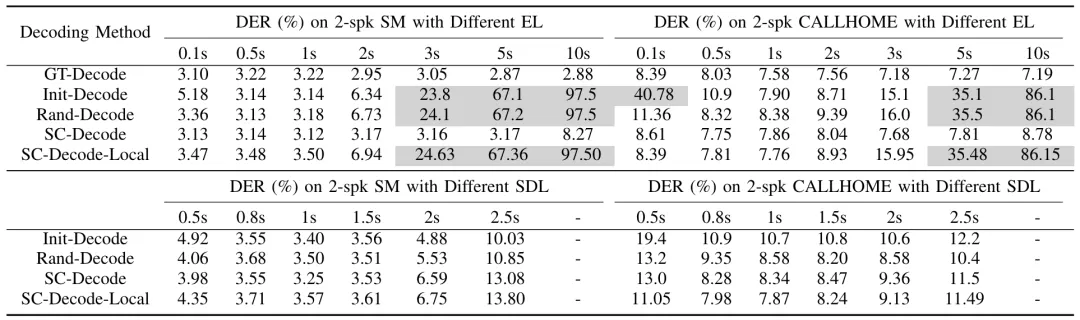
不同的预测解码策略比较

首先我们比较了不同的解码策略。在比较的过程中,我们使用了不同的注册长度(EL),和不同的停止解码长度(SDL)。我们发现不同的解码算法在0.5s/1s的注册长度下都能取得不错的效果。同时,将1s作为停止解码长度对于所有算法是一个比较鲁棒的选择。另外,因为SC-Decode-Local在真实数据上兼具解码速度和性能的优势,在后续实验中,将被用作默认的解码策略。

表3 不同的解码策略比较


固定说话人个数情况的结果比较

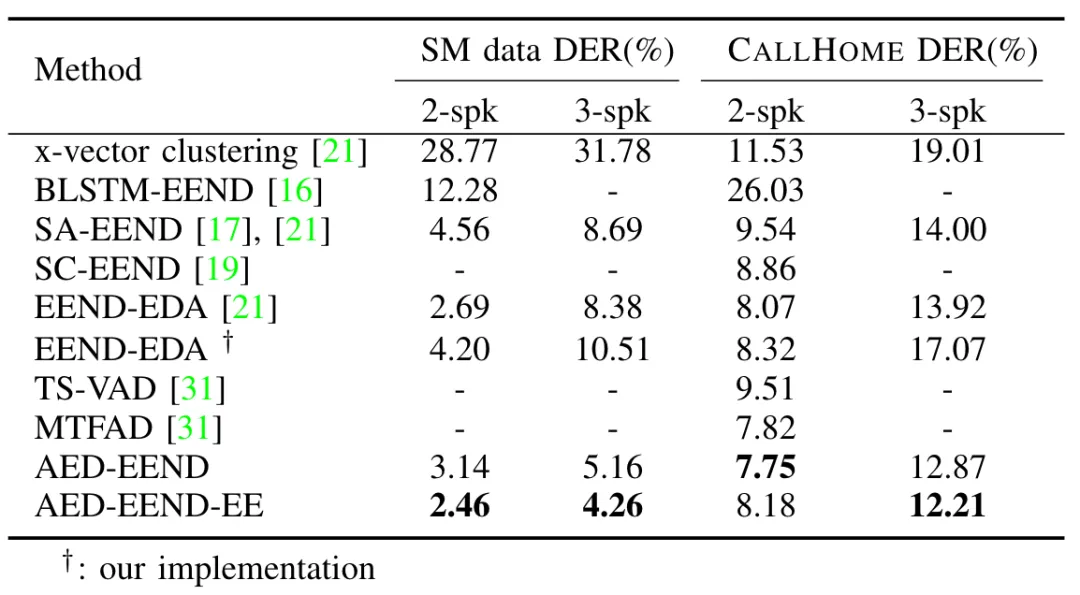
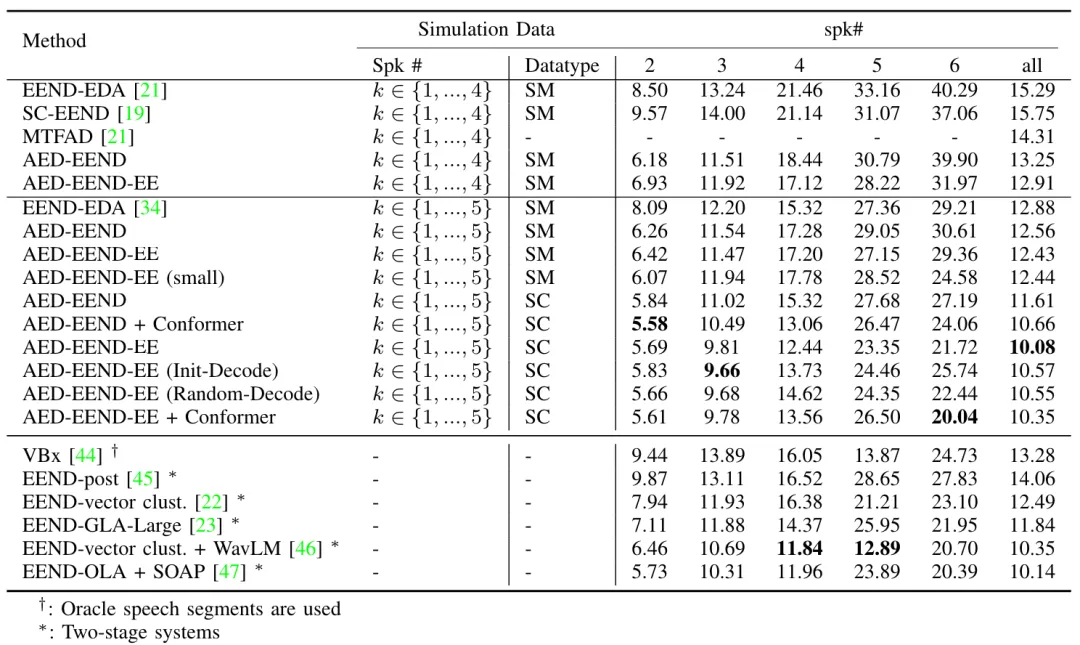
从表4可以看到,我们提出的AED-EEND模型和AED-EEND-EE模型在仿真数据集上的性能远超其他模型。AED-EEND模型在真实CALLHOME数据集上的性能也超过了其他模型。而AED-EEND-EE模型在2-spk CALLHOME数据集上的性能略有下降。这是因为SM仿真数据集的语音重叠率和CALLHOME有着较大的差异,AED-EEND-EE更加强大的建模能力,导致其在SM数据上有些过拟合。

表4 固定说话人个数情况下的结果比较


不定说话人个数情况的结果比较

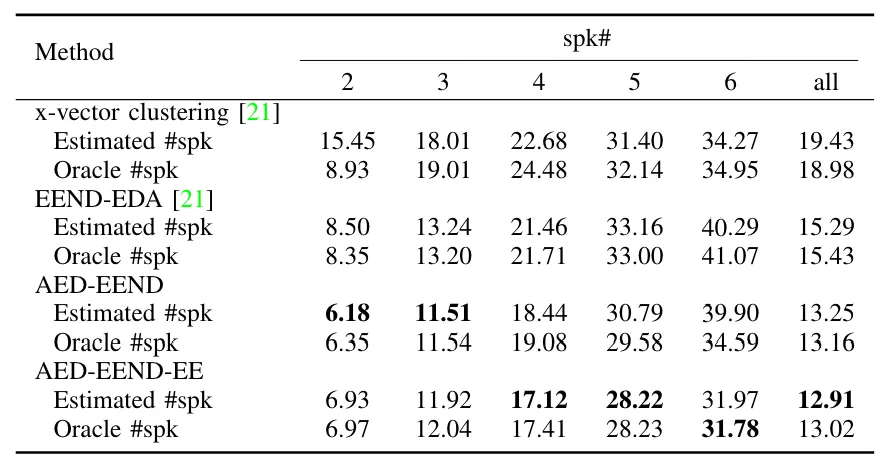
表5显示,在不定说话人个数情况下,我们提出的两个系统都优于其他系统。我们还比较了系统在知道句子说话人个数(Oracle #spk)和需要估计说话人个数(Estimated #spk)情况下的性能。结果显示,是否知道提前知道每个句子的说话人个数对最终性能影响不大,也就是说我们的系统可以准确的估计每个句子的说话人个数。EEND-EDA作者[4]指出,在1-4个speaker仿真数据集上训练的EEND-EDA模型很难在真实场景泛化到更多的说话人。我们提出的AED-EEND也有相似的问题。为此,我们提出了AED-EEND-EE系统来增强模型在这方面的能力,结果显示,在使用了AED-EEND-EE模型之后,模型在5-6个speaker上的泛化能力更好了。

表5 不定说话人个数情况下CALLHOME数据集上的结果对比


训练收敛速度比较
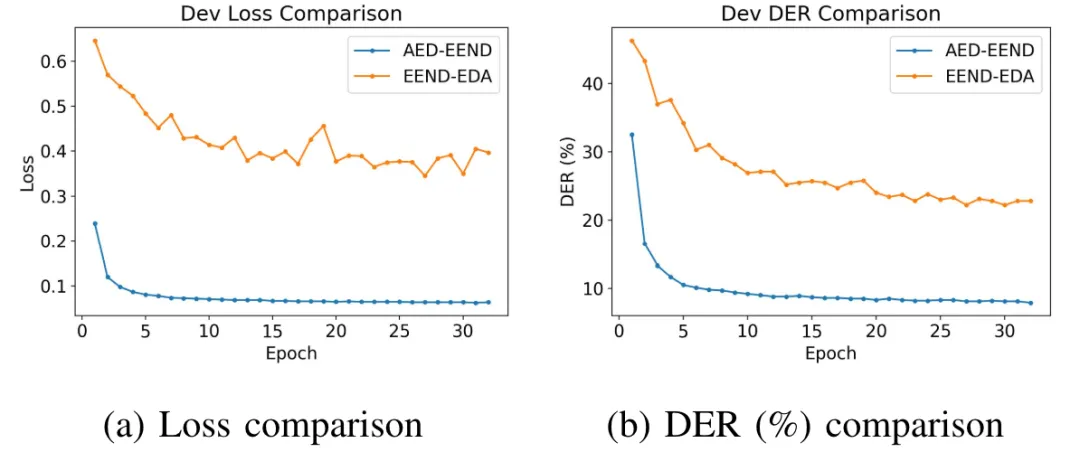
较多数端到端说话人日志系统[2,3,4]使用说话人置换损失函数进行训练,使用这个损失函数需要在训练过程中去计算输出与标签之间的最优匹配,然后计算损失函数。这个过程会使得训练变难,收敛较慢。而我们在训练的时候,提出了使用teacher forcing策略,使用这个策略会提前决定好每个speaker对应的说话人日志结果输出顺序,也就不存在说话人置换问题。图5显示了我们的算法和经典EEND-EDA系统之间的收敛速度。可以发现,我们的系统在摆脱了说话人置换问题之后,收敛速度大大提升。


图5 收敛速度比较


使用不同类型仿真数据的比较

在端到端说话人日志系统中经常使用的SM仿真数据和真实数据在重叠率上有着较大的差异。这里,我们尝试使用与真实数据语音重叠率更加匹配的SC仿真数据。表6显示,使用SC数据的系统比使用SM数据的系统有着更好的性能。同时,基于SC数据训练的AED-EEND-EE系统的优势更加明显,在CALLHOME数据集上取得了最优的性能。

表6 CALLHOME数据集上不同系统的结果比较


其他真实数据集上的性能测试
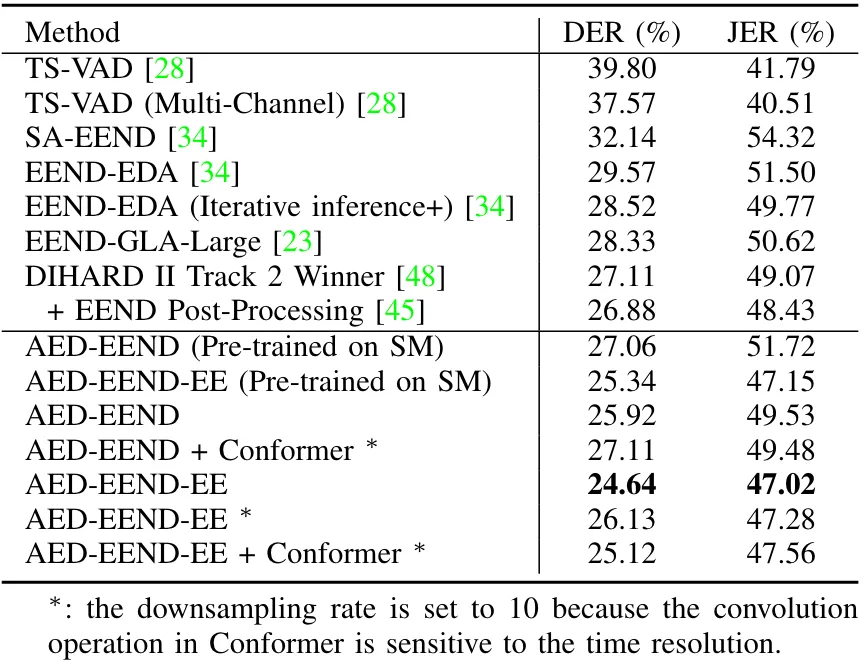
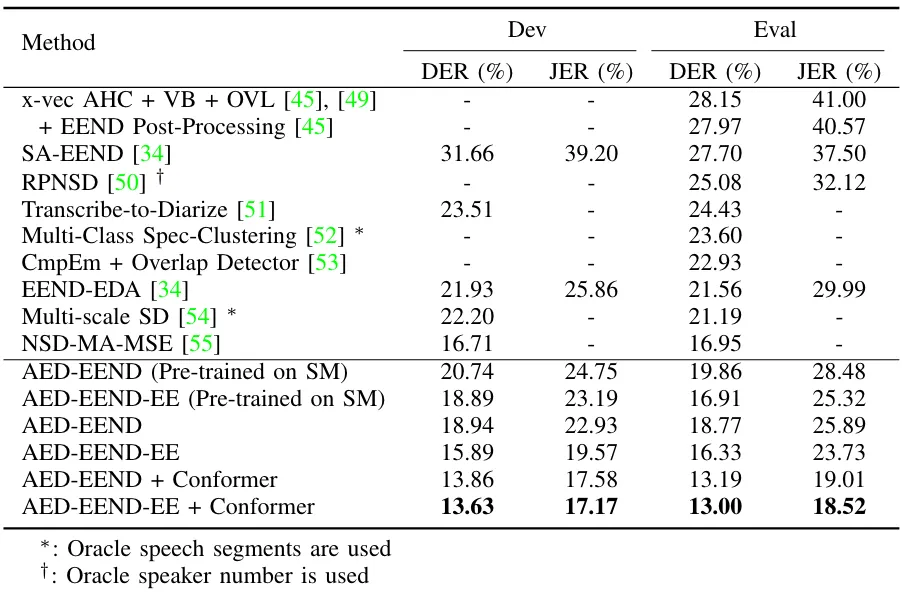
在表7和表8中,我们在DIHARD II和AMI数据集上和其他系统的结果进行了比较。结果显示,我们提出的方法具有很好的泛用性,在不同的真实数据集上都取得了最好的结果。

表7 DIHARDII数据集上不同系统的结果比较


表8 AMI数据集上不同系统的结果比较


AED-EEND系统在语音类型检测任务上的表现
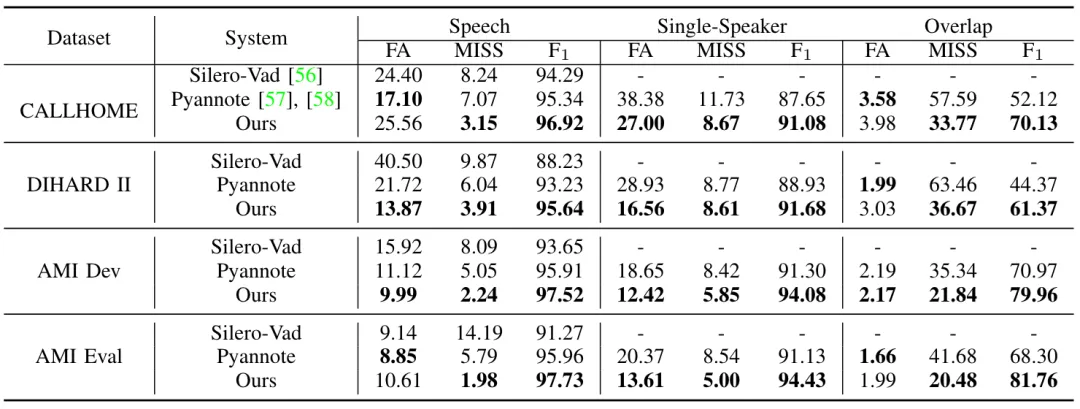
方法部分我们指出,我们的AED-EEND模型还可以直接被用作语音类型检测任务,即检测非语音,单人语音和重叠语音片段。在表9中,我们和开源工具Silero-Vad和Pyannote进行了比较, 比较发现,我们的系统在整体的F1评价指标上,都有着最好的性能。

表9 AED-EEND系统在语音类检测任务上的性能比较


总结

在本论文中,我们提出了基于注意力-编码器-解码器结构的端到端说话人日志系统(AED-EEND)来解决两个经典说话人日志系统,TS-VAD和EEND,所存在的问题。在文中,我们提出了teacher-forcing训练策略解决了EEND使用说话人置换损失收敛慢问题。提出了一个迭代式解码算法解决了TS-VAD系统需要额外说话人日志系统辅助的问题。提出了一个帧级别说话人嵌入特征增强模块,解决了EEND难以泛化到训练集之外的说话人个数的问题。另外,我们还提出使用与测试集在说话人重叠率上更加匹配的仿真数据来进一步提升性能。基于以上策略,我们的系统在CALLHOME, DIHARD II和AMI三个说话人日志数据集上都取得了最优的性能。此外,我们的系统还可以单独用作语音类型检测模型,并表现了极强的性能。


参考文献

[1] I. Medennikov, M. Korenevsky, T. Prisyach, Y. Khokhlov, M. Korenevskaya, I. Sorokin, T. Timofeeva, A. Mitrofanov, A. Andrusenko, I. Podluzhny, A. Laptev, and A. Romanenko, “Target-Speaker Voice Activity Detection: A Novel Approach for Multi-Speaker Diarization in a Dinner Party Scenario,” in Proc. Interspeech 2020, 2020, pp. 274– 278.

[2] Y. Fujita, N. Kanda, S. Horiguchi, K. Nagamatsu, and S. Watanabe, “End-to-End Neural Speaker Diarization with Permutation-Free Objectives,” in Proc. Interspeech 2019, 2019, pp. 4300–4304.

[3] Y. Fujita, N. Kanda, S. Horiguchi, Y. Xue, K. Nagamatsu, and S. Watanabe, “End-to-end neural speaker diarization with self-attention,” in 2019 IEEE Automatic Speech Recognition and Understanding Workshop (ASRU). IEEE, 2019, pp. 296–303.

[4] S. Horiguchi, Y. Fujita, S. Watanabe, Y. Xue, and K. Nagamatsu, “End-to-End Speaker Diarization for an Unknown Number of Speakers with Encoder-Decoder Based Attractors,” in Proc. Interspeech 2020, 2020, pp. 269–273.

[5] S. Horiguchi, Y. Fujita, S. Watanabe, Y. Xue, and P. Garcia, “Encoder-decoder based attractors for end-to-end neural diarization,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 30, pp. 1493–1507, 2022.

[6] F. Landini, A. Lozano-Diez, M. Diez, and L. Burget, “From Simulated Mixtures to Simulated Conversations as Training Data for End-to-End Neural Diarization,” in Proc. Interspeech 2022, 2022, pp. 5095–5099.