
 西工大音频语音与语言处理研究组
论文题目:Enhancing Lip Reading with Multi-Scale Video and Multi-Encoder
作者列表:王贺,郭鹏程,万旭成,周欢,谢磊
合作单位:华为
ChatCLR竞赛:https://mispchallenge.github.io/ICME2024/index.html
随着深度学习技术的发展,语音识别(ASR)已经取得了显著的进步,在许多开源基准测试中已经达到甚至超过了人类水平。然而,在现实世界场景中,如家庭聚会、鸡尾酒会或多人会议等嘈杂背景或远距离录音条件下,ASR系统的性能往往会明显下降。此外,在无声语音接口或辅助语音障碍人群的应用中,自动唇语识别(ALR)越来越受到学术界和工业界研究者的关注。
目前,已经有许多针对ALR或音将视觉特征整合到ASR系统中的视听语音识别(AVSR)研究。在研究初期,Transformer凭借其强大的序列建模能力被广泛用作许多研模主干 [1, 2]。然而,随着Conformer的提出,其逐渐取代了Transformer,成为无论在ALR [3]还是AVSR [4]研究中的主流选择。尽管近几年出现了大量ALR或AVSR的研究,但大多集中在英语上,对中文唇语识别的研究甚少。造成这一现象的一个重要原因,便是缺乏一个具有一定规模的中文唇语识别数据集。自2021年起,多模态信息语音处理(MISP)挑战系列 [5, 6, 7]已成功举办三届,推动了中文音视频语音信号处理研究,并发布了具有挑战性的中文音视频数据集。此外,2023年中文连续视觉语音识别挑战赛(CNVSRC)的成功举办,进一步促进了中文唇语识别的研究,同时发布了更大量(超过300小时)的中文音视频数据集 [8]。然而,由于其数据来源范围主要是专业播音员、演讲者或博主,对于面向大众的通用唇语识别具有一定的局限性。
喜报!西工大ASLP-理想汽车联队夺冠NCMMSC2023视觉语音识别竞赛
引入了一种基于说话人脸部大小提取多尺度嘴唇动作视频的算法。 提出了一个基于ResNet和三维卷积的Ehanced ResNet3D视觉前端模块。 系统地比较了不同视觉编码器和视频数据尺度对ALR性能的影响。 方案在ICME2024 ChatCLR赛道2测试集上的字符错误率(CER)比基线绝对降低了21.52%,取得了赛道第二名的优异成绩。
多尺度唇动数据提取
目前许多研究 [10, 12]表明,唇语识别系统的性能不仅取决于说话人嘴唇的运动。脸颊、下巴甚至额头的视觉信息可以提高识别准确性。此外,根据我们在CNVSRC 2023中提出的冠军方案 [10],围绕嘴唇的视频的感受野的增加会提高ALR系统的性能。然而,我们当时通过对每个视频帧的唇部ROI进行固定的尺寸调整(从48到112)的方法没有考虑到所有说话人脸部大小或摄像机与说话人之间的距离的差异。这样会导致即使使用相同的裁剪大小,可能导致所获得的不同说话人的唇动视频涵盖的面部区域不一致的问题。
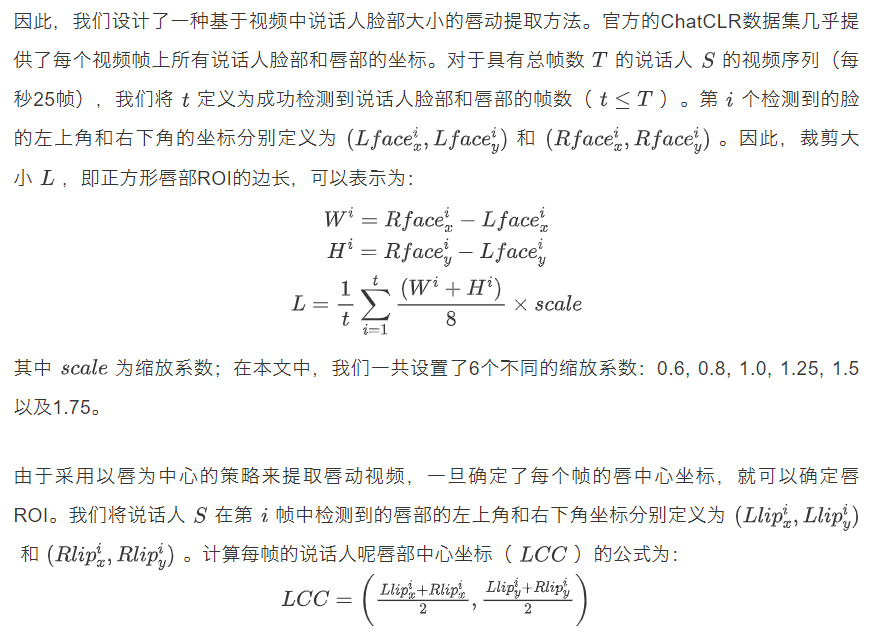
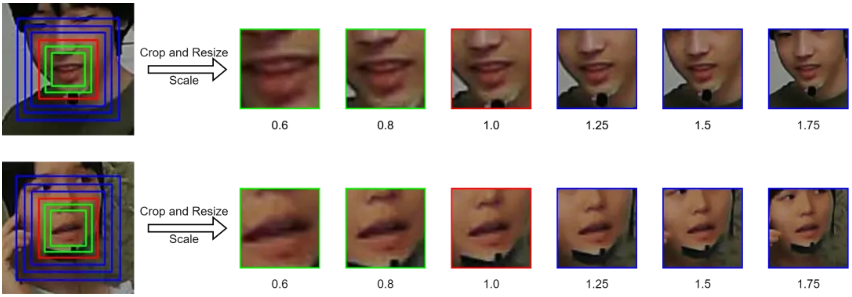
图1展示了在不同的缩放系数下,提取到的两位说话人的唇动视频。可以观察到,当缩放系数设置为0.6或0.8时,提取的唇动数据几乎只包含说话人的嘴唇。随着缩放系数的增加,下巴、脸颊、鼻子和眼睛等区域会逐渐进入以嘴唇为中心的ROI。
Enhanced ResNet3D 视觉前端
图2展示了我们提出的Enhanced ResNet3D视觉前端的详细结构。总体模块设计受经典图像特征提取网络ResNet的启发,不同之处在于我们用三维卷积(Conv3D)替换了ResNet中的二维卷积,建模输入的三维视频数据。Ehanced ResNet3D视觉前端主要由三个部分组成,即用于将输入视频数据的特征通道映射到更高维度的Input Conv3D,用于在最终对视频高宽维度进行平均的AvgPooling,以及中间部分中建模视觉特征的ResNet3D堆叠模块。ResNet3D的每一层都由几个基本模块组成,如图2(b)所示。这些基本模块主要由堆叠的Conv3D和归一化组成,构成视频特征建模单元。此外,每个ResNet3D块中的第一个基本模块对输入的视觉特征进行高度和宽度上的两倍下采样,并映射到更高的特征通道。
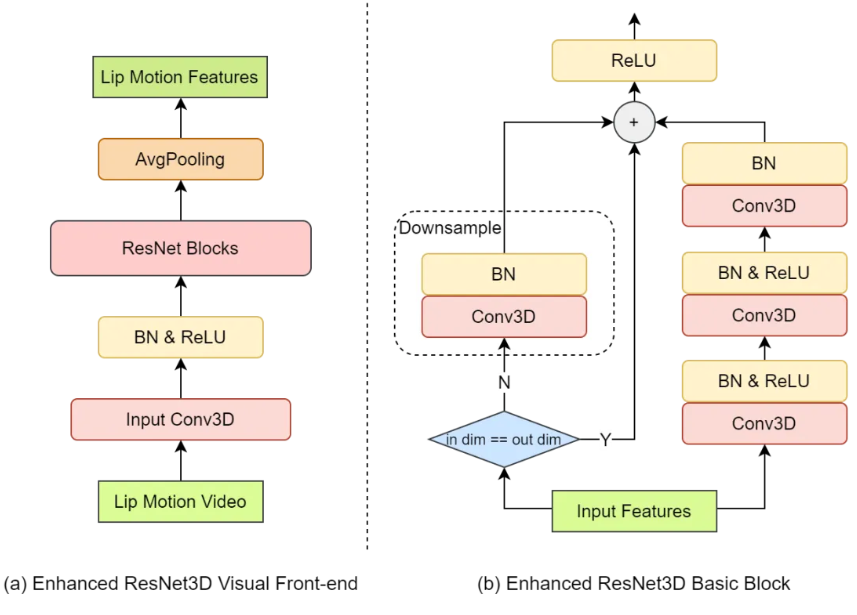
图2 (a) 提出的Ehanced ResNet3D 视觉前端和 (b) 其基本模块
多系统构建和融合
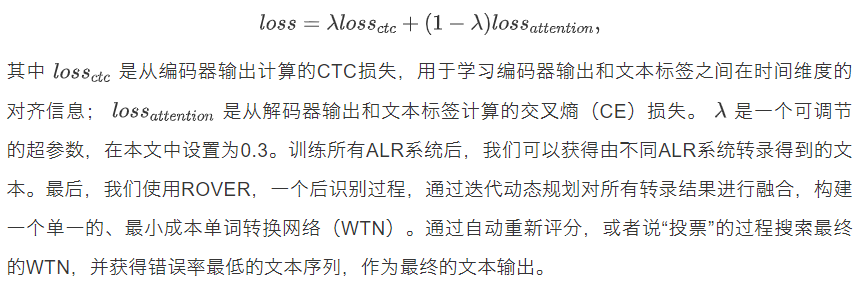
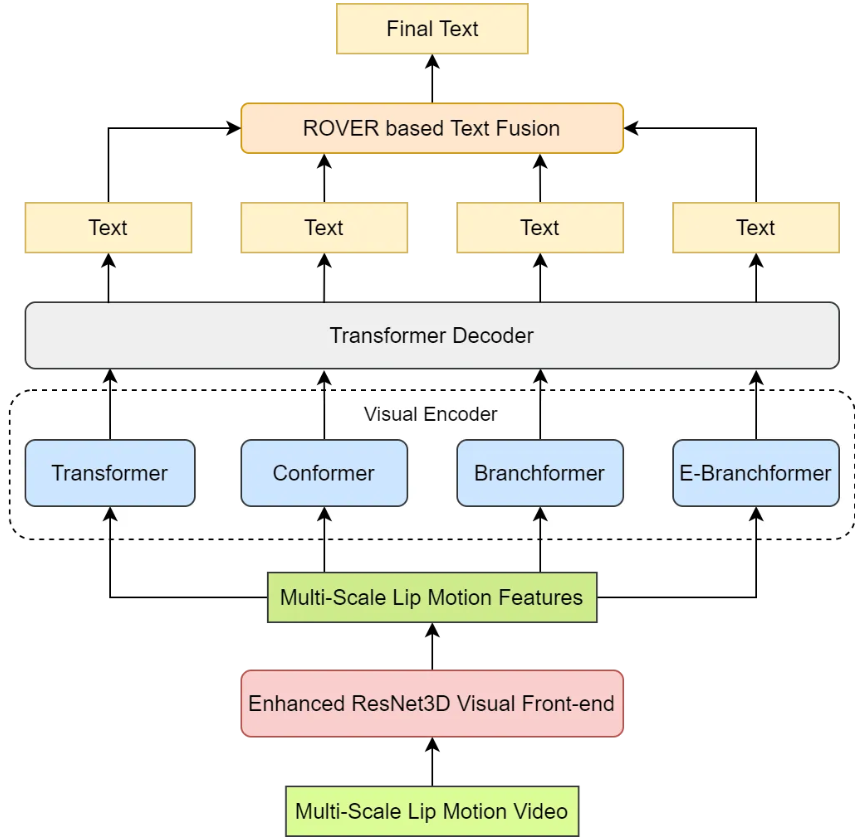
图3 提出的用于自动唇语识别的多系统融合方案
数据处理
数据集:本文中所有的ALR系统都是使用ChatCLR挑战赛任务2发布的训练和开发数据集构建的。训练、开发和测试集分别包括110.95小时、4.5小时和2.41小时的自由对话视频数据。录制设备为一台分辨率为1080P的摄像头,配有120度广角镜头,距离说话人3到5米,同时录制每个说话人的面部信息。对于所有录制的视频数据,挑战赛官方提供了几乎每一帧所有说话人的脸部和嘴唇坐标。
模型配置
训练策略
结果与分析
不同视觉编码器性能探索
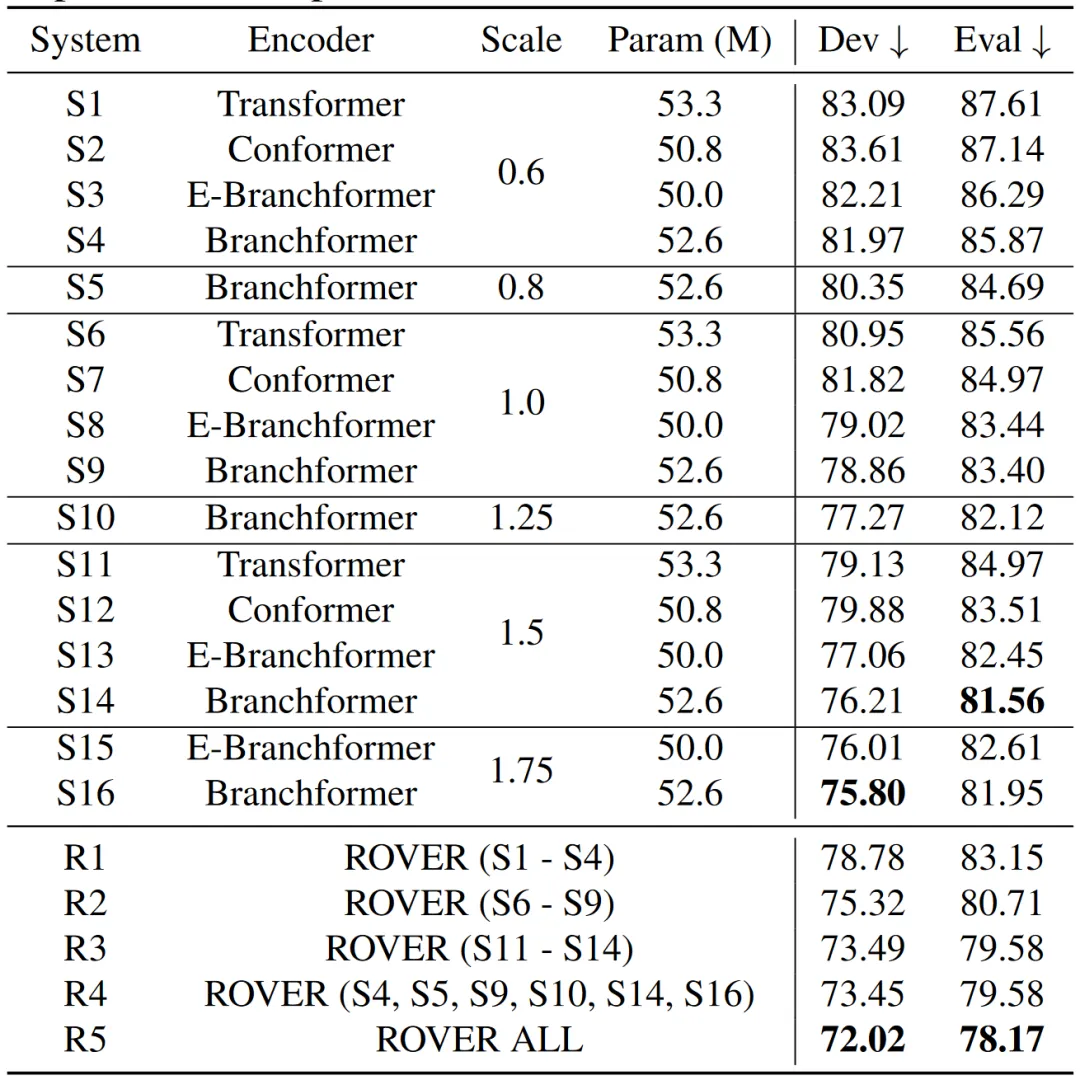
表1 ALR系统和ROVER融合系统在验证集(Dev)和测试集(Eval)上的CER(%)结果
不同唇动视频尺寸探索
正如上一小节分析,基于Branchformer编码器的ALR系统表现最佳。因此,我们将Branchformer作为视觉编码器,进行了数据尺度对比实验,包括6个数据尺度:0.6、0.8、1.0、1.25、1.5和1.75。结果如表1所示。可以观察到,在0.6到1.5的数据尺度范围内,用于模型训练和推理的唇动视频数据尺度越大,ALR系统的性能越好。基于1.5尺度数据构建的Branchformer编码器系统(S14)与使用0.6尺度数据的系统(S4)相比,在测试集上的CER降低了4.31%。然而,随着数据尺度从1.5增加到1.75,基于Branchformer(S16)和EBranchformer(S15)编码器的ALR系统性能有所回退,在测试集上的CER分别增加了0.39%和0.16%。综上,在相同的视觉编码器下,基于1.5尺度的唇动视频数据构建的ALR系统表现最佳。
多系统融合带来的收益
为了全面展示基于ROVER的多系统融合带来的收益,如表1所示,我们不仅融合所有ALR系统(R5),还融合使用不同编码器构建的ALR系统(R1、R2、R3),以及使用相同编码器但不同尺度数据构建的ALR系统(R4)。首先,我们对基于四种视觉编码器构建的0.6尺度视频数据的ALR系统进行融合。融合结果R1与0.6尺度上表现最佳的ALR系统(S4)相比,在测试集上的CER降低了2.72%。类似地,融合所有基于1.0尺度(R2)和1.5尺度数据(R3)构建的ALR系统,与1.0尺度(S9)和1.5尺度(S14)上表现最佳的系统相比,CER分别减低了2.69%和1.98%的。此外,基于Branchformer编码器构建但使用不同尺度数据的所有ALR系统的融合结果(R4)与最佳系统(S14)相比,CER减少了1.98%。这些结果充分表明,无论是对于使用不同视觉编码器还是不同数据尺度构建的ALR系统,通过ROVER进行文本融合都可以取得显著的改进。最后,融合所有ALR系统的结果(R5)在测试集上取得78.17%的CER,与表现最佳的单系统(S14)相比,降低了3.39%。
消融实验
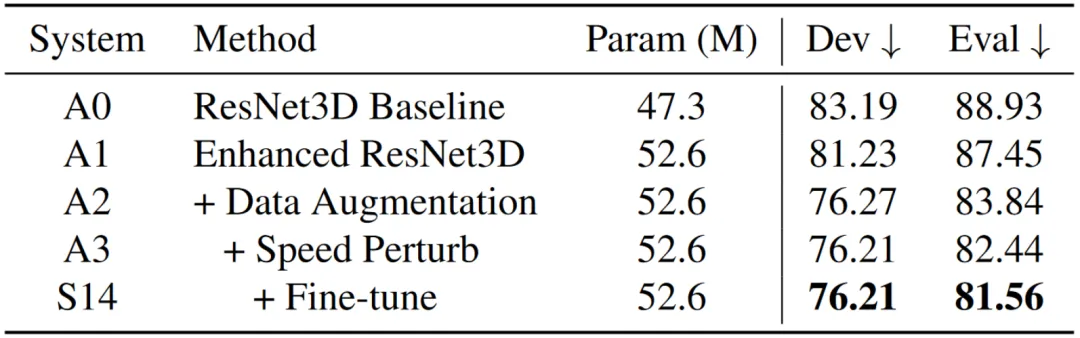
为了验证提出的Enhanced ResNet3D视觉前端、数据增强、速度扰动和微调的有效性,我们基于Branchformer编码器使用1.5尺度视频数据进行了消融实验。消融结果如表2所示。A0是基于我们之前提出的ResNet3D视觉前端和Branchformer的ALR系统,我们在ChatCLR挑战赛数据集上进行了复现。而A1则用我们提出的Enhanced ResNet3D视觉前端,测试集上的CER相对于A0降低了1.48%。值得注意的是,进一步采用随机数据增强策略的系统A2和A1的结果进行比较,测试集上的CER显著降低了3.61%。此外,对训练集进行速度扰动后,系统A3相对于A2也实现了1.4%的CER减小。最后,在与测试集相同说话人的训练集数据和验证集数据的90%进行微调后,系统S14实现了最佳的单系统性能,与A3相比,将测试集上的CER进一步降低了0.88%。
表2 消融实验在验证集(Dev)和测试集(Eval)上的CER(%)结果
[1] Yong-Hyeok Lee, Dong-Won Jang, Jae-Bin Kim, RaeHong Park, and Hyung-Min Park, “Audio-visual Speech Recognition based on Dual Cross-modality Attentions with the Transformer Model,” Applied Sciences, vol. 10, no. 20, pp. 7263, 2020.
[2] Dmitriy Serdyuk, Otavio Braga, and Olivier Siohan, “Transformer-based Video Front-ends for AudioVisual Speech Recognition for Single and Multi-person Video,” arXiv preprint arXiv:2201.10439, 2022.
[3] Oscar Chang, Hank Liao, Dmitriy Serdyuk, Ankit Shahy, and Olivier Siohan, “Conformer is All You Need for Visual Speech Recognition,” in Proc. ICASSP. IEEE, 2024, pp. 10136–10140.
[4] Pingchuan Ma, Alexandros Haliassos, Adriana Fernandez-Lopez, Honglie Chen, et al., “Auto-AVSR: Audio-Visual Speech Recognition with Automatic Labels,” in Proc. ICASSP. IEEE, 2023, pp. 1–5.
[5] Hang Chen, Hengshun Zhou, Jun Du, Chin-Hui Lee, Jingdong Chen, Shinji Watanabe, Sabato Marco Siniscalchi, Odette Scharenborg, et al., “The first Multimodal Information based Speech Processing (MISP) Challenge: Data, Tasks, Baselines and Results,” in Proc. ICASSP. IEEE, 2022, pp. 9266–9270.
[6] Zhe Wang, Shilong Wu, Hang Chen, Mao-Kui He, Jun Du, Chin-Hui Lee, Jingdong Chen, et al., “The Multimodal Information based Speech Processing (MISP) 2022 Challenge: Audio-Visual Diarization and Recognition,” in Proc. ICASSP. IEEE, 2023, pp. 1–5.
[7] Shilong Wu, Chenxi Wang, Hang Chen, Yusheng Dai, Chenyue Zhang, Ruoyu Wang, Hongbo Lan, Jun Du, Chin-Hui Lee, Jingdong Chen, et al., “The Multimodal Information based Speech Processing (MISP) 2023 Challenge: Audio-Visual Target Speaker Extraction,” in Proc. ICASSP. IEEE, 2024, pp. 8351–8355.
[8] Chen Chen, Dong Wang, and Thomas Fang Zheng, “CN-CVS: A Mandarin Audio-Visual Dataset for Large Vocabulary Continuous Visual to Speech Synthesis,” in Proc. ICASSP. IEEE, 2023, pp. 1–5.
[9] He Wang, Pengcheng Guo, Pan Zhou, and Lei Xie, “MLCA-AVSR: Multi-Layer Cross Attention Fusion Based Audio-Visual Speech Recognition,” in Proc. ICASSP, 2024, pp. 8150–8154.
[10] He Wang, Pengcheng Guo, Wei Chen, Pan Zhou, and Lei Xie, “The NPU-ASLP-LiAuto System Description for Visual Speech Recognition in CNVSRC 2023,” arXiv preprint arXiv:2401.06788, 2024.
[11] Jonathan G Fiscus, “A Post-processing System to Yield Reduced Word Error Rates: Recognizer output voting error reduction (ROVER),” in Proc. ASRU. IEEE, 1997, pp. 347–354.
[12] Yuanhang Zhang, Shuang Yang, Jingyun Xiao, Shiguang Shan, and Xilin Chen, “Can we read speech beyond the lips? Rethinking ROI Selection for Deep Visual Speech Recognition,” in 2020 15th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2020). IEEE, 2020, pp. 356–363.
