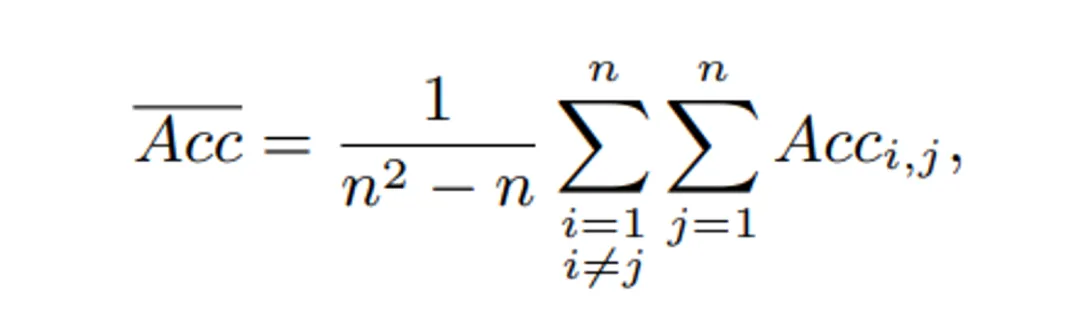语音小管家
EmoBox主要包括两部分:
EmoBox Toolkit:我们精心设计了不同数据集的数据划分,并提供数据处理脚本和数据加载代码。
EmoBox Benchmark:展示了在32个情感数据集、14种语言上10个预训练语音模型的语料内语音情感识别结果,以及在4个数据集上具有完全平衡测试集的跨语料语音情感识别结果。据我们所知,这是语言范围和数量规模来说最大的语音情感识别基准测试。
论文地址:https://arxiv.org/abs/2406.07162
Github:https://github.com/emo-box/EmoBox
Benchmark:https://emo-box.github.io/
语音情感识别(SER)是人机交互的重要组成部分,受到工业界和学术界的广泛关注。然而,当前的SER研究领域长期存在以下问题:
数据集数量众多,但缺乏通用的合理划分,导致不同模型和方法的比较变得困难;
没有一个通用的基准能够覆盖众多语料库和语言,给研究人员的复现工作带来负担。
在本文中,我们提出了EmoBox,一个开箱即用的多语言多语料库语音情感识别工具包,以及一个适用于语料内和跨语料场景下的基准测试。对于语料内的基准测试,我们精心设计了不同数据集的数据划分。对于跨语料的基准测试,我们采用了一个SER基座模型,emotion2vec,以减少注释错误并获得一个在说话者和情感分布上完全平衡的测试集。基于EmoBox,我们展示了在32个情感数据集上10个预训练语音模型的语料内SER结果,这些数据集涵盖了14种语言,以及在4个数据集上具有完全平衡测试集的跨语料SER结果。据我们所知,这是语言范围和数量规模最大的SER基准测试。我们希望我们的工具包和基准测试能够促进社区中语音情感识别研究的发展。
我们的贡献是多方面的。我们不仅为SER社区提供了一个强大的工具包,以便在不同的数据集上轻松进行实验,而且还为该领域建立了一个新的基准。我们详细介绍了我们的数据划分方法,并相信这将减轻研究人员未来研究的负担。我们展示了在14种语言的32个情感数据集上应用10个预训练语音模型得出的综合语料内SER结果。据我们所知,这代表了迄今为止最广泛的SER基准,涵盖了最广泛的语言范围和最大的数据规模。此外,我们展示了在4个数据集上的跨语料SER表现,使用的测试集在说话人和情感方面完全平衡。通过EmoBox,我们旨在为SER社区提供一个强大的工具包和基准测试,以催化进一步的研究,增强模型的可比性,并最终推动语音情感识别领域的创新。
语料内语音情感识别
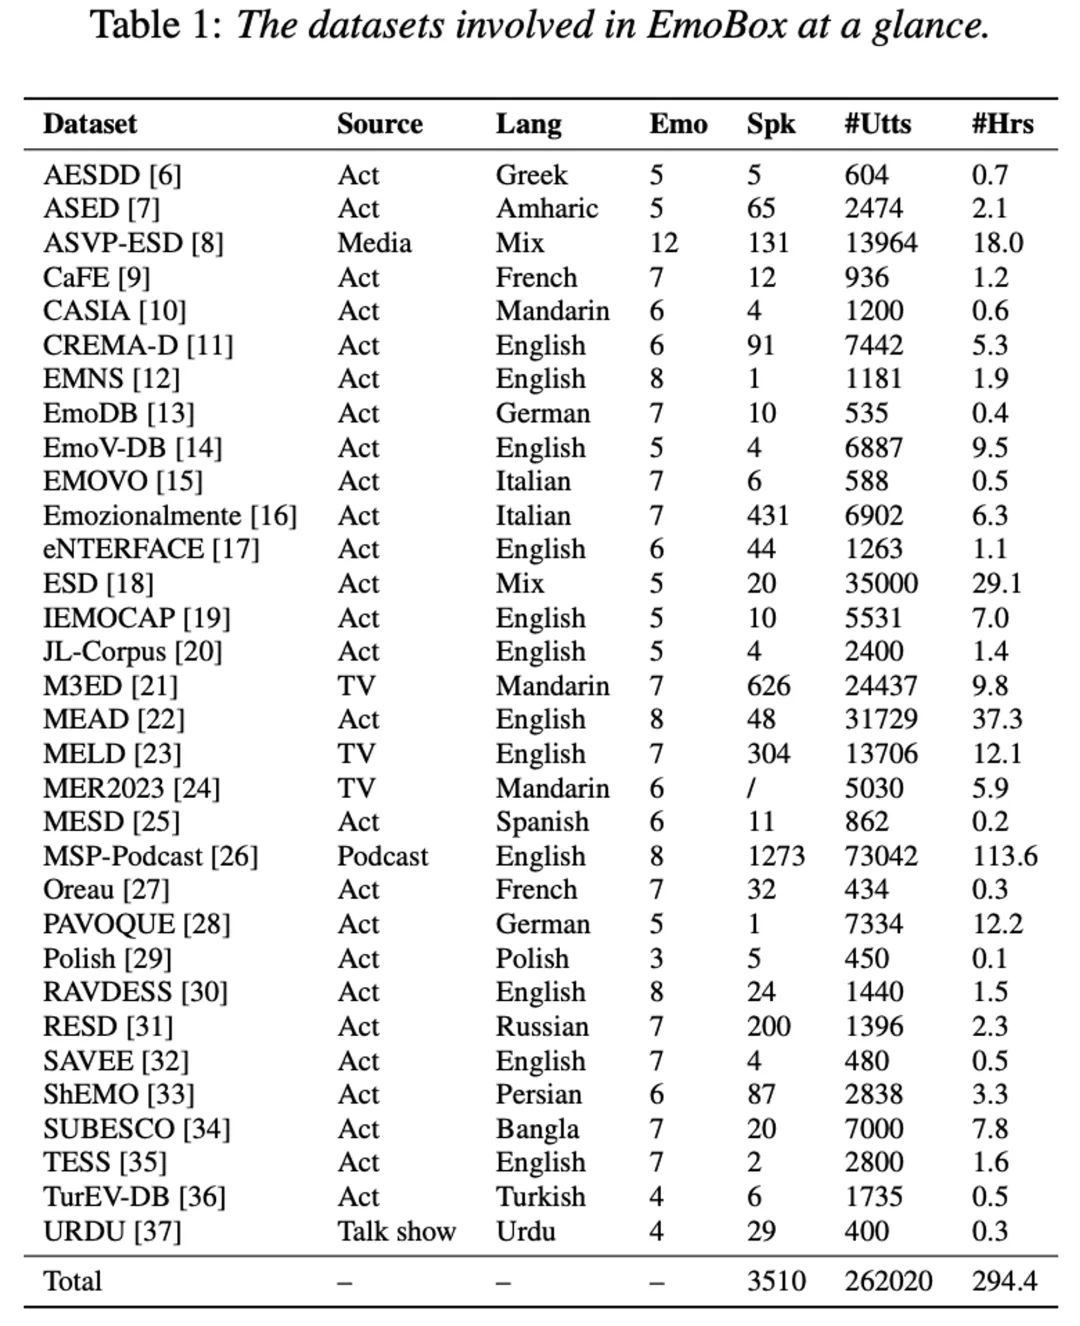
每个数据集被划分为训练集和测试集,划分可能包含单个或多个fold,具体取决于数据分布。 在数据集有官方预定义划分的情况下,坚持使用这些官方话费。例如,IEMOCAP数据集被组织成5个fold,每个折叠包含2个不同的说话人,而MELD数据集被划分为训练集、开发集和测试集。 对于说话人数量少于4的数据集,如PAVOQUE数据集只包含一个说话人;或者那些说话人数量在4个或以上但在说话人之间情感分布不均的数据集,如M3ED数据集,采用说话人依赖的方法。在这里,为测试保留每种情感的25%数据,其余分配给训练。 对于说话人数量大于或等于4且在说话人之间情感分布均衡的数据集,采用留一法n折交叉验证。更具体地说,如果说话人数量在4、5、6之间,n设定为与说话人数量相同;如果说话人数量超过6,n设定为4,并且在每个折叠中合并多个说话人。
跨语料语音情感识别
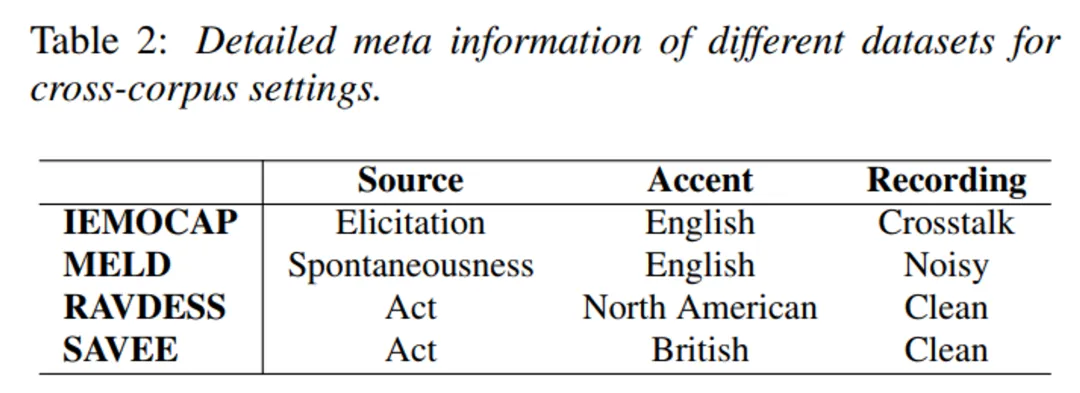
为解决潜在的注释错误,我们利用了emotion2vec模型的微调版本,这是一种语音情感识别基座模型,经过在超过10,000小时的语音数据上的迭代微调。我们的方法包括最初使用emotion2vec为我们的数据集分配伪标签。随后,我们通过保留原始注释与emotion2vec生成的注释一致的实例,对我们的数据集进行优化。这一步确保了注释差异的减少,并提高了进一步分析的可靠性。为了在每个数据集中建立一个完全平衡的测试集,我们为每个数据集选择了240个语音-情感对。这些数据集中共有的情感包括愤怒、快乐、中性和悲伤,每种情感各60个样本。测试集的构成,包括说话人数量和每种情感每位说话人分配的语音-情感对的详细信息,如图所示。对于IEMOCAP和SAVEE数据集,我们包括了所有说话人,IEMOCAP包含5名男性和5名女性说话人,SAVEE包含4名男性说话人。对于MELD数据集,我们关注6名主要角色。对于RAVDESS数据集,我们包括了20名说话人,男女各半。这种对测试集的精心构成有助于我们分析模型在不同语料库上的泛化能力,帮助我们评估模型在跨语料库设置下的鲁棒性和适应性。
实验设置
语料内语音情感识别结果
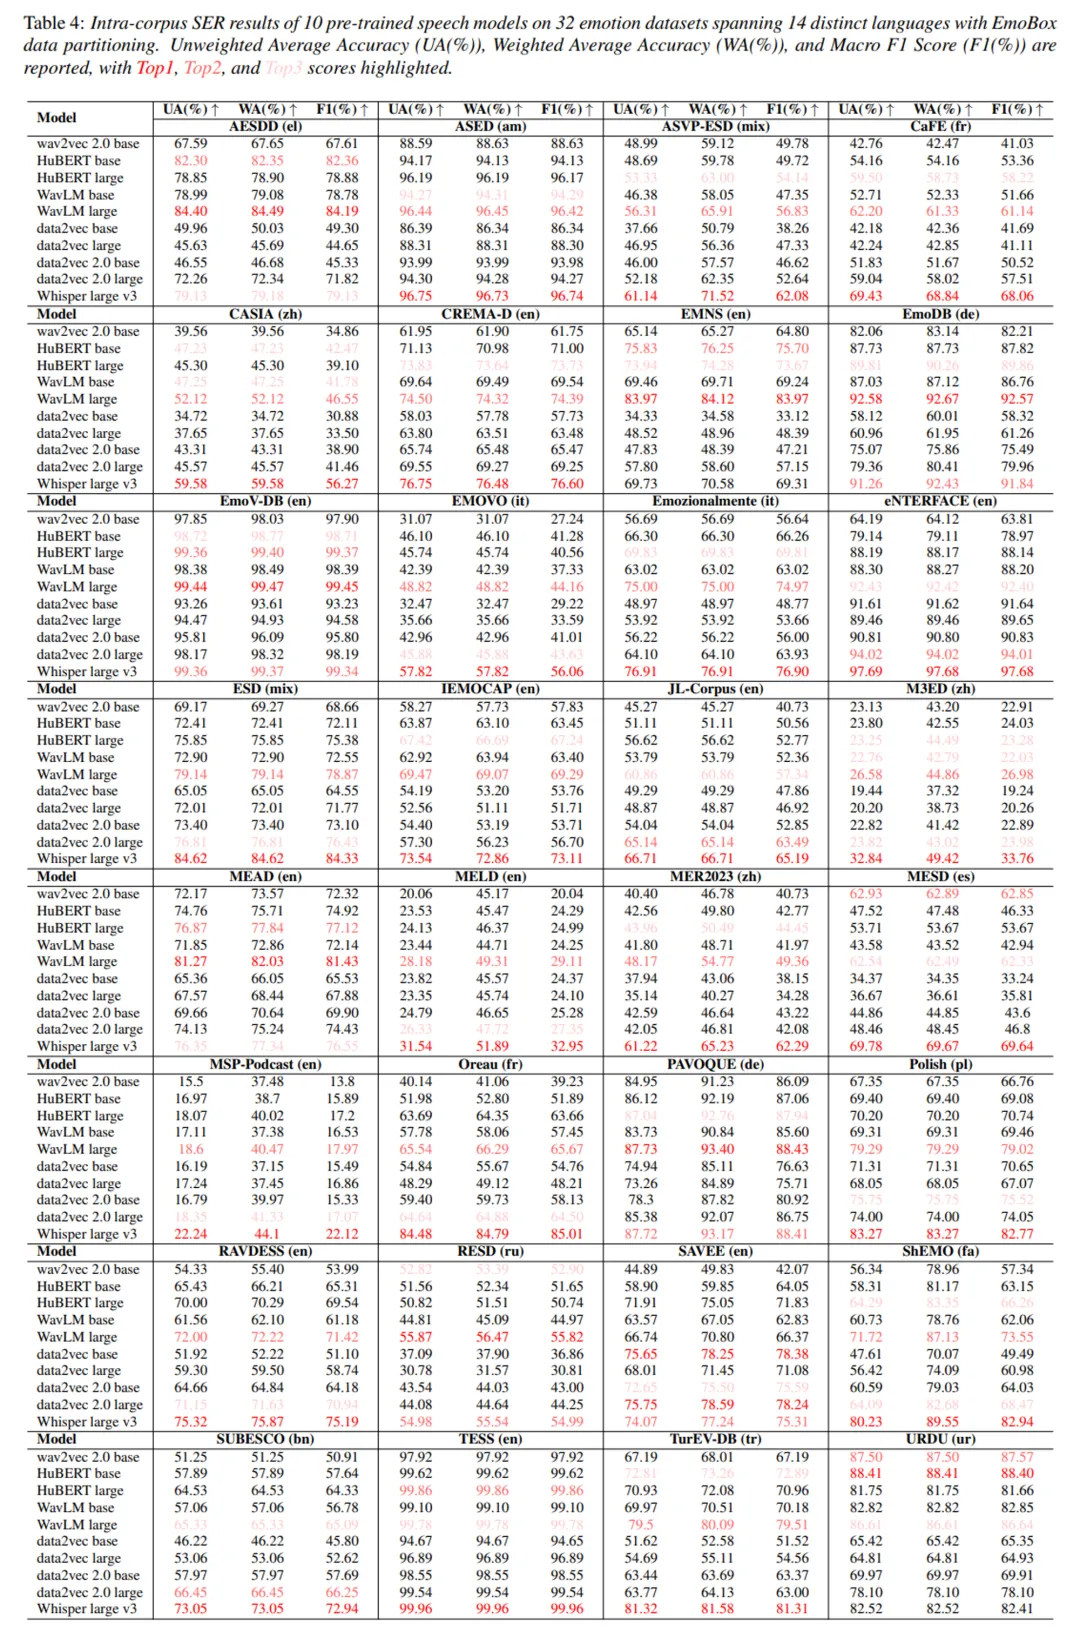
表中呈现了在EmoBox数据划分下,选定的10个预训练语音模型在32个情感数据集上的语料内语音情感识别结果,这些数据集涵盖了14种不同的语言。实验结果显示,Whisper large v3编码器的性能显著优于其他SSL模型,在32个数据集中有23个排名第一,30个排名前三。可能的原因是Whisper large v3是在多语言的数据和模型扩展中训练的。除了Whisper large v3编码器外,WavLM large表现最佳,在32个数据集中有31个排名前三,其次是HuBERT large的14个和data2vec 2.0 large的12个。这三种模型都是在英语语音数据上预训练的,而WavLM在SSL训练中使用了更多的数据并引入了噪声以增强鲁棒性。这表明用更多数据训练的SSL特征可以提高SER的性能。研究人员可以通过EmoBox基准进一步探索语音中的情感,例如语言相关性和差异。
跨语料库语音情感识别结果
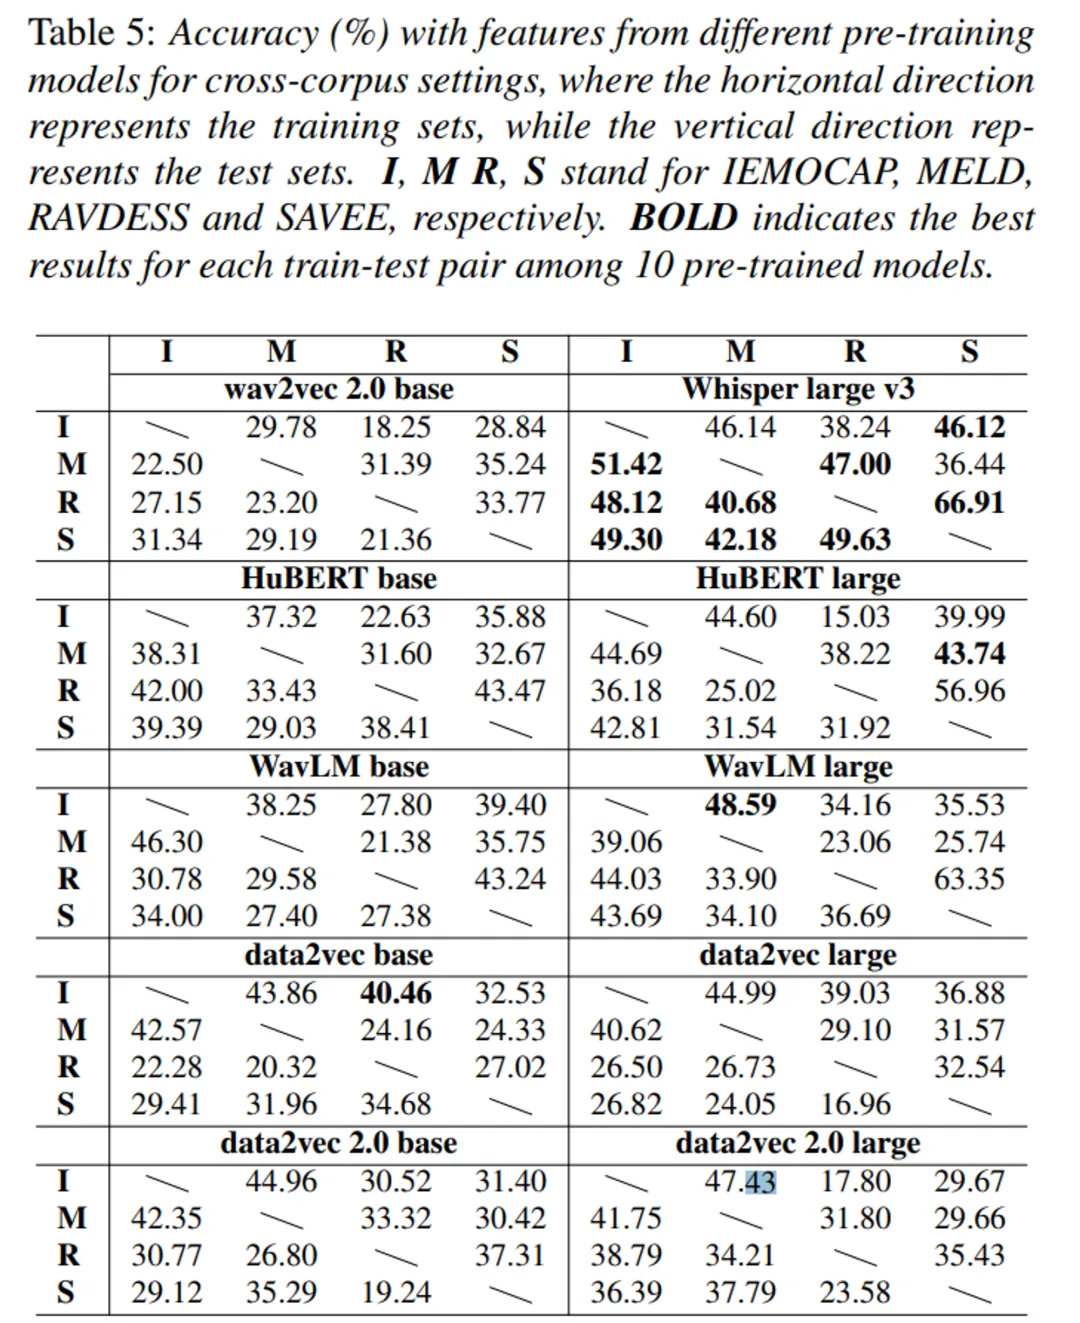
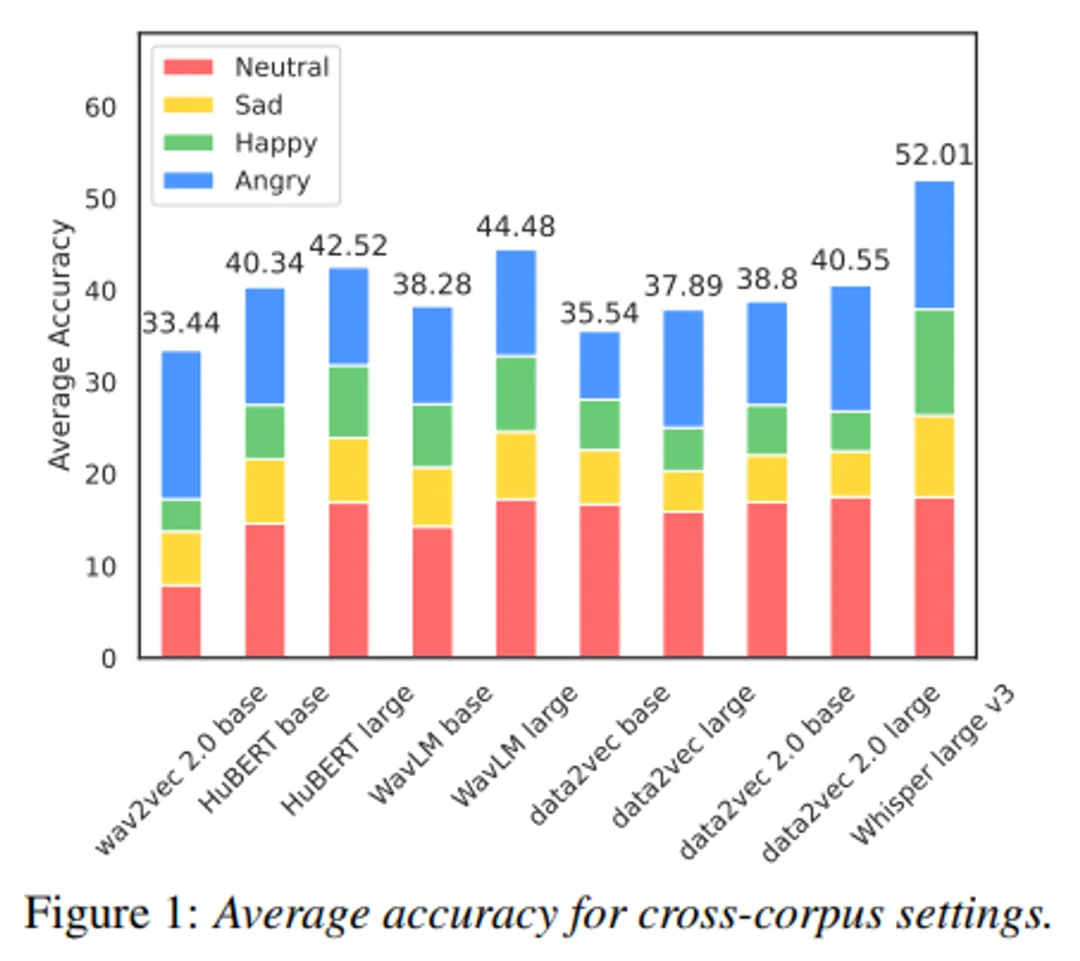
表中呈现了在微调的EmoBox测试集上,选定的10个预训练语音模型的跨语料库SER结果。从表中可以看出,Whisper large v3编码器在跨语料库设置中仍然表现最佳,在12个训练-测试对中有9个排名第一,而HuBERT large、WavLM large和data2vec base各占据1个。图中展示了不同模型在跨语料库设置中的平均准确率。计算平均准确率的公式如下: