
 西工大音频语音与语言处理研究组
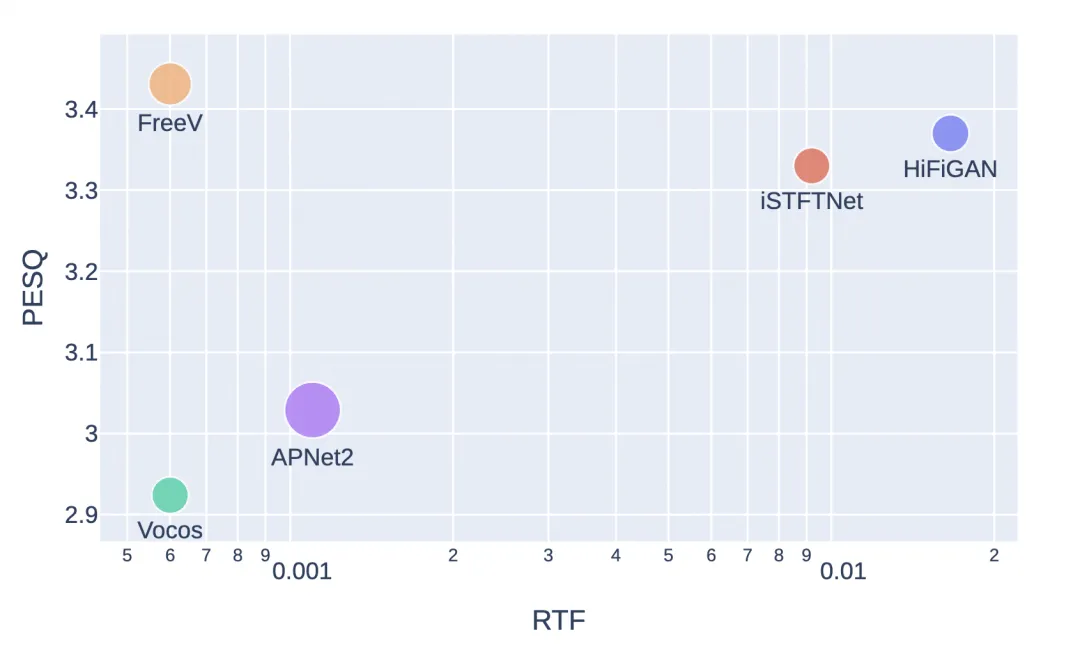
图1 横轴为推理速度,越小越好;纵轴为重建质量,越高越好;圆点大小为模型参数量
论文题目:FreeV: Free Lunch For Vocoders Through Pseudo Inversed Mel Filter
合作单位:爱奇艺
作者列表:吕元骏,李海,闫影,刘俊辉,谢丹明,谢磊
论文链接:https://arxiv.org/abs/2406.08196
演示链接:https://bakerbunker.github.io/FreeV/
Github代码链接:https://github.com/BakerBunker/FreeV
预训练的模型Checkpoint和Tensorboard log:https://huggingface.co/Bakerbunker/FreeV_Model_Logs
发表论文截图
梅尔谱,一个压缩后的频域表征
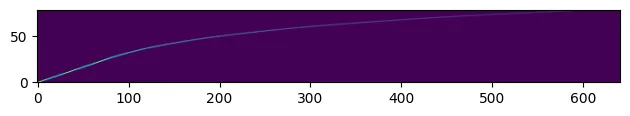
图2 可视化的梅尔滤波器矩阵
我们将梅尔滤波器与幅度谱相乘,这个操作将幅度谱转换到了梅尔刻度,压缩了表征大小,同时更加关注了低频的信息。这样,我们就得到了一个梅尔谱。
那么,梅尔谱都压缩了哪些信息呢?
梅尔谱丢弃了什么
将我的冗余信息,弃置于此
想要从梅尔谱还原得到原本的波形,我们就需要知道波形在变换到梅尔谱时,哪些步骤导致了信息的损失。首先,短时傅里叶变换导致的信息损失十分有限,而主要的信息损失来自于:
对复数谱取模长:这一步相当于丢弃了复数谱的相位信息
梅尔滤波器变换:这一步相当于使用梅尔滤波器的矩阵对幅度谱进行了压缩
那么,我们如何弥补梅尔谱的压缩损失呢?
“解压缩”梅尔谱
神经网络是一个万能的拟合器,它在理论上能够拟合所有的函数,当然,梅尔谱到波形的函数也不例外。以HiFiGAN[3]为代表的时域声码器就通过“暴力”的手段直接通过上采样来拟合梅尔谱到波形的映射f(mel)->wave,其中也不乏RefineGAN[4]和DSPGAN[5]一类的声码器通过加入pitch等约束改进这个过程,但这种方法一般推理耗时较高。
最近出现的频域声码器显式建模了第一步的信息损失,通过神经网络建模梅尔谱到幅度谱和相位谱f(mel)->spec, phase并通过逆短时傅里叶变换(ISTFT)得到波形,这一类实现比时域声码器漂亮了一些,进一步利用了傅里叶变换的先验知识,减轻了神经网络的建模压力,其中Vocos[1]直接同时预测了幅度谱和相位谱,APNet[6]&APNet2[2]发现了同时预测二者带来的音质损失并拆分为两个预测分支,且加入了约束相位谱的损失函数。
那么有没有一种办法,能够利用先验知识,显式建模梅尔滤波器变换带来的损失?
有,而且相当简单。
“逆转”梅尔滤波器
这个问题的答案在Griffin Lim的实现(https://librosa.org/doc/latest/generated/librosa.griffinlim.html)中就已经存在,由于幅度谱的压缩是一次矩阵乘法,幅度谱非负,并且梅尔滤波器已知,因此就可以使用最小二乘法(LS)和非负的最小二乘法(NNLS)来还原原本的幅度谱,更进一步地,可以提前缓存梅尔滤波器的伪逆矩阵,进一步缩小计算的时间。(这个方法在PriorGrad[7]和SpecGrad[8]中已经使用过,但它们为了保持输入的高斯分布,在波形中加入了噪声,这可能破坏了一些先验信息)
表1 不同方法的计算耗时和准确度,最小二乘法为LS,非负最小二乘法为NNLS,伪逆为PI
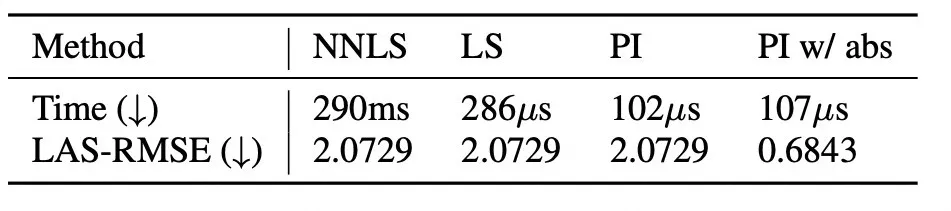
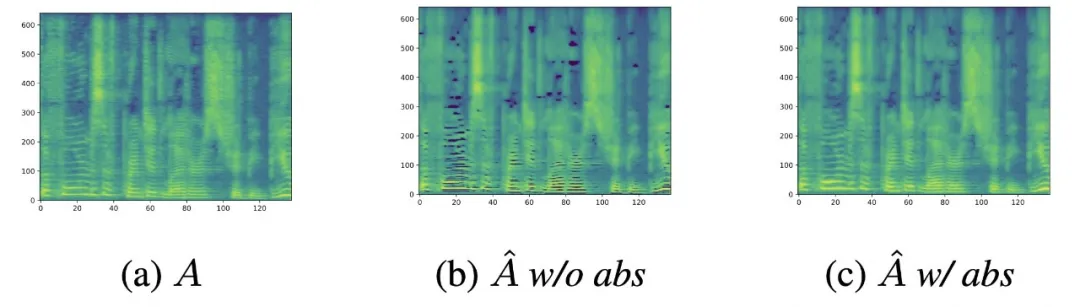
图3 去除伪逆滤波器中负数的影响,(a)真实幅度谱,(b)未去除负数还原的幅度谱,(c)去除负数后还原的梅尔谱
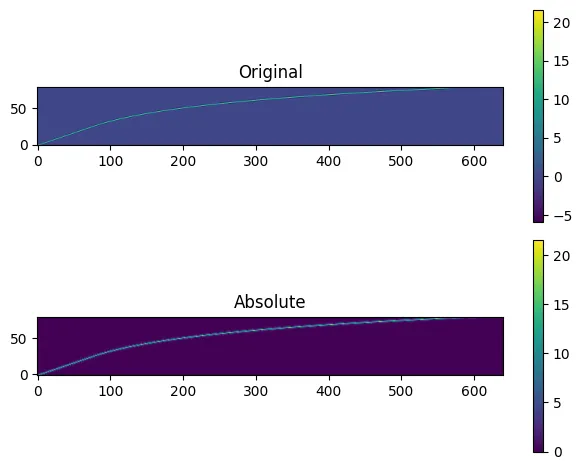
图4 上为未去除负数的伪逆滤波器,下为去除负数的伪逆滤波器
经过调查后,我们发现梅尔滤波器的伪逆矩阵中存在大量的负数,这是由于伪逆计算时的误差所导致的,通过绝对值函数去掉了负数后,我们发现谱上的大量的黑条明显减轻。总结下来,上面的步骤可以用一行代码来表示:
model_input = (mel_spec @ mel_filter.pinverse()).abs().clamp_min(1e-5) 为幅度谱预测“减负”
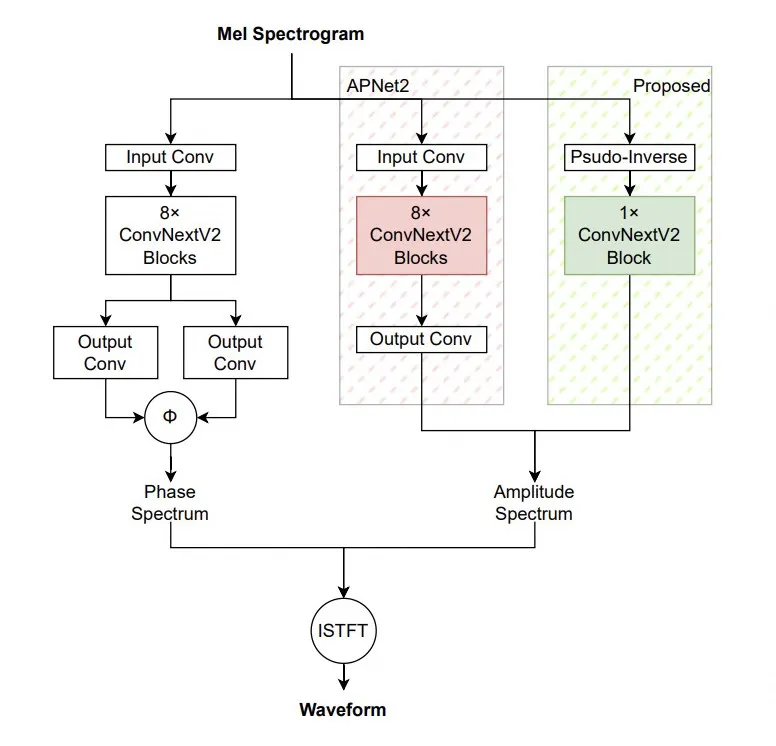
图5 幅度谱预测“减负”,幅度谱预测分支的ConvNeXt Block数量从8减小到1
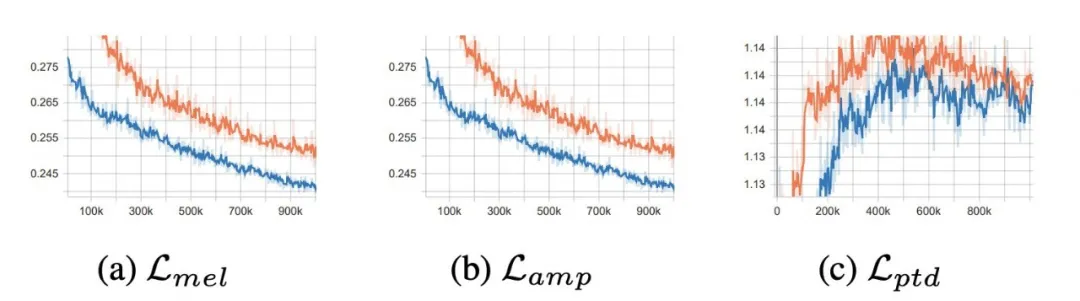
图6 收敛加速效果,蓝色为FreeV,橙色为APNet2[2],从左到右为梅尔损失、幅度谱损失和相位损失
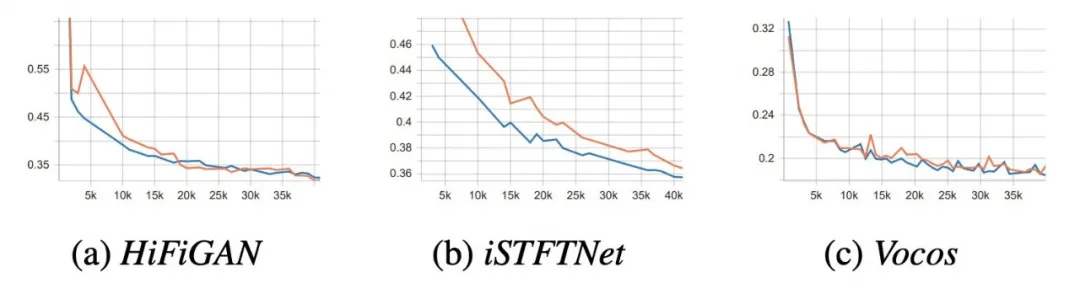
图7 在非APNet2上的收敛加速效果(图中为早期步数),蓝色为使用预测幅度谱作为输入,橙色为原模型
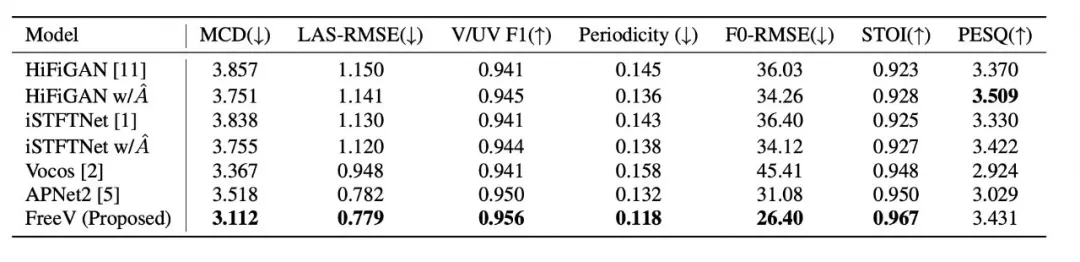
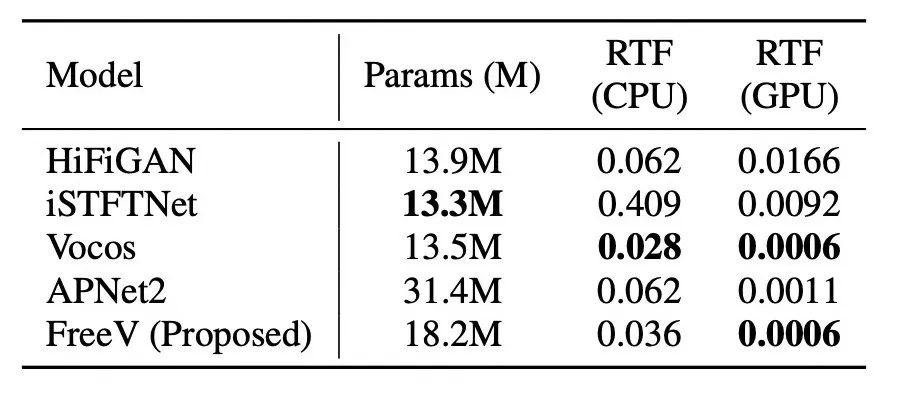
性能展示
失败的尝试
在实验的进程中,也尝试使用PGHI(Phase Gradient Heap Integration)方法(https://ieeexplore.ieee.org/stamp/stamp.jsp?arnumber=7890450)为相位谱提供一个好的初值,但在实际表现上弱于输入预测的相位谱。
该实验的记录在上面提供的链接(https://huggingface.co/Bakerbunker/FreeV_Model_Logs)中可以找到,同时在这个issue(https://github.com/BakerBunker/FreeV/issues/1)中可能有一些问题的解答。
[1] Siuzdak, H. (2023). Vocos: Closing the gap between time-domain and Fourier-based neural vocoders for high-quality audio synthesis. The Twelfth International Conference on Learning Representations, abs/2306.00814.
[2] Du, H.-P., Lu, Y.-X., Ai, Y., & Ling, Z.-H. (2023). APNet2: High-Quality and High-Efficiency Neural Vocoder with Direct Prediction of Amplitude and Phase Spectra. In Communications in Computer and Information Science, Man-Machine Speech Communication (pp. 66–80). Springer Nature Singapore.
https://doi.org/10.1007/978-981-97-0601-3_6
[3] Kong, J., Kim, J., & Bae, J. (2020). HiFi-GAN: Generative Adversarial Networks for Efficient and High Fidelity Speech Synthesis. Conference on Neural Information Processing Systems (NeurIPS).
[4] Xu, S., Zhao, W., & Guo, J. (2022). RefineGAN: Universally Generating Waveform Better than Ground Truth with Highly Accurate Pitch and Intensity Responses. Conference of the International Speech Communication Association (INTERSPEECH), 1591–1595.
https://doi.org/10.21437/Interspeech.2022-349
[5] Song, K., Zhang, Y., Lei, Y., Cong, J., Li, H., Xie, L., He, G., & Bai, J. (2023). DSPGAN: A Gan-Based Universal Vocoder for High-Fidelity TTS by Time-Frequency Domain Supervision from DSP. ICASSP 2023 - 2023 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP).
https://doi.org/10.1109/icassp49357.2023.10095105
[6] Ai, Y., & Ling, Z.-H. (2023). APNet: An All-Frame-Level Neural Vocoder Incorporating Direct Prediction of Amplitude and Phase Spectra. In IEEE/ACM Transactions on Audio, Speech, and Language Processing (Vol. 31, pp. 2145–2157). IEEE.
https://doi.org/10.1109/TASLP.2023.3277276
[7] Lee, S., Kim, H., Shin, C., Tan, X., Liu, C., Meng, Q., Qin, T., Chen, W., Yoon, S., & Liu, T.-Y. (2022). PriorGrad: Improving Conditional Denoising Diffusion Models with Data-Dependent Adaptive Prior. International Conference on Learning Representations (ICLR).
[8] Koizumi, Y., Zen, H., Yatabe, K., Chen, N., & Bacchiani, M. (2022). SpecGrad: Diffusion Probabilistic Model based Neural Vocoder with Adaptive Noise Spectral Shaping. Interspeech 2022, 803–807.
https://doi.org/10.21437/INTERSPEECH.2022-301
[9] Kaneko, T., Tanaka, K., Kameoka, H., & Seki, S. (2022). ISTFTNET: Fast and Lightweight Mel-Spectrogram Vocoder Incorporating Inverse Short-Time Fourier Transform. ICASSP 2022 - 2022 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 6207–6211.
https://doi.org/10.1109/ICASSP43922.2022.9746713
