
 西工大音频语音与语言处理研究组
随着手机、笔记本电脑等智能设备的普及,音频通信系统在人们的日常生活中起到了越来越重要的作用。然而,受硬件等多种因素的限制,通信系统中的语音信号经常因频率响应失真、不连续失真、响度问题、混响和噪声等受到损伤,影响听感。在ICASSP 2024语音信号改善挑战赛(SSIC)上,我们提出了基于修复和降噪的两阶段模型RaD-Net,旨在提升受损伤语音信号的质量,然而由于没有有效利用未来信息以及卷积感受野的约束,模型的性能受到了限制。
近期,由西工大音频语音与语言处理研究组(ASLP@NPU)与字节跳动合作论文“RaD-Net 2: A casual two-stage repairing and denoising speech enhancement network with knowledge distillation and complex axial self-attention”被语音研究顶级会议INTERSPEECH 2024接收,该论文在RaD-Net的基础上,提出了基于因果性蒸馏和复数轴向自注意力机制的两阶段音质修复模型RaD-Net 2,有效提升了模型处理不同类型音质损伤的能力。现对该论文进行简要的解读。
论文题目:RaD-Net 2: A casual two-stage repairing and denoising speech enhancement network with knowledge distillation and complex axial self-attention
合作单位:字节跳动
作者列表:刘铭帅,陈庄祺,闫晓鹏,吕元骏,夏咸军,黄传增,林丹峰,谢磊
音频通信系统的广泛应用使得语音信号质量受到越来越多的关注。在通信系统中,语音信号在采集、模数转换、传输到播放的整个链路里可能会受到频率响应失真、不连续失真、响度问题、噪声和混响等多种不利因素的影响,从而严重损伤语音质量和可懂度。近年来,研究者们在降噪和去混响领域提出了多种性能优越的深度神经网络,展示了深度学习在语音信号质量改善方面的巨大潜力。
在ICASSP 2024语音信号改善挑战赛(SSIC)上,我们提出了一种基于生成式对抗网络的两阶段模型RaD-Net [1],实现了对多种失真的有效处理。然而,由于忽略了未来信息对修复任务的重要性以及卷积感受野的约束,模型性能受到了限制。为了解决这些问题,我们进一步扩展了RaD-Net,提出了基于因果性蒸馏和复数轴向自注意力机制的更新方案——RaD-Net 2。首先,在第一阶段引入基于因果性的知识蒸馏,使用非因果模型作为教师模型来提升非因果模型的性能。此外,在第二阶段将复数轴向自注意机制应用于复数特征编码器和复数特征解码器。实验结果表明,与RaD-Net相比,RaD-Net 2在ICASSP 2024 SSI挑战盲测试集上带来了0.10 OVRL DNSMOS和0.15 OVRL SIGMOS的改进。
RaD-Net:ICASSP2024 | RaD-Net: 基于语音恢复和降噪的两阶段音质修复模型
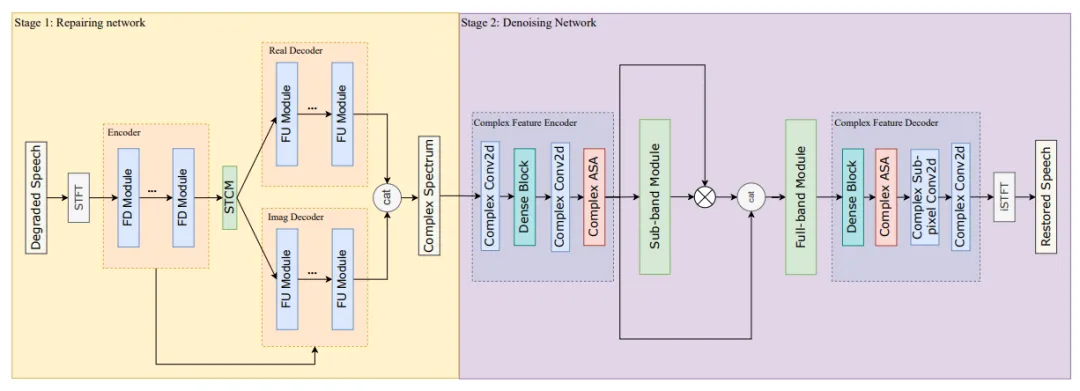
图1 RaD-Net 2模型结构
基于因果性的蒸馏
一阶段模型以TEA-PSE [2]中的COM-Net为主干网络,采用mapping的方式同时处理多种失真。在该阶段,模型的任务可以划分为两类:
生成受损音频的缺失成分,如频带扩展、丢包补偿等。
初步去除干扰信号,如消除背景噪声和电路噪声、去混响等。
对于第一类生成式任务来说,上下文表征对模型的性能起到了重要作用,由于因果模型无法获取未来信息,非因果模型在此类任务上的性能要优于因果模型。为此,我们在第一阶段引入基于因果性的蒸馏方案,通过因果的方式使用未来信息,进一步提升因果模型的性能。在蒸馏过程中,教师模型和学生模型分别使用非因果网络和因果网络。其中,非因果网络和因果网络采用相同的参数配置,不同之处在于,非因果网络TFCM模块中的卷积采用了非因果填充,而因果网络TFCM模块中的卷积采用了因果填充。

复数轴向自注意力机制
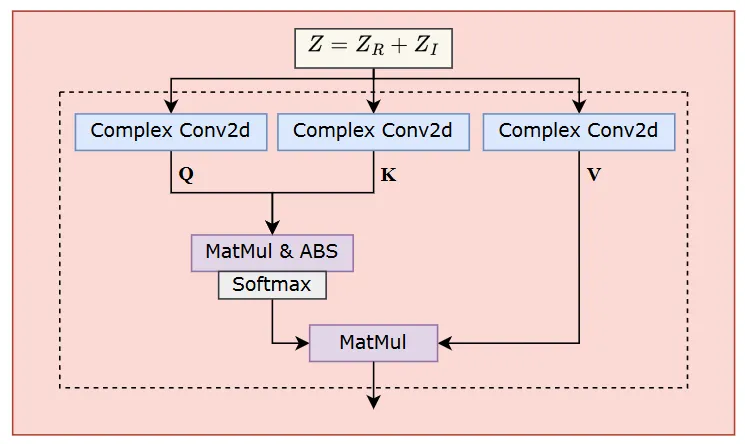
图2复数ASA模块结构
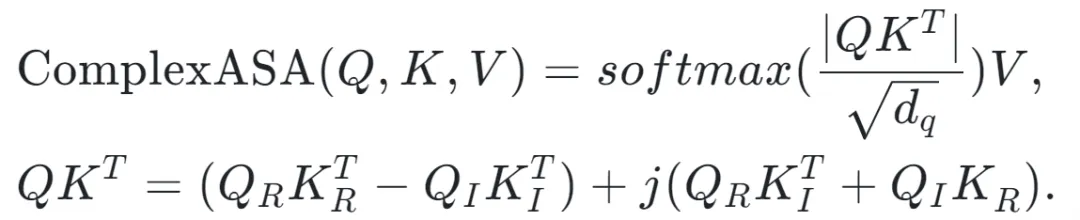
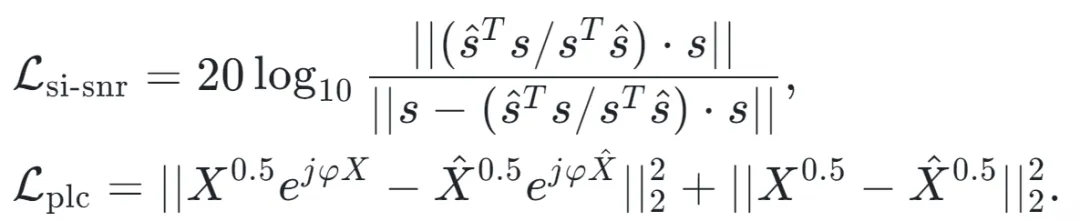
实验设置
实验数据: 干净人声、噪声均来自DNS 5竞赛数据。 数据仿真方面,在官方开源的仿真代码基础上,加入AAC、MP3和AMR三种编解码方式。 最终仿真1200训练集、30小时校验集。 对比系统: RaD-Net:前作方案 Gesper[6]:音质修复领域的SOTA模型之一 评价指标: DNSMOS SIGMOS[7]:SIGMOS是ICASSP 2024 语音信号改善挑战赛中发布的非侵入式指标。该指标基于ITU - T P.804标准,用来评估全带音频的质量。SIGMOS从七个维度评估语音质量:speech signal (SIG)、coloration (COL)、discontinuity (DISC)、loudness (LOUD)、noisiness (NOISE)、reverb (REVERB)和overall quality (OVRL)。
实验结果分析
与大尺寸的一阶段模型相比(Stage-1 Large)相比,非因果的一阶段模型(Stage-1 Non-causal)在DNSMOS和SIGMOS的各项指标上得分更高,证明了未来信息对音质修复模型的重要性。 使用非因果网络作为教师的一阶段模型(Stage-1+
复数ASA模块有效提升了RaD-Net在DNSMOS和SIGMOS上的表现,证明了其有效性。
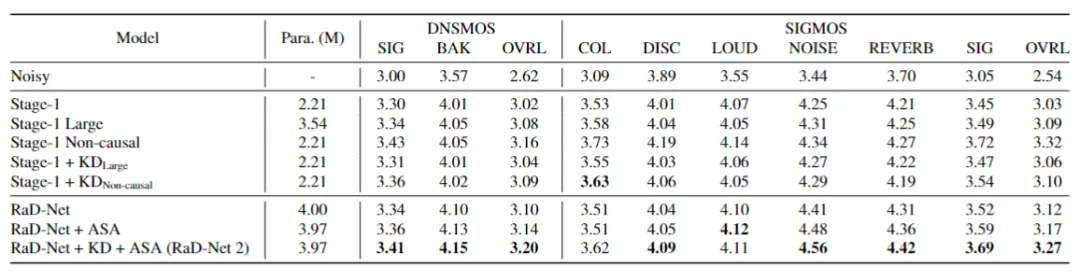
表1 在ICASSP 2024语音信号改善挑战赛盲测集的DNSMOS和SIGMOS
如表2所示,我们提出的系统在DNSMOS上的表现优于Gesper。
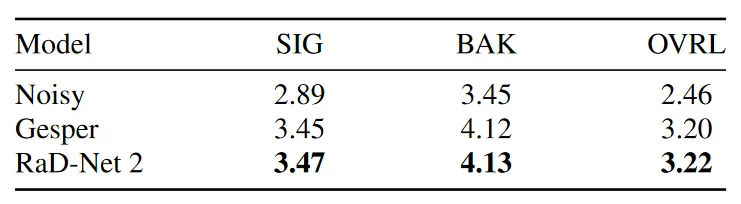
表2 在ICASSP 2023语音信号改善挑战赛盲测集的DNSMOS
