
 语音小管家
Towards Lightweight Speaker Verification via Adaptive Neural Network Quantization
作者列表:刘贝,王浩宇,钱彦旻
论文:https://ieeexplore.ieee.org/document/10623284
背景动机
方案
自适应单一精度量化
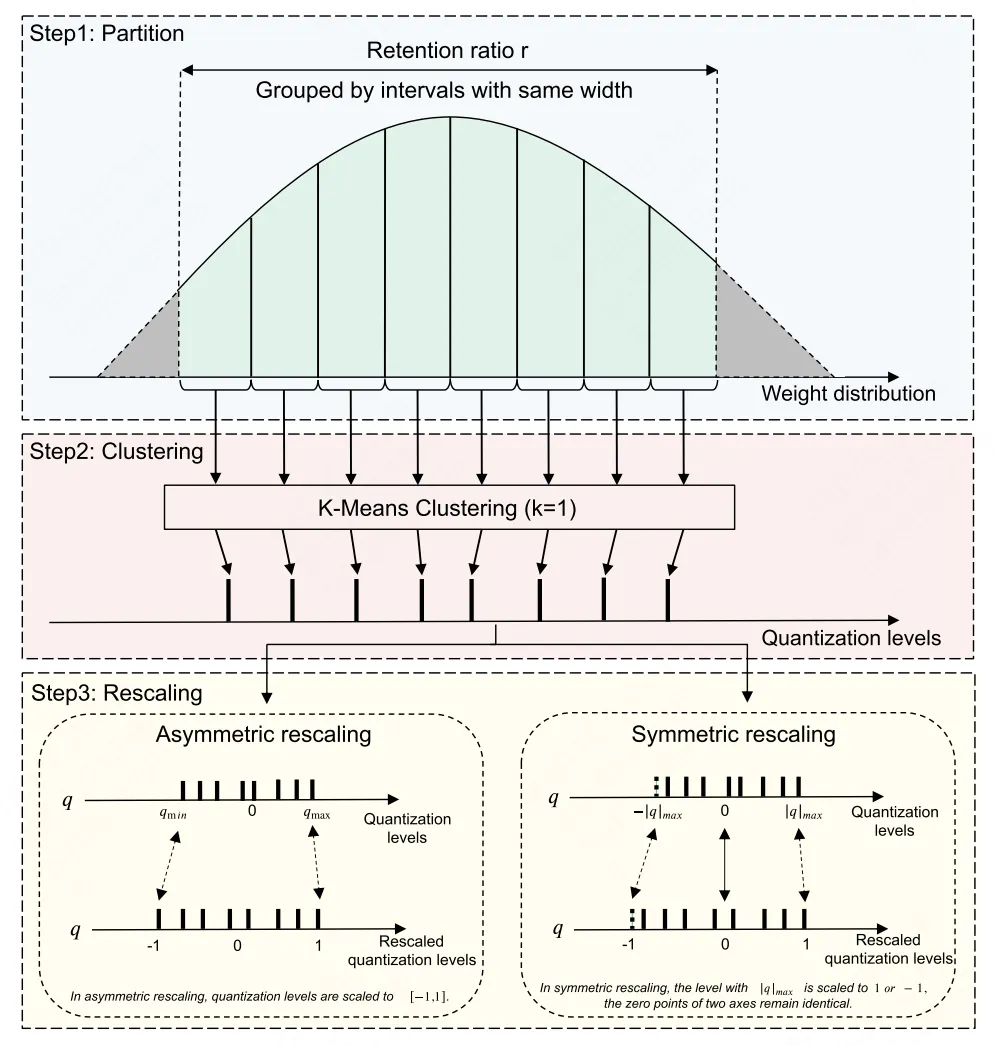
图2 自适应单一精度量化流程
该算法具体分为三个步骤:
1. 划分区间:将预训练的权重分布按照等间距进行区分。
2. 聚类:利用 K-Means 聚类算法,对于每一个部分单独生成质心。
3. 按比例映射:将得到的质心重新映射到 [-1, 1]之间。
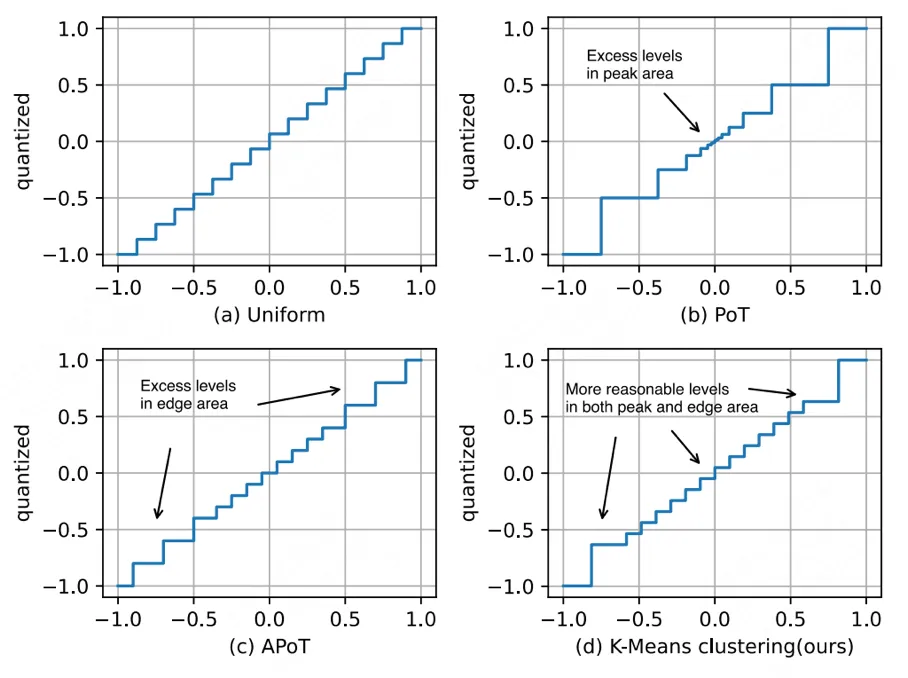
图3 不同量化算法中心点对比
混合精度量化
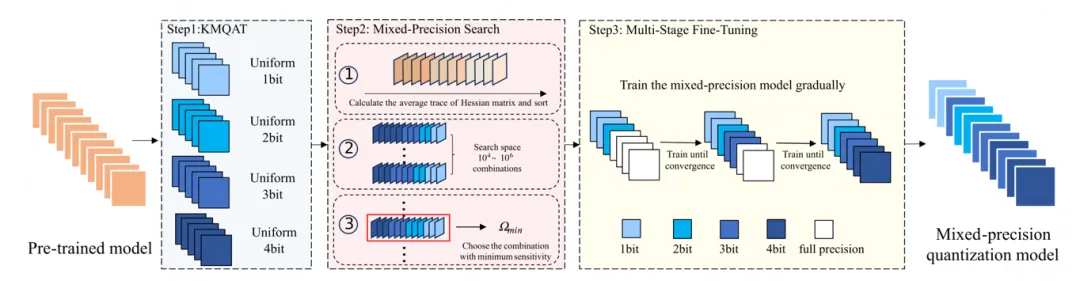
图4 混合精度量化流程
我们进一步提出混合精度量化,具体流程如下:
1. 确定候选量化精度:根据指定的压缩比,确定相应的可选择比特数。
2. 混合精度搜索:根据每个网络层敏感度的不同,搜索最优的精度组合。
3. 微调:根据每层量化精度的不同进行多次微调。
二值量化
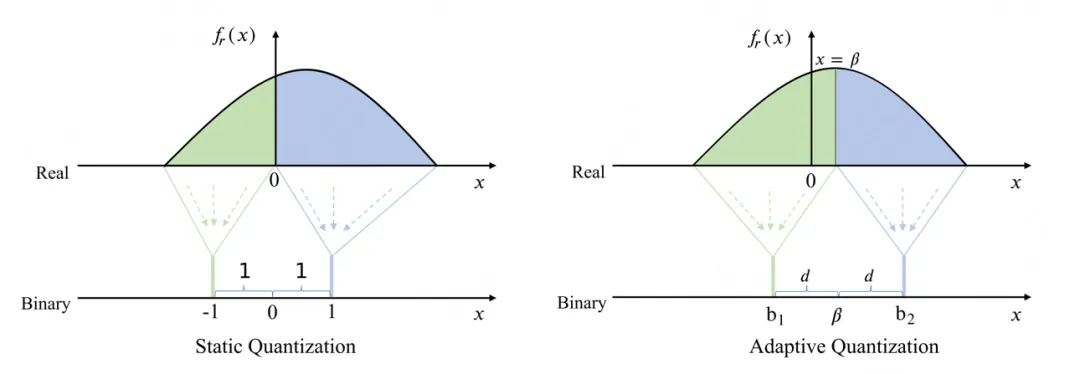
图5 二值量化算法
静态量化:
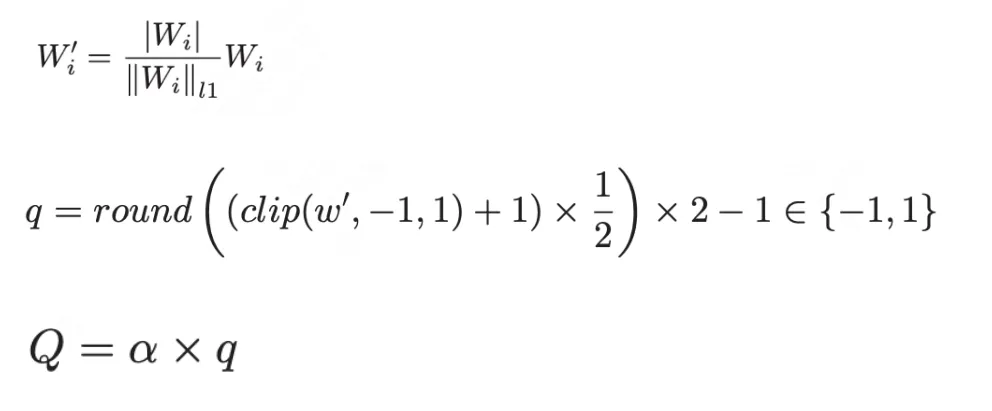
动态量化:
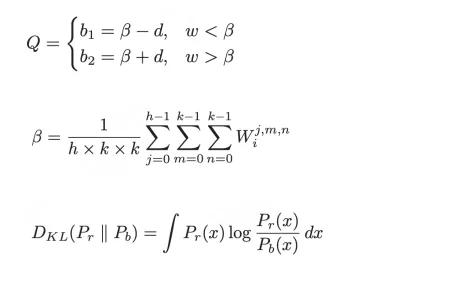
实验配置
本文采用Voxceleb1&2[6-7]作为实验数据,其中Voxceleb2 dev作为训练集(包含5,994个说话人和1,092,009语句)、Voxceleb1作为测试集。此外,使用了三种不同的数据增广技术用来提高训练集的多样性,包括:Speed Perturb、Online Data Aug和SpecAugment。
使用余弦距离作为说话人向量之间的相似度指标,同时采用动态分数归化 (AS-Norm)用于后端处理。等错误率(EER)和最小检测成本函数(MinDCF)当作模型性能度量。
实验结果
实验结果如表1和表2所示。从结果中可以看出,在ResNets和DF-ResNets上,我们提出的KMQAT在4比特量化的情况下,达到了接近8倍的压缩比,同时模型性能几乎没有损失。此外,与传统的单一精度量化算法相比,我们的方法在低比特量化场景中表现更为优异。这充分证明了我们方法的有效性和鲁棒性,说明通过聚类得到的中心点能够更好地匹配实际权重的分布。
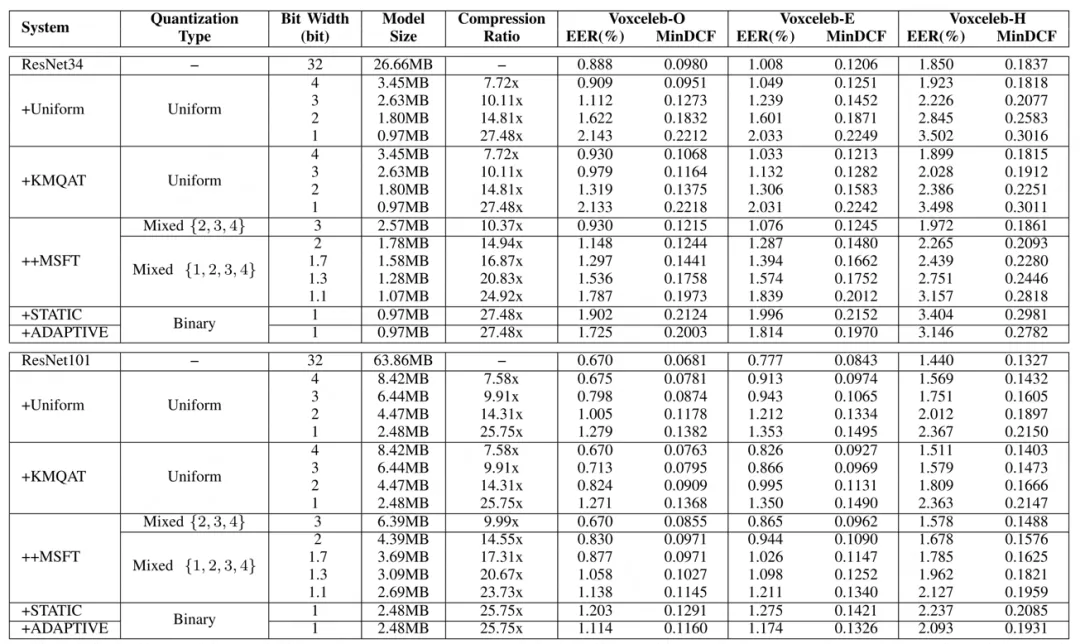
表1 全精度和量化后的ResNets 性能
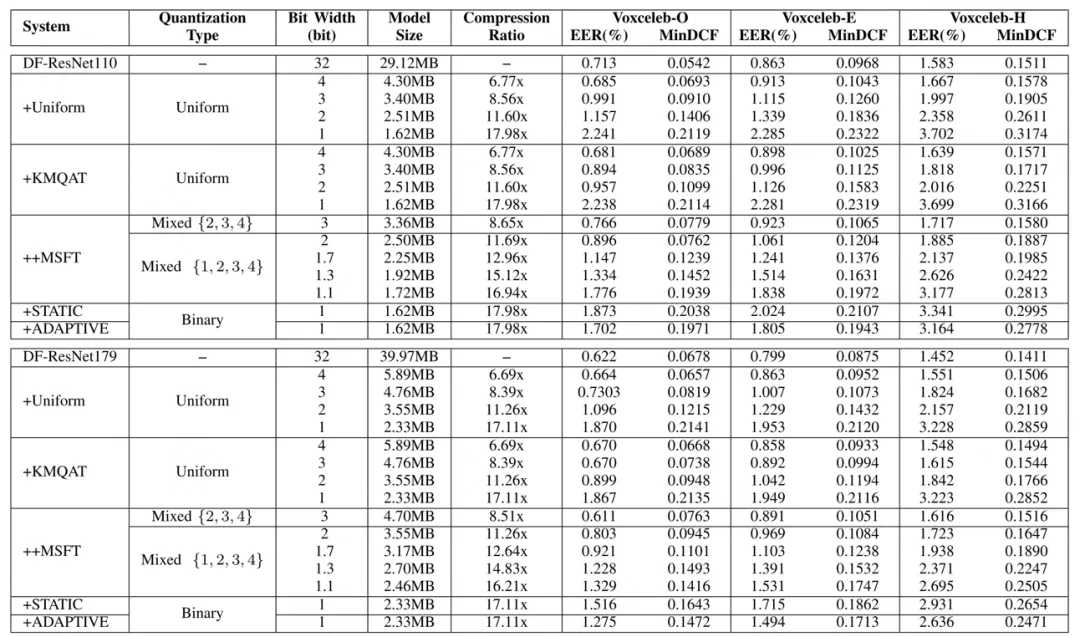
表2 全精度和量化后的DF-ResNets 性能
实验结果如表1和表2所示。我们发现,在ResNets和DF-ResNets上,与单一精度相比,混合精度在相似压缩比条件下能够实现更优的性能表现。在实验中,我们采用了不同的候选比特数,生成了多种等效量化模型,并分析了四种不同情况:2比特、1.7比特、1.3比特和1.1比特。这些模型在不同情况下均实现了性能提升。这表明,不同网络层对性能的敏感度各不相同,通过合理分配不同的精度,可以更好地保持量化后模型的性能。
从表1和表2可以看出,原始的量化方法在1比特场景下与全精度模型相比,性能下降显著。我们设计的两种二值量化算法显著提升了性能,进一步验证了我们方法的优越性。
模型性能和规模分析
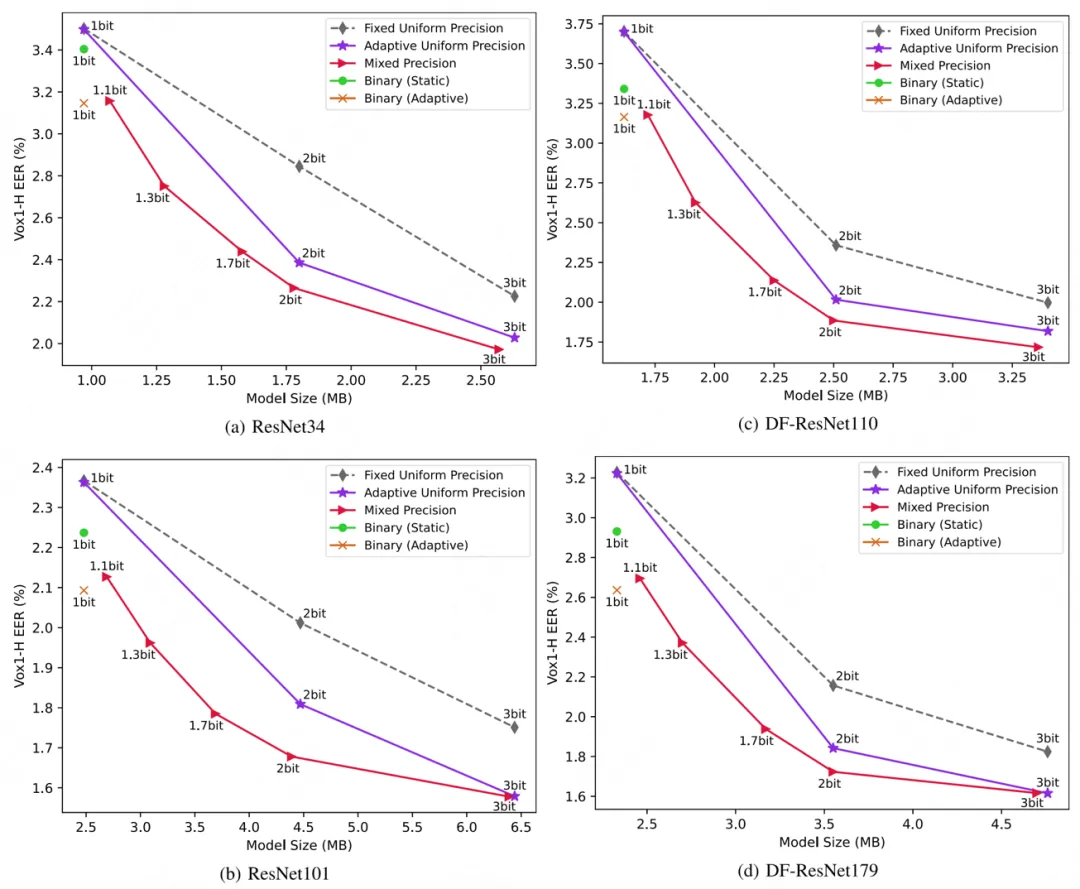
图6 各模型性能和规模比较
从图6可以看出,无论在何种模型和规模下,我们的量化算法相比传统的单一精度方法,实现了更优的平衡。
权重分布分析
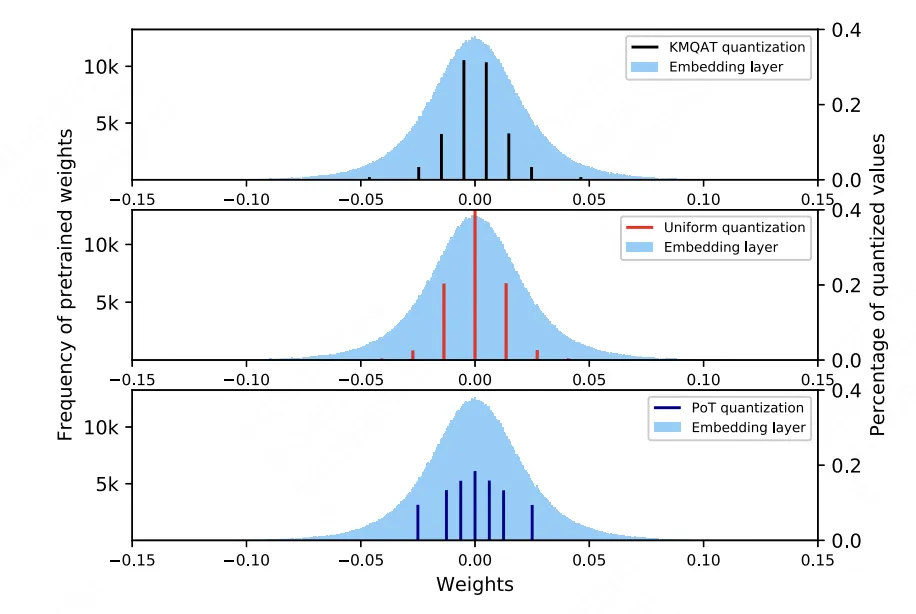
图7 ResNet34权重分布图
从图7可以看出,预训练权重的分布呈现钟形,其中大部分的权重集中在0附近。传统的量化算法无法准确的匹配真实权重的分布,导致产生比较大的量化误差。相比之下,我们提出的KMQAT策略可以更好的符合真实分布。
与其他系统的对比
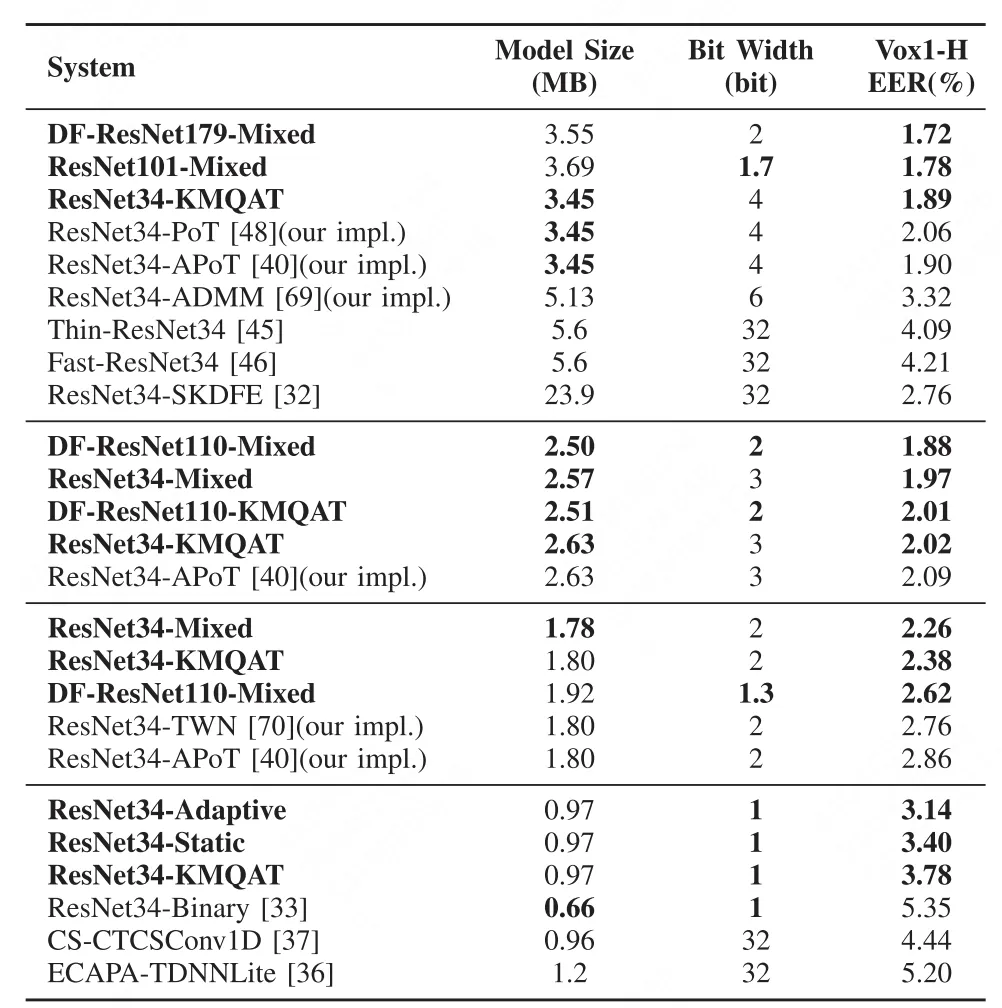
表3 和各种不同轻量化系统的结果比较
我们跟现有的轻量化模型结果做了一个全面的比较和分析。如表3所示,我们所提出的模型在各种尺寸范围内都优于之前发布的说话人确认系统,实现了最好的性能。
总结
参考文献
[1] N. Dehak, P. J. Kenny, R. Dehak, P. Dumouchel, and P. Ouellet, “Front-end factor analysis for speaker verification,” IEEE Trans. Audio, Speech, Lang. Process., vol. 19, no. 4, pp. 788–798, May 2011.
[2] B. Desplanques, J. Thienpondt, and K. Demuynck, “ECAPA-TDNN: Emphasized channel attention, propagation and aggregation in TDNN based speaker verification,” in Proc. Interspeech, 2020, pp. 3830–3834.
[3] H. Zeinali, S. Wang, A. Silnova, P. Matˇejka, and O. Plchot, “But system description to VoxCeleb speaker recognition challenge 2019,” 2019, arXiv:1910.12592.
[4] B. Han, Z. Chen, and Y. Qian, “Local information modeling with selfattention for speaker verification,” inProc. IEEE Int. Conf. Acoust., Speech, Signal Process., 2022, pp. 6727–6731.
[5] B. Liu, Z. Chen, and Y. Qian, “Depth-first neural architecture with attentive feature fusion for efficient speaker verification,” IEEE Trans. Audio, Speech, Lang. Process., vol. 31, pp. 1825–1838, 2023.
[6] A. Nagrani, J. S. Chung, and A. Zisserman, “Voxceleb: A large-scale speaker identification dataset,” in Proc. Interspeech, 2017, pp. 2616–2620.
[7] J. S. Chung, A. Nagrani, and A. Zisserman, “VoxCeleb2: Deep speaker recognition,” in Proc. Interspeech, 2018, pp. 1086–1090.
