近日,来自小红书的技术团队FireRed,提出了基于大语言模型的FireRedTTS语音合成系统,并分享了在短视频配音及聊天式语音对话等应用的一些实践。
FireRedTTS只需要给定文本和几秒钟参考音频,无需训练,就可模仿任意音色、任意说话风格,创造独特的音频内容。搞怪风、女友风、emo小片段……百变风格自由定制,只有你想不到,没有FireRedTTS做不到。
是的,你没听错。这一段带着京腔,中英文混杂的片段正是由 FireRedTTS生成。中英夹杂的strong(死装)感在“city”中透着一丝阴阳怪气。不只语言混杂,FireRedTTS还有让人直呼“更city”的配音与对话。
大家听出来了哪几个影视剧角色?运用 FireRedTTS,能够让《黑神话》悟空、《亮剑》李云龙、《狂飙》中的徐江、《西虹市首富》中的王多鱼这些本不可能聚集在一起的人物插科打诨,互相斗嘴,整活不断。
FireRedTTS不仅能够驾驭多风格、高表现力的音色,在自然对话领域也表现亮眼。视频中基于FireRedTTS的陪伴式交流真实自然,刁蛮可爱的女友形象让人情不自禁。
同时,除运用FireRedTTS的能力进行多音色、中英混杂的“整花活”之外,FireRedTTS还能够生成具有小红书博主风格的高级感旁白,少年博主音颇具特色,将听众拉入即将离去的夏天。FireRedTTS的效果卓群,能hold住不同类型、不同风格、不同使用场景的需求。那么FireRedTTS是如何一步步突破局限,做到如此惊艳的效果?让我们跟寻FireRedTTS团队的研发人员一探究竟。FireRedTTS 提出了一套完整的基座语音合成框架,由三部分组成:数据处理、基座系统、与下游应用。在基座系统部分,他们提出了一种基于语言模型的语音合成方案,旨在利用语言模型强大的序列生成能力,将文本序列转换成自然的、有表现力的语音序列。该方案首先训练一个关注语义信息的语音离散编码器,以把语音信号转换成离散的标签序列,和一个说话人全局表征。随后,文本到语音的语言模型被训练以从文本和说话人表征中预测目标语音序列。为将预测的离散语音序列稳定地还原至高保真音频,FireRedTTS提出了一种两阶段方法:先用大规模低采样率数据训练高泛化性梅尔谱生成器,再用小规模高保真数据训练超分辨神经声码器以合成高采样率音频。同时,除了基于流匹配的解码器,该系统还提出了一种基于多流语言模型的流式解码器以满足流式解码需求。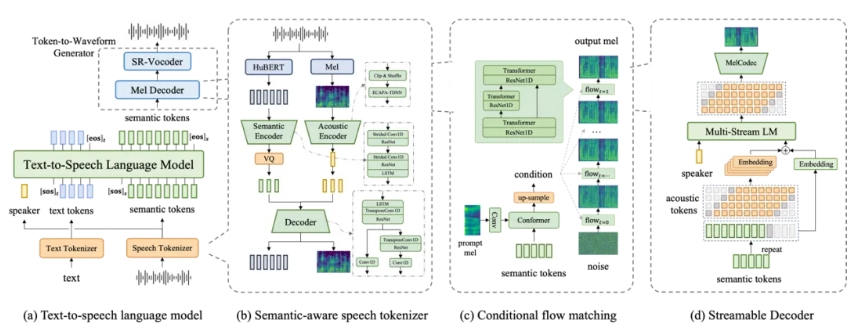
待基座模型训练完毕后,FireRedTTS便可以通过 In-Context Learning, Supervised Fine-Tuning, Instruct Tuning 等方法,服务下游语音应用。比如:在配音领域,该系统可以零样本克隆用户声音、1 小时数据构造专业级特色声音;在自然对话领域,该系统通过指令优化实现情感和副语言行为可控的拟人化语音生成。目前,FireRed 团队已经公布了该工作的技术报告,并且将开源模型权重和推理代码,以供大家体验尝试。在视频的的结尾部分,FireRed团队也放置了一段由FireRedMusic生成的音乐彩蛋,期待FireRedMusic早日与大家见面。
 语音小管家
