语音小管家
FluxMusic 是一种将当下最火、效果最好的 Flux 文生图模型技术扩展到音乐生成的开源模型,能够很好的遵循提示词生成音乐,并且更自然流畅。
源码库:https://github.com/feizc/FluxMusic
论文:https://arxiv.org/pdf/2409.00587
FluxMusic主要功能
文本到音乐生成:将文本描述直接转换成音乐。
语义理解:利用预训练的文本编码器捕捉文本中的语义信息,确保生成的音乐与文本描述的情感和风格相匹配。
灵活的推理:通过多个文本编码器的组合,提供灵活的推理选项。
高效训练:采用修正流训练方法,提高模型训练的效率和生成音乐的质量。
FluxMusic技术原理
扩散模型:基于扩散模型,通过逐步逆转数据从有序状态到随机噪声的转换过程,来生成音乐。
修正流(Rectified Flow):利用修正流技术优化数据和噪声之间的连接,提高理论属性和生成效果。
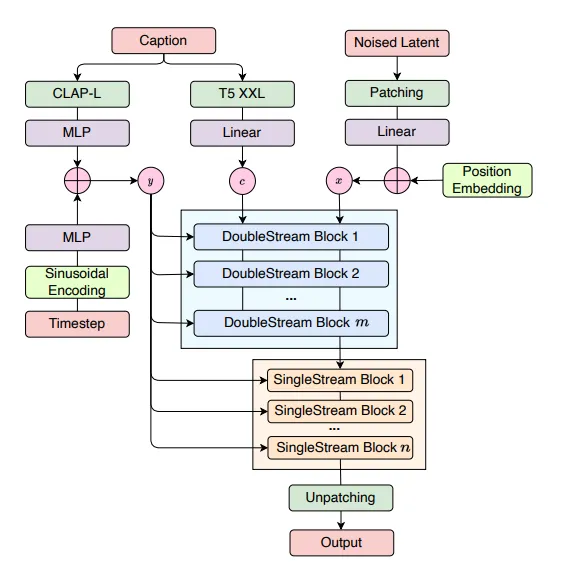
双流注意力机制:在模型初期使用双流注意力机制处理文本和音乐的联合序列,实现信息的双向流动。
堆叠单流块:在文本流被丢弃后,使用堆叠的单音乐流块专注于音乐序列建模。
变分自编码器(VAE):将音乐压缩成潜在空间表示,作为噪声添加和模型训练的基础。
梅尔频谱:将音频信号转换为梅尔频谱,作为音乐表示和生成过程的一部分。
预训练文本编码器:使用如T5 XXL和CLAP-L等预训练模型提取文本特征,增强模型对文本描述的理解能力。
调制机制:结合粗略文本信息和时间步嵌入,用于调整音乐生成过程。
细粒度文本细节: 将细粒度文本信息与音乐补丁序列结合,作为模型输入。