大模型领域的技术发展,今天起再次「从 1 开始」了。

就在刚刚,OpenAI最强的o1系列模型忽然上线。毫无预警地,OpenAI就扔出这一声炸雷。传说中两周内就要上线的草莓模型,居然两天内就来了!


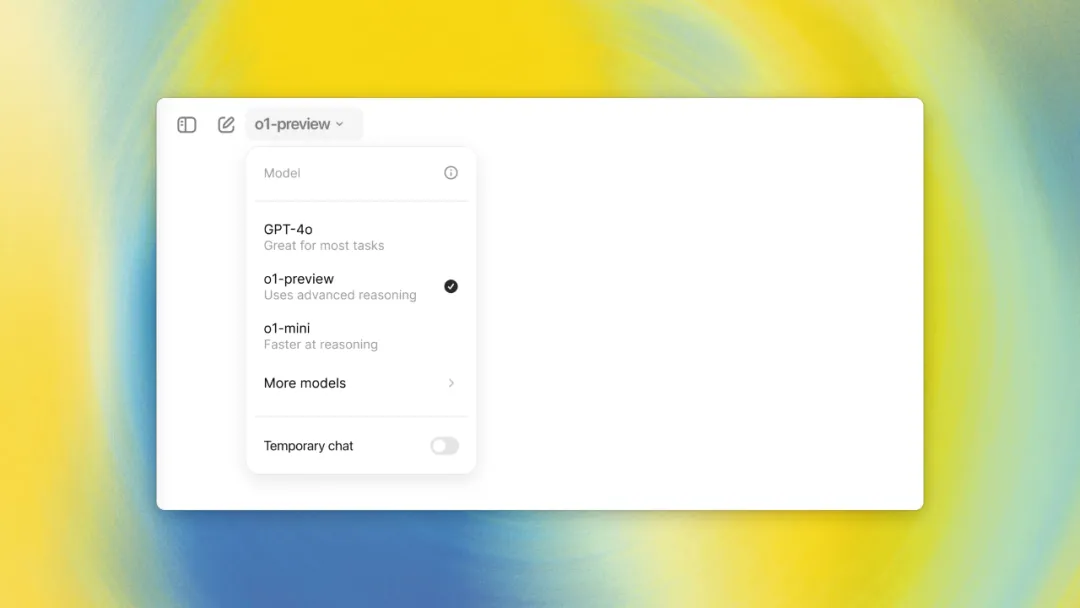
从今天开始,o1-preview在ChatGPT中会向所有Plus和Team用户推出,并且在API中向tier 5开发者推出。同时,OpenAI还发布了o1-mini——一种经济高效的推理模型,非常擅长STEM,尤其是数学和编码。
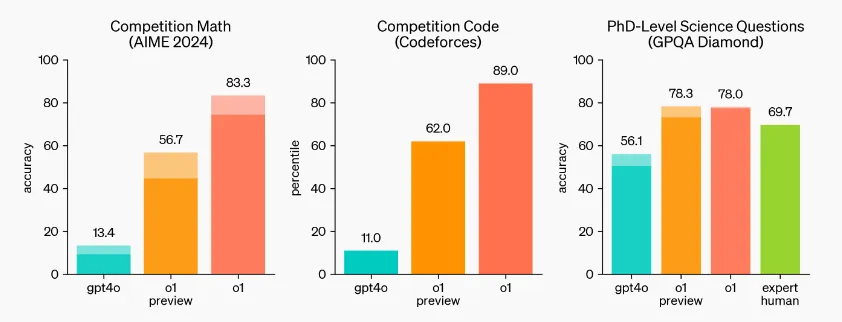
官方宣称其推理能力相比较当前的大语言模型(GPT-4o)有了大幅提升。OpenAI宣称o1模型在编程竞赛问题(Codeforces)中排名第89百分位,在美国数学奥林匹克(AIME)的资格赛中位列美国前500名,并且在物理、 生物和化学问题的基准测试(GPQA)上超越了人类博士水平的准确率。

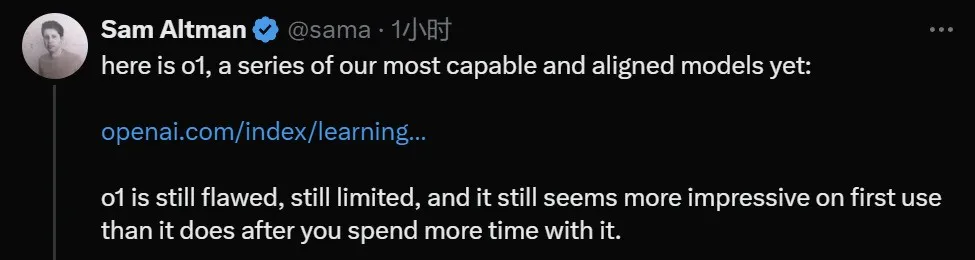
奥特曼表示,虽然 o1 的表现仍然存在缺陷,不过你在第一次使用它的时候仍然会感到震撼。

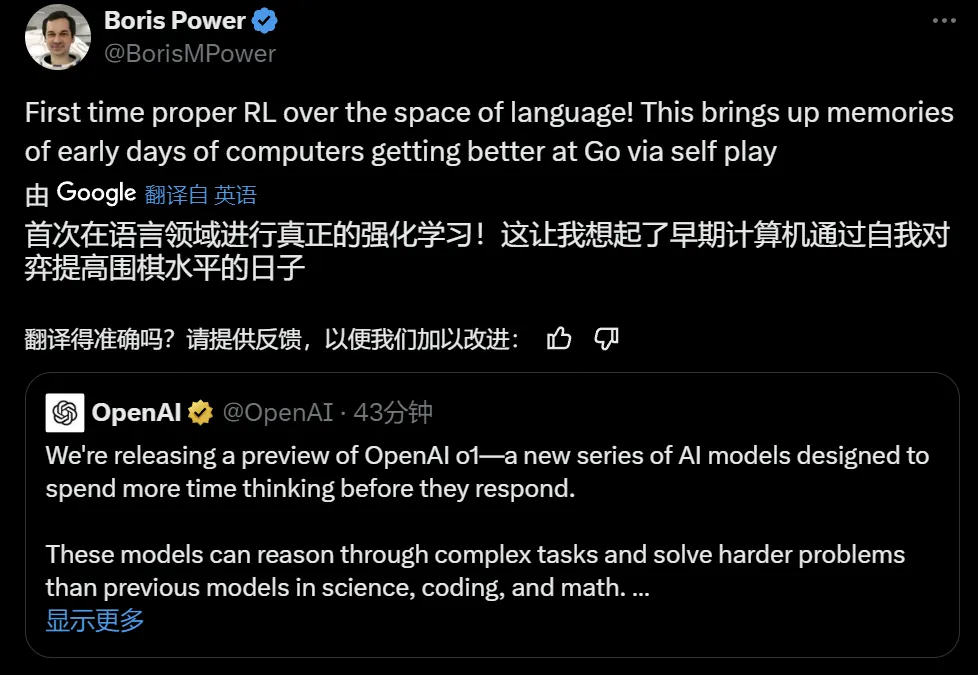
其次,o1 给大模型规模扩展 vs 性能的曲线带来了一次上翘。它在大模型领域重现了当年 AlphaGo 强化学习的成功 —— 给越多算力,就输出越多智能,一直到超越人类水平。
也就是从方法上,o1 大模型首次证明了语言模型可以进行真正的强化学习。

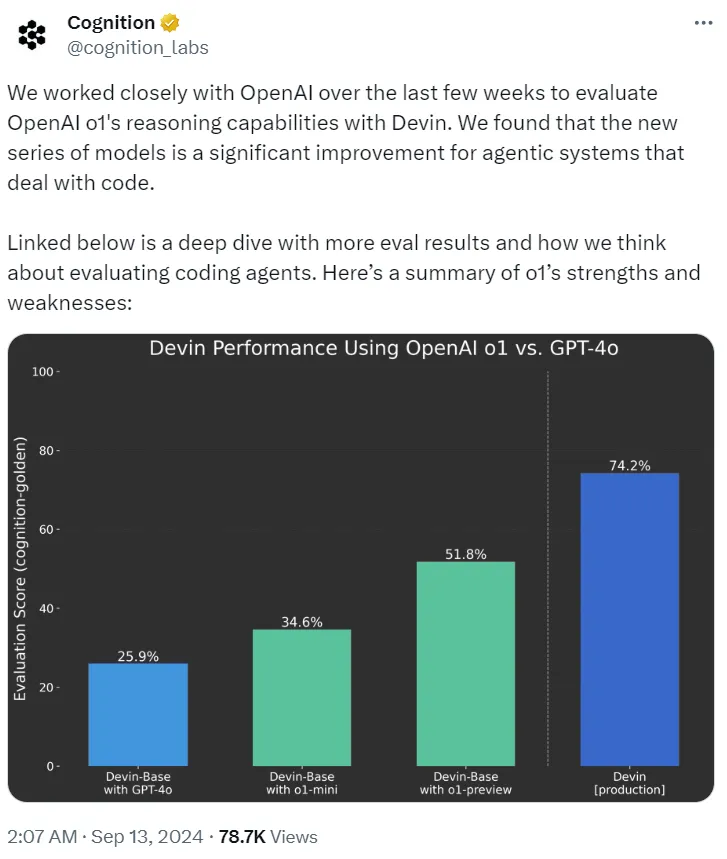
开发出首个 AI 软件工程师 Devin 的 Cognition AI 表示,过去几周一直与 OpenAI 密切合作,使用 Devin 评估 o1 的推理能力。结果发现, 与 GPT-4o 相比,o1 系列模型对于处理代码的智能体系统来说是一个重大进步。

最后在实践中,o1 上线之后,现在 ChatGPT 可以在回答问题前先仔细思考,而不是立即脱口而出答案。就像人类大脑的系统 1 和系统 2,ChatGPT 已经从仅使用系统 1(快速、自动、直观、易出错)进化到了可使用系统 2 思维(缓慢、深思熟虑、有意识、可靠)。这让它能够解决以前无法解决的问题。


OpenAI o1 工作原理

在技术博客《Learning to Reason with LLMs》中,OpenAI 对 o1 系列语言模型做了详细的技术介绍。
OpenAI o1 是经过强化学习训练来执行复杂推理任务的新型语言模型。特点就是,o1 在回答之前会思考 —— 它可以在响应用户之前产生一个很长的内部思维链。
也就是该模型在作出反应之前,需要像人类一样,花更多时间思考问题。通过训练,它们学会完善自己的思维过程,尝试不同的策略,并认识到自己的错误。
在 OpenAI 的测试中,该系列后续更新的模型在物理、化学和生物学这些具有挑战性的基准任务上的表现与博士生相似。OpenAI 还发现它在数学和编码方面表现出色。
在国际数学奥林匹克(IMO)资格考试中,GPT-4o 仅正确解答了 13% 的问题,而 o1 模型正确解答了 83% 的问题。
模型的编码能力也在比赛中得到了评估,在 Codeforces 比赛中排名 89%。
OpenAI 表示,作为早期模型,它还不具备 ChatGPT 的许多实用功能,例如浏览网页获取信息以及上传文件和图片。
但对于复杂的推理任务来说,这是一个重大进步,代表了人工智能能力的新水平。鉴于此,OpenAI 将计数器重置为 1,并将该系列模型命名为 OpenAI o1。
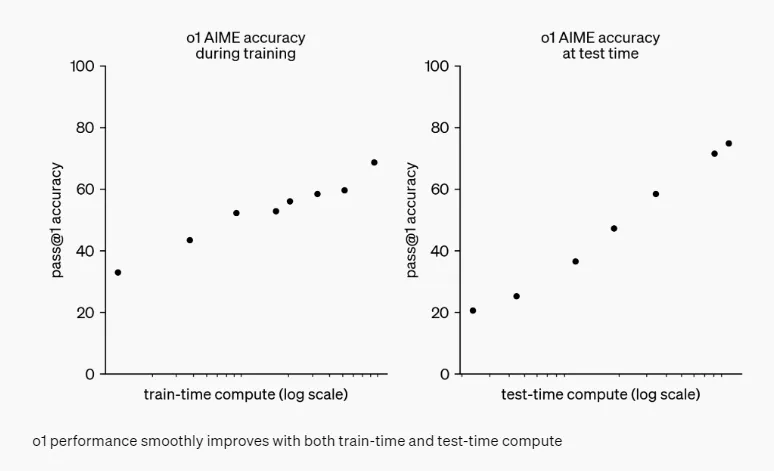
重点在于,OpenAI 的大规模强化学习算法,教会模型如何在数据高度有效的训练过程中利用其思想链进行高效思考。换言之,类似于强化学习的 Scaling Law。
OpenAI 发现,随着更多的强化学习(训练时计算)和更多的思考时间(测试时计算),o1 的性能持续提高。而且扩展这种方法的限制与大模型预训练的限制有很大不同,OpenAI 也还在继续研究。

评估
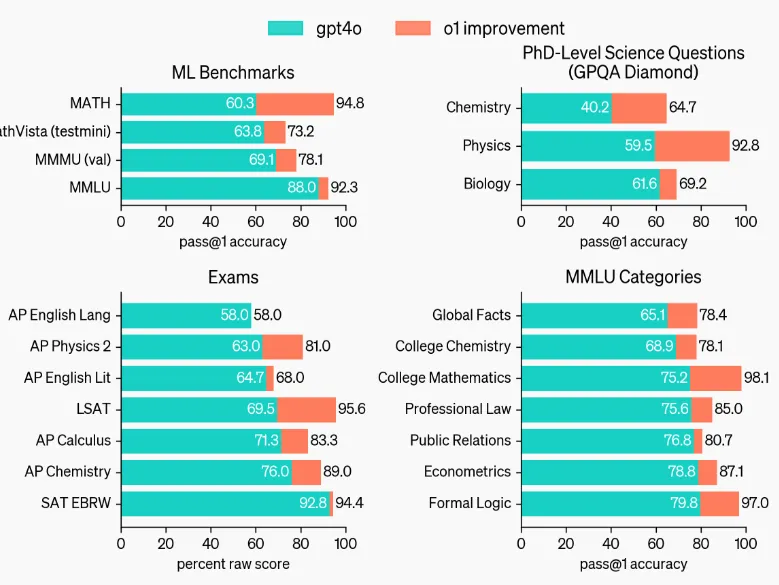
为了突出相对于 GPT-4o 的推理性能改进,OpenAI 在一系列不同的人类考试和机器学习基准测试中测试了 o1 模型。实验结果表明,在绝大多数推理任务中,o1 的表现明显优于 GPT-4o。

o1 在具有挑战性的推理基准上比 GPT-4o 有了很大的改进。

o1 在广泛的基准测试上比 GPT-4o 有所改进,包括 54/57 MMLU 子类别,图示出了 7 个以供说明。
在许多推理密集型基准测试中,o1 的表现可与人类专家相媲美。最近的前沿模型在 MATH 和 GSM8K 上表现得非常好,以至于这些基准测试在区分模型方面不再有效。因此,OpenAI 在 AIME 上评估了数学成绩,这是一项旨在测试美国最聪明高中数学学生的考试。

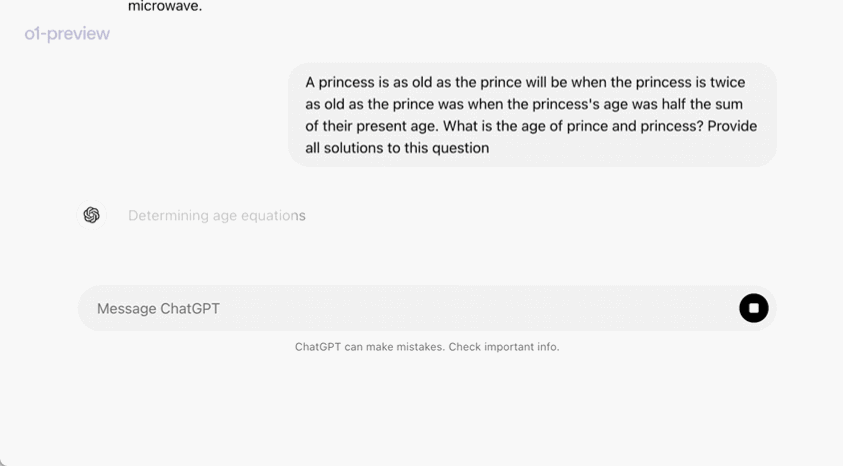
在一个官方演示中,o1-preview 解答了一个非常困难的推理问题:当公主的年龄是王子的两倍时,公主的年龄与王子一样大,而公主的年龄是他们现在年龄总和的一半。王子和公主的年龄是多少?提供这个问题的所有解。
在 2024 年 AIME 考试中,GPT-4o 平均只解决了 12% (1.8/15) 的问题,而 o1 在每个问题只有一个样本的情况下平均为 74% (11.1/15),在 64 个样本之间达成一致的情况下为 83% (12.5/15),在使用学习的评分函数对 1000 个样本重新排序时为 93% (13.9/15)。13.9 分可以跻身全美前 500 名,并且高于美国数学奥林匹克竞赛分数线。
OpenAI 还在 GPQA Diamond 基准上评估了 o1,这是一个困难的智力基准,用于测试化学、物理和生物学方面的专业知识。为了将模型与人类进行比较,OpenAI 聘请了拥有博士学位的专家来回答 GPQA Diamond 基准问题。
实验结果表明:o1 超越了人类专家的表现,成为第一个在该基准测试中做到这一点的模型。
这些结果并不意味着 o1 在所有方面都比博士更有能力 —— 只是该模型更擅长解决一些博士应该解决的问题。在其他几个 ML 基准测试中,o1 实现了新的 SOTA。
启用视觉感知能力后,o1 在 MMMU 基准上得分为 78.2%,成为第一个与人类专家相当的模型。o1 还在 57 个 MMLU 子类别中的 54 个上优于 GPT-4o。

思维链

通过强化学习,o1学会了识别并纠正自己的错误,并将复杂的步骤分解为更简单的步骤。在当前方法不起作用时,它还会尝试不同的方法。这个过程显著提高了模型的推理能力。
举个「密码学」的例子。
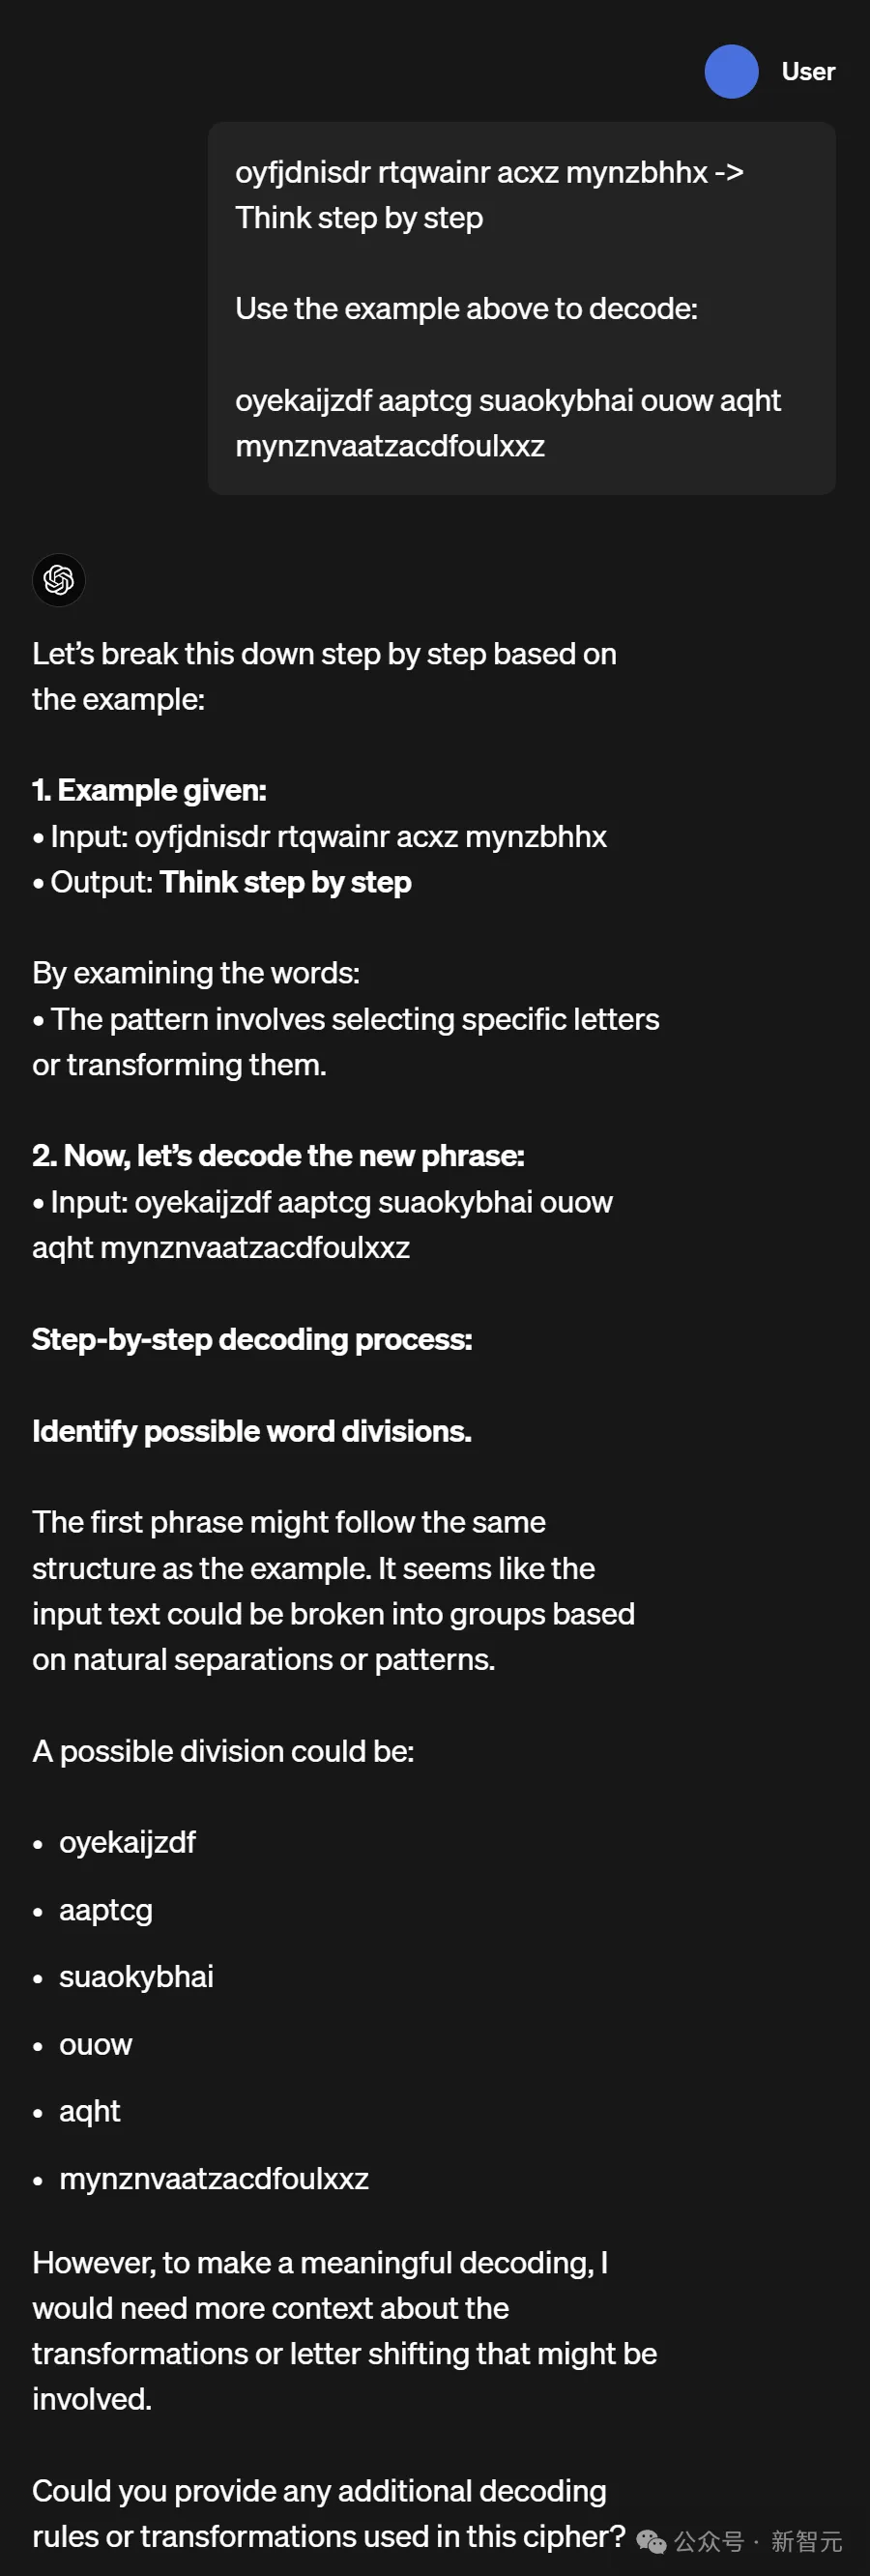
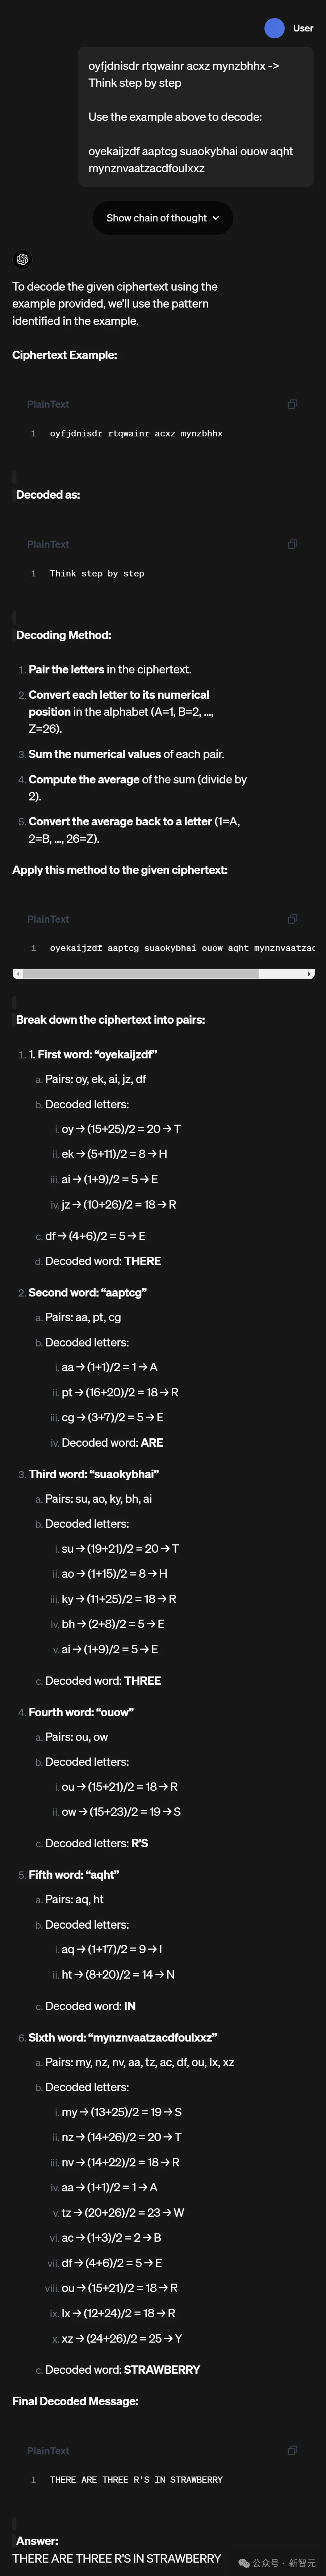
题面是:「Think step by step」经过加密之后对应的是「oyfjdnisdr rtqwainr acxz mynzbhhx」,问「oyekaijzdf aaptcg suaokybhai ouow aqht mynznvaatzacdfoulxxz」的意思是什么。
可以看到,GPT-4o对这种题目完全是束手无策。而o1则根据已知信息推理出了加密计算的方法,并最终给出了正确答案——THERE ARE THREE R'S IN STRAWBERRY。


GPT-4o


o1-preview

编程能力
在这项评测中,OpenAI基于o1进一步训练出了一个编程加强版模型。
在2024年国际信息学奥林匹克竞赛(IOI)中,新模型获得了213分,排名在49%的位置上。
过程中,模型有十个小时来解决六个具有挑战性的算法问题,每个问题允许提交50次。
而在放宽提交限制的情况下,模型的性能可以获得显著提升。当每个问题允许1万次提交时,模型达到了362.14分——超过了金牌的门槛。
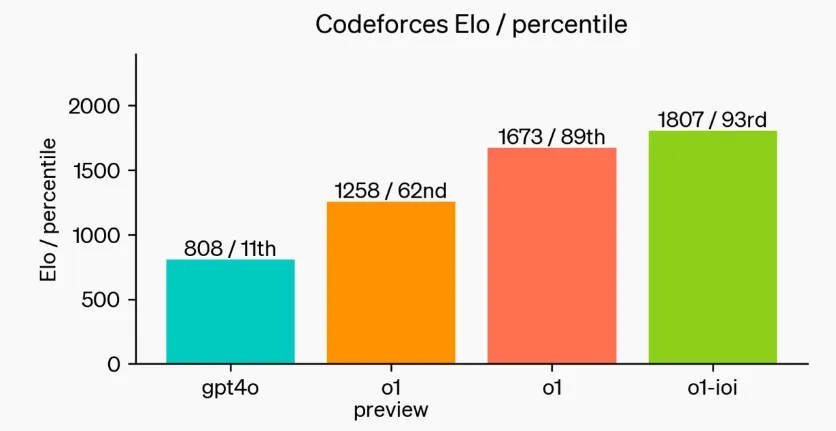
最后,OpenAI还模拟了由Codeforces举办的竞技编程比赛——严格遵循规则,并允许10次提交。
GPT-4o的Elo评分为808,位于人类选手11%的位置。而新模型则远远超过了GPT-4o和o1,达到了1807的高分,表现优于93%的选手。

在编程竞赛上进一步微调使得 o1 能力又增,并在 2024 年国际信息学奥林匹克竞赛(IOI)规则下排名前 49%。
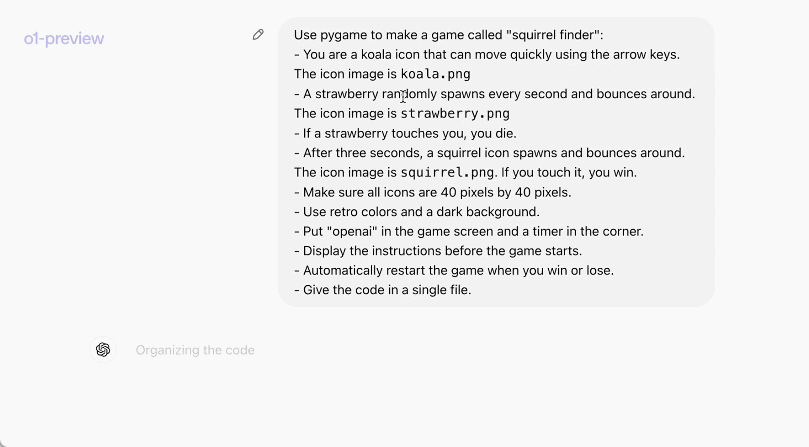
下面这个官方示例直观地展示了 o1-preview 的编程能力:一段提示词就让其写出了一个完整可运行的游戏。

人类偏好评估
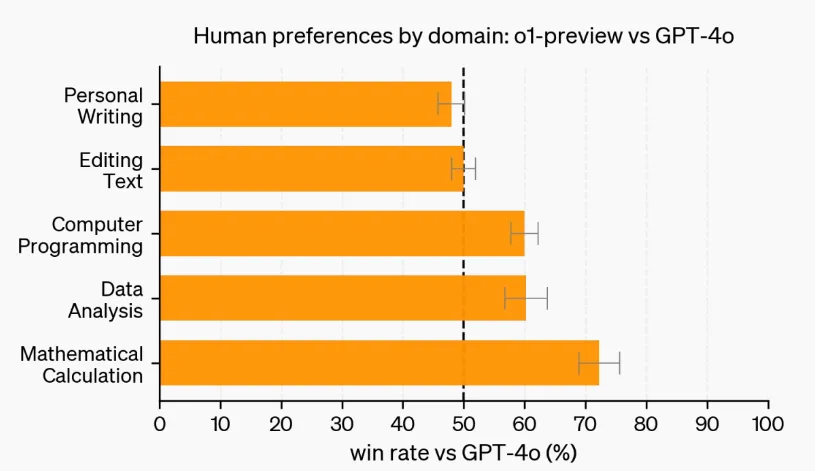
除了考试和学术基准测试之外,OpenAI还评估了人类对o1-preview与GPT-4o在广泛领域内具有挑战性、开放性提示词上的偏好。
在此评估中,人类会看到o1-preview和GPT-4o对提示词的匿名响应,并投票选择他们更喜欢哪个响应。在数据分析、编程和数学等重推理的类别中,人们更倾向于选择o1-preview。但在一些自然语言任务中,GPT-4o更胜一筹。
也就是说,o1-preview目前并不适合所有的使用场景。

在需要更强大推理能力的领域,人们更青睐 o1-preview


隐藏了o1模型背后的原始思维链推理过程
如前所述,OpenAI o1模型在训练和推理过程都使用了思维链方式,在推理阶段,OpenAI提出了“隐藏思维链”的概念(a hidden chain of thought),隐藏思维链被视为一种监控AI模型内部思考过程的有效工具,可用于理解模型的推理过程并检测潜在问题。它提供了一种独特的机会来”读取”模型的”思维”,理解其思考过程。
但是,思维链监控有效性的前提条件是思维链必须忠实和可读。且模型需要自由表达其未经改动的思想。因此,不能在思维链上训练任何政策合规性或用户偏好。
OpenAI经权衡多方面因素(用户体验、竞争优势、监控选项),决定不向用户展示原始思维链。但是,作为补偿,对于o1模型系列,OpenAI会展示一个由模型生成的思维链摘要。

OpenAI o1-mini

为了给开发人员提供更高效的解决方案,OpenAI发布了o1-mini——一种更快、更便宜的推理模型。作为一种较小的模型,o1-mini比o1-preview便宜80%。
这对于需要推理,但不需要通用世界知识的应用程序来说,它是一种功能强大、性价比高的模型。不过,目前的o1系列依然处在早期,诸如网络插件、长传文件、图片等能力,还未集成。在短期内,GPT-4o仍是最强的实力选手。


OpenAI o1的使用

目前,ChatGPT Plus订阅用户已经可以使用该模型。不过,作为早期模型,尚未具备ChatGPT的许多实用功能,如网页浏览、文件和图像上传等。
而且,每位用户每周仅能给 o1-preview 发送 30 条消息,给 o1-mini 发送 50 条消息。短期内,GPT-4o在许多常见任务中可能更加有能力。至于企业版和教育版用户,要到下周才能开始使用这两个模型。
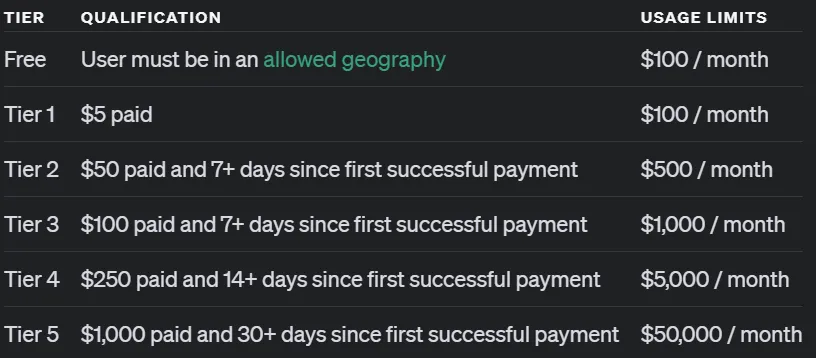
至于通过 API 访问的用户,OpenAI 表示达到了 5 级 API 使用量的开发者可以即刻开始使用这两个模型开始开发应用原型,但同样也被限了速:20 RPM。什么是 5 级 API 使用量?简单来说,就是已经消费了 1000 美元以上并且已经是超过 1 个月的付费用户。请看下图:

OpenAI 表示对这两个模型的 API 调用并不包含函数调用、流式传输(streaming)、系统支持消息等功能。同样,OpenAI 表示正在努力提升这些限制。


结 论

OpenAI o1 模型的诞生,无疑掀开了人工智能发展的新篇章。它不仅是技术上的飞跃,更引发了我们对 AI 未来发展方向的深层思考。思维链机制的引入,特别是其支持隐藏部分思维链的特性,如同在通往 AI 心智的道路上竖立了一面镜子,映照出我们在可解释性、安全性和效率之间寻求平衡的艰巨挑战。