当前音乐生成(音效生成)领域的问题为质量低,具体来说分为三方面:
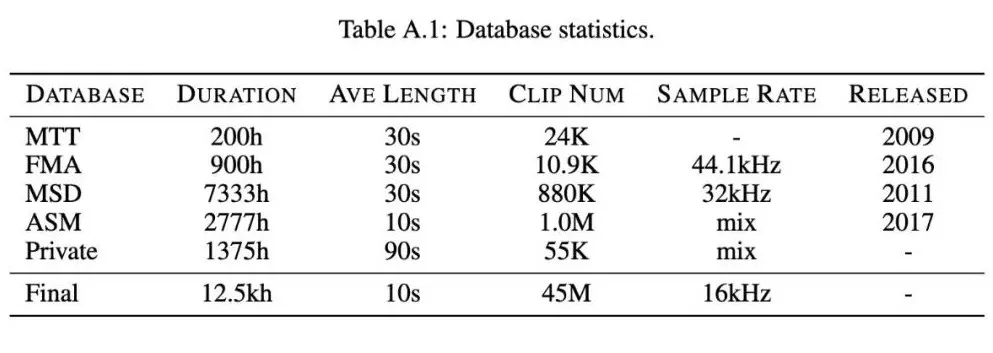
大部分开源数据集音质低(FMA,AudioSet,MSD),旋律杂乱;
音乐性(美学角度)差;
文本对齐度低,大多数音频处于少标签,弱标签,错标签。
解决
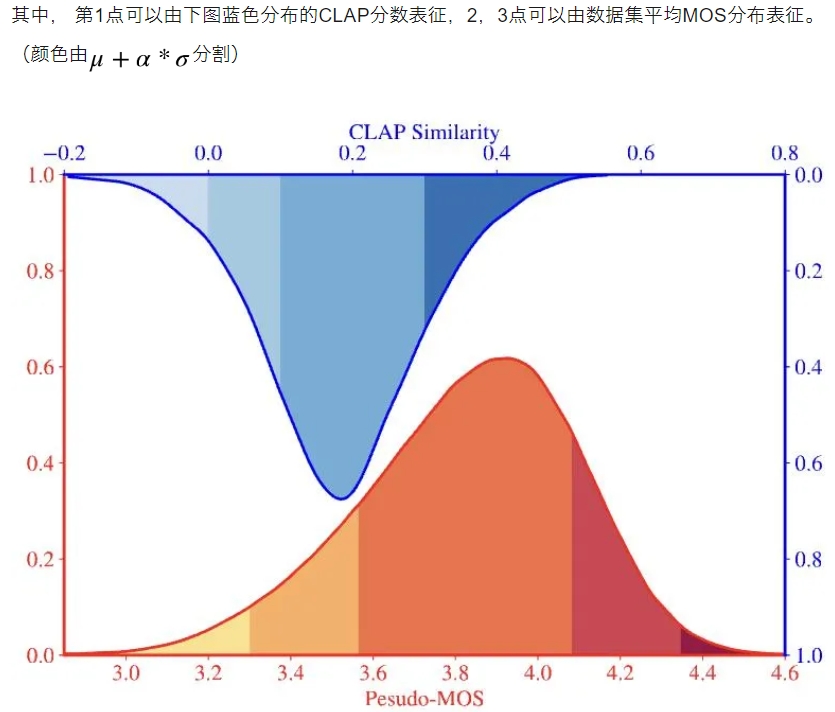
引入质量感知训练策略。采用主观数据集中的MOS分训练出的质量评分模型,在训练过程中注入(伪MOS分)音频质量信息。两种注入方法:
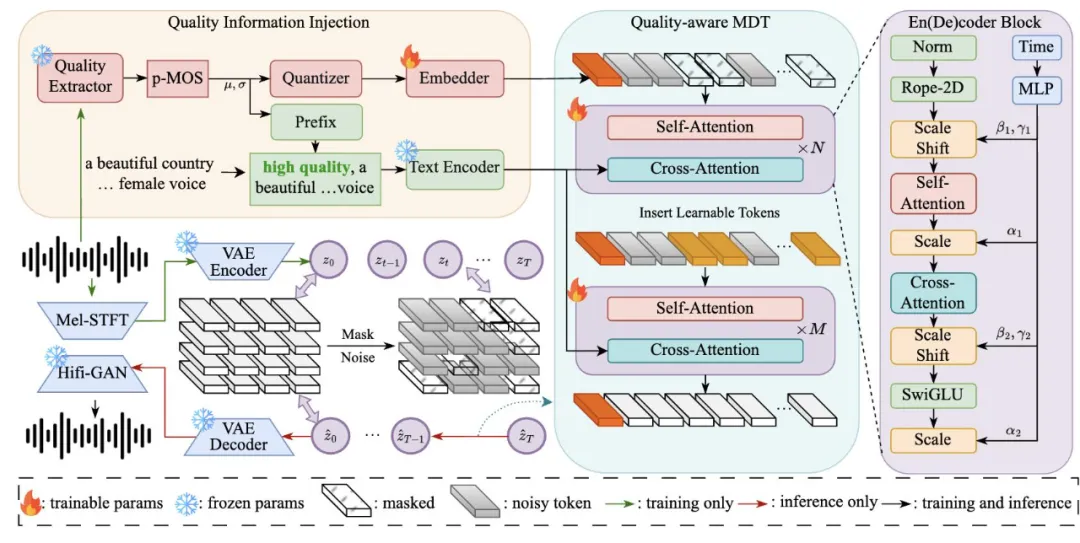
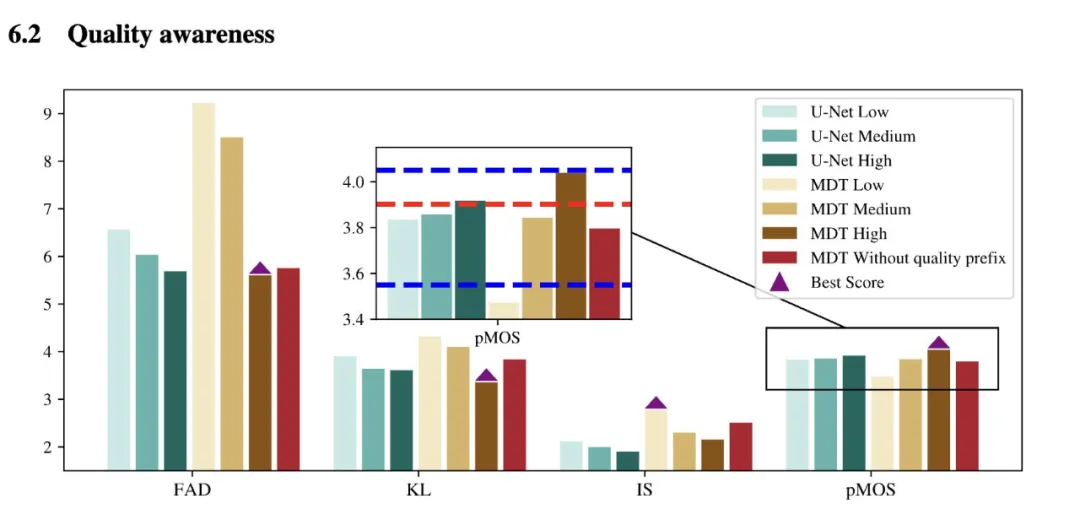
质量感知策略允许了在推理阶段以高质量文本和质量token进行引导,从而生成显著高于训练集平均质量的音频。以类似解耦的方式在训练中感知音频的质量(类似TTS中分离出音色训练),从而更好地促进了模型的训练(大幅降低FAD,KL,并提升IS,REL,CLAP等指标)我们还发现,粗粒度文本控制和细粒度token控制相结合,更有助于模型训练中解耦,感知,并控制更高质量音频的生成,从而解决训练数据集影响的问题。
解决:
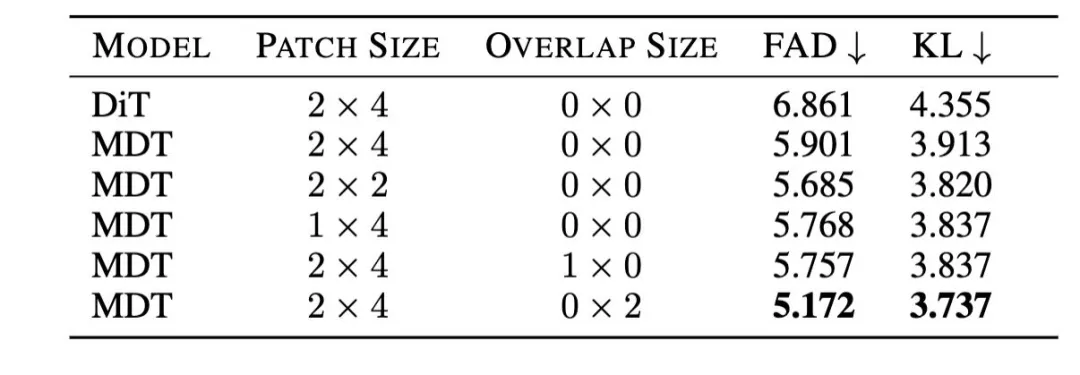
从音乐性建模角度,我们发现U-ViT/DiT类架构对频谱隐空间建模也具有图像上表达的scale ability,并能更好建模谐波,音色等方面(反应在主观评分)优化(1):对频谱切片而言,此类结构的收敛速度慢。消融数据集中,20w步时依然不能很好控制收敛,推测来源于时域/频域相关性弱。故在预训练阶段加入掩码,加速训练速度和频谱关联性。微调阶段以高质量数据进一步强化模型(5W步就有收敛迹象)。优化(2):相比于U-Net,transformer based架构对text encoder的质量信息感知能力增强,并且U-ViT 式 token 质量融入策略显著有效进一步提升质量并降低客观指标。优化(3):图像中切块未考虑 overlap,探究了overlap策略在合成中的作用(大幅降低FAD,但在主观听感上有trade off) 。
首次在音乐生成领域使用预训练标注模型(LP-Musiccaps)进行大规模标注优化(1):考虑到标注模型的不充分训练导致错标,以CLAP文本-音频分数+阈值筛选低分数据。优化(2):考虑到原始标注中有些词(例如说American,R&B等标注器不一定能标注出的词) 使用CLAP分数过滤出生成的与原始的文本相似度低低数据,利用语言模型融合原始标注中有用信息。
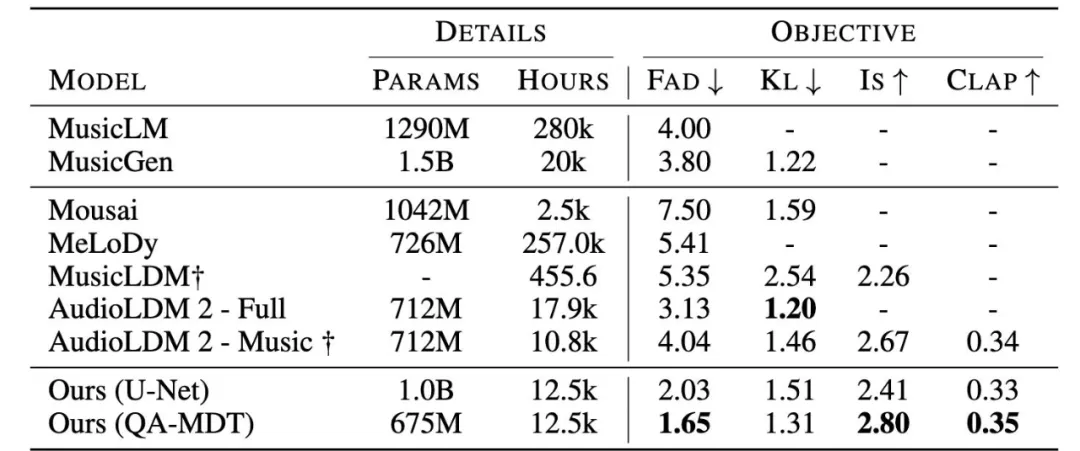
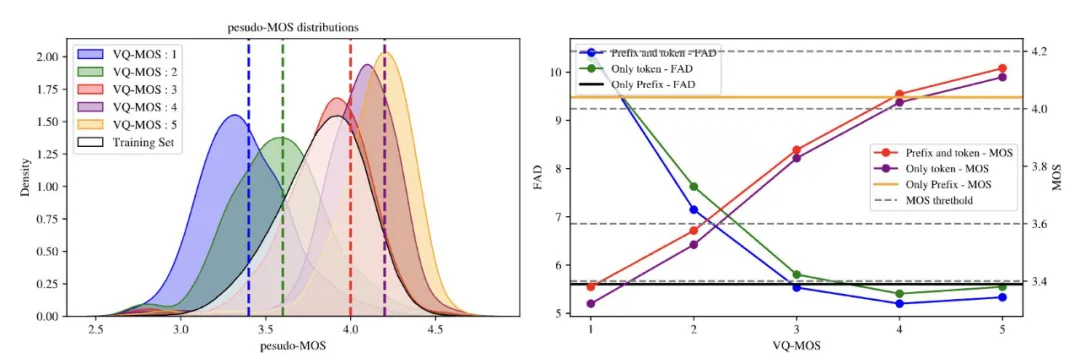
1、总体对比与,对比U-net架构和transformer based架构此图证明了相比于无质量感知,大幅提升了生成质量和客观指标并且,MDT(我们的架构)比 U-Net 在文本质量控制感知上的独特优势(生成质量更高,总体客观指标更好)左图展示了 token as control 的准确感知控制生成能力,生成的高质量数据(黄色区域)显著高于训练集MOS分。右图展示了文本质量控制和token质量控制的结合效果与单纯token和文本控制的对比。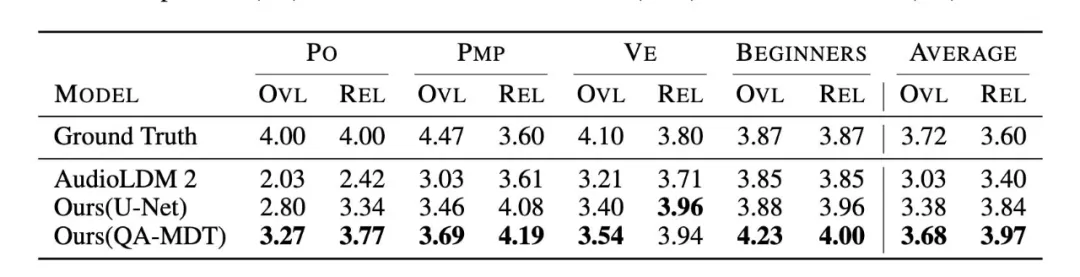
主观评测结果(各个人的评分下,均有优势)
PO:产品运营
PMP:专业音乐制作人
VE:视频编辑人
BEGINNERS:不懂音乐的小白

 语音小管家