
 语音小管家
第二个例子查询文本是一句话"Something is falling to the ground and making a clank."。整段音频,前半部分是金属物体掉落的声音,后面是两个人谈话;分离后的音频两个人谈话的声音被很好的去除了,留下了完整的物品掉落声。总体来说,音频分离的效果还是不错的。
AudioSep的整体网络结构如下图所示,主要包含两个部分,文本编码器和音频分离网络。
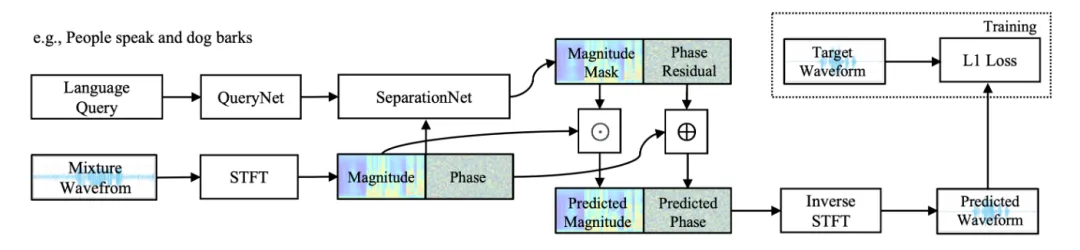
文本编码器(QueryNet)复用了CLIP/CLAP的文本编码器部分,该编码器将文本编码成固定长度为D的特征;音频分离网络(SeparationNet)采用了音频 ResUNet 模型,首先对混合音频进行短时傅里叶变换复数谱,进而得到混合音频的幅度谱和相位。ResUNet是一个encoder-decoder的结构,其输入是复数谱,输出是幅度谱的mask和相位的残差,然后通过如下公式重构音频信号
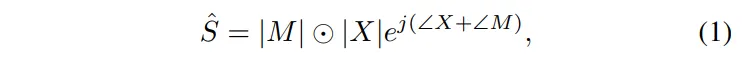
为了连接文本编码器和分离模型,在 ResUNet 中每个 ConvBlock 之后使用了特征线性调制(Feature-wise Linearly modulated ,FiLm),简单来说就是从文本特征计算两个系数,然后将这两个系数对音频输出的feature map进行计算,计算公式如下所示:
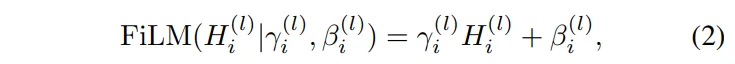
在训练过程中,构造混合音频时会使用响度数据扩增,将两个独立的音频调整到相同的响度水平,然后对模型重构的音频波形与目标音频计算L1 loss作为网络的损失函数。最后模型使用SI-SDR(scale-invariant SDR)和SDRi(signal-to-distortion ratio improvement)作为评价指标,在多个数据集上取得了SOTA的效果。
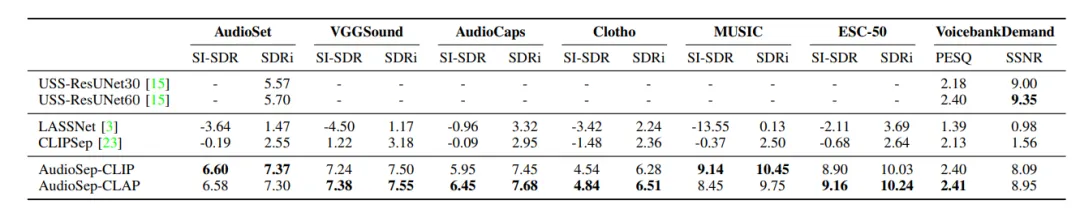
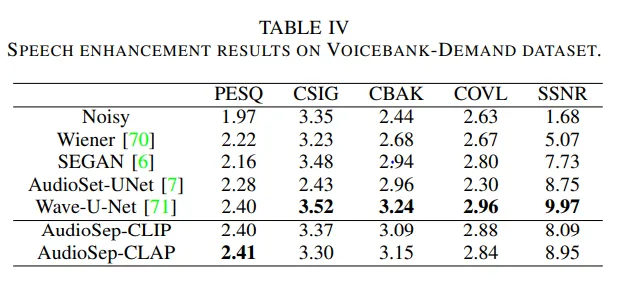
语音增强作为语音分离的子任务,但AudioSep在语音增强任务上效果则没有音频分离那么出色。
参考文献:
[1]. https://github.com/Audio-AGI/AudioSep
[2]. https://audio-agi.github.io/Separate-Anything-You-Describe/AudioSep_arXiv.pdf
