近日,约翰霍普金斯大学与腾讯 AI 实验室联合推出了一款名为 EzAudio 的新型文本到音频生成模型。和之前发布的audiocraft和 Stable Audio Tools 类似,都可以通过一段提示词生成对应逼真的音频文件。EzAudio是一种基于Transformer的T2A扩散模型,旨在解决传统T2A模型在生成质量、计算成本、扩散采样和数据准备等方面的挑战。项目背景
随着人工智能的发展,潜扩散模型在文本到音频(T2A)生成中遇到挑战。以往研究将2D mel spectrograms视为图像,使用2D U-Nets生成音频,导致计算成本高、时间分辨率差且音频质量下降。缺乏大规模标注数据集也限制了模型性能。为解决这些问题,EzAudio应运而生,结合波形VAE和优化变压器架构,致力于高效高质量的T2A生成。
主要功能
EzAudio模型以其卓越的性能和创新特点,为用户提供了一系列令人兴奋的功能:1、文本到音频生成
EzAudio能够将文本描述转化为音频输出,无论是对话、旁白还是音效,都能够根据文本内容生成相应的声音,为创作者提供了一个全新的音频创作工具。2、高效率的扩散模型
模型采用了优化的扩散变压器架构,这不仅提高了音频生成的速度,同时也确保了音频输出的质量,使得生成的音频更加清晰、自然。3、数据高效训练策略
EzAudio通过结合未标记数据、音频-语言模型注释的数据和人工标记数据进行训练,显著提高了模型的训练效率和性能,同时也降低了对大量标注数据的依赖。4、高保真音频输出
EzAudio能够生成接近真实录音质量的音频,无论是在频率响应还是在动态范围上,都能够达到令人满意的效果,为用户提供了逼真的听觉体验。
EzAudio的核心组件与技术
1、波形VAE
EzAudio采用基于波形的VAE,避免了处理2D spectrogram表示的复杂性,同时减少了计算成本,提高了时间分辨率。此外,它不需要额外的神经声码器,能够直接从音频波形的潜在表示中重建音频,从而保证了音频的高质量重建。2、高效的EzAudio - DiT架构
为了使DiT更适合T2A,EzAudio进行了多项创新设计。其中,AdaLN - SOLA通过使用一个共享的AdaLN模块和每个块的低秩矩阵,在减少模型参数和内存使用的同时,保持了模型性能和数值稳定性。长跳跃连接的应用有助于变压器保留输入信息的细节,提高了模型对波形潜在嵌入的处理能力。此外,RoPE和QK - Norm的使用也进一步稳定了DiT的训练。针对T2A数据不足的问题,EzAudio采用了多阶段训练策略。首先,通过掩码扩散建模,让模型在大规模数据集上进行自监督学习,学习声学依赖关系。然后,利用合成字幕数据进行文本 - 音频对齐训练,增加音频和语言的多样性。最后,在人工标注的数据上进行微调,确保精确的音频生成。4、Classifier - Free Guidance Rescaling
为了改善扩散模型的采样效果,EzAudio采用了CFG重缩放技术。当使用较大的CFG分数时,该技术可以在增强提示对齐的同时,最大限度地减少对生成质量的影响。通过调整v的大小,同时保持其方向,使得模型在更高的CFG分数下仍能保持较强的文本对齐能力,同时减轻对音频质量的负面影响。
使用方法
下载一键包,双击一键启动,等待自动跳转到WebUI界面。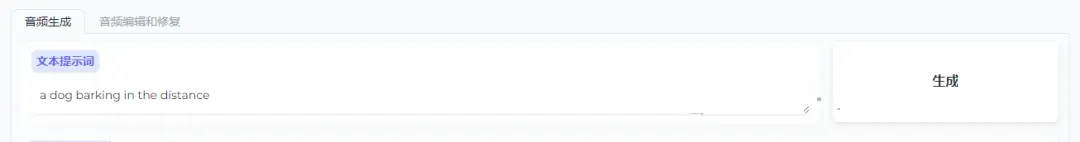
操作很简单,只需要输入一段提示词,比如输入“a dog barking in the distance”(一只狗在远处吠叫),然后点“生成”即可。EzAudio 作为一款具有创新性的开源项目,为文本到音频生成技术带来了重大突破。它不仅解决了传统 T2A 模型所面临的诸多挑战,还展现出了在多个领域的广泛应用前景。相信 EzAudio 将继续发展和完善,为AI语音做出更多贡献。  语音小管家

