
 语音小管家
随着 OpenAI GPT-4o 的发布,大语言模型已经不再局限于文本处理,而是向着全模态智能助手的方向发展。这篇论文提出了 EMOVA(EMotionally Omni-present Voice Assistant),一个能够同时处理图像、文本和语音模态,能看、能听、会说的多模态全能助手,并通过情感控制,拥有更加人性化的交流能力。以下,我们将深入了解 EMOVA 的研究背景、模型架构和实验效果。
研究背景:全模态交互的挑战
近年来,多模态大模型得到广泛关注,尤其是可以同时处理视觉和语言信息的模型,如 LLaVA [1] 和 Intern-VL [2],或者语音文本交互的模型,如 Mini-Omni [3]。然而,当前的研究多偏向于双模态组合,要让大语言模型在 “看、听、说” 三个方面同时具备优越表现依然充满挑战。传统的解决方案往往依赖外部语音生成工具,无法实现真正的端到端语音对话。而 EMOVA 的出现填补了这个空白,在保持图文理解性能不下降的前提下,让模型具备情感丰富的语音交流能力,实现了一个全能型、情感丰富、能看能听会说的智能助手。
模型架构:情感对话与多模态理解的有效结合
EMOVA 的架构如图一所示,它结合了连续的视觉编码器和离散的语音分词器,能够将输入的图像、文本和语音信息进行高效处理,并端到端生成文本和带情感的语音输出。以下是其架构的几个关键点:
1. 视觉编码器:采用连续的视觉编码器,捕捉图像的精细视觉特征,保证领先的视觉语言理解性能;
2. 语音分词器:采用了语义声学分离的语音分词器,将输入的语音分解为语义内容(语音所表达的意思)和声学风格(语音的情感、音调等)。这种设计将语音输入转化为 “新的语言”,不仅降低了语音模态的合入难度,更为后续个性化语音生成以及情感注入提供了灵活度;
3. 情感控制模块:引入了一个轻量级的风格模块,支持对语音情感(如开心、悲伤等)、说话人特征(如性别)、语速、音调的控制,在保持语义不变的情况下,根据对话上下文动态调节语音输出的风格,使人机交互更加自然。
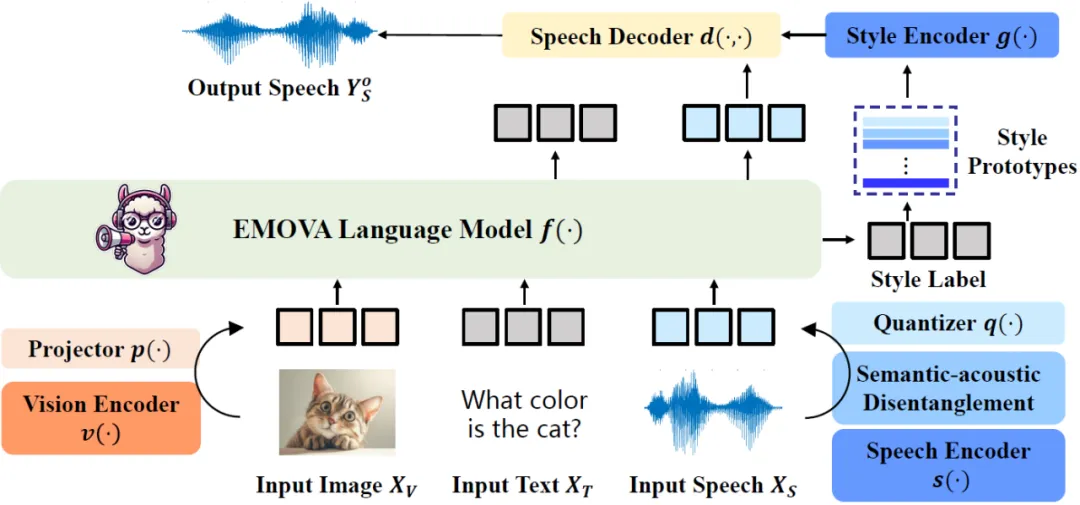
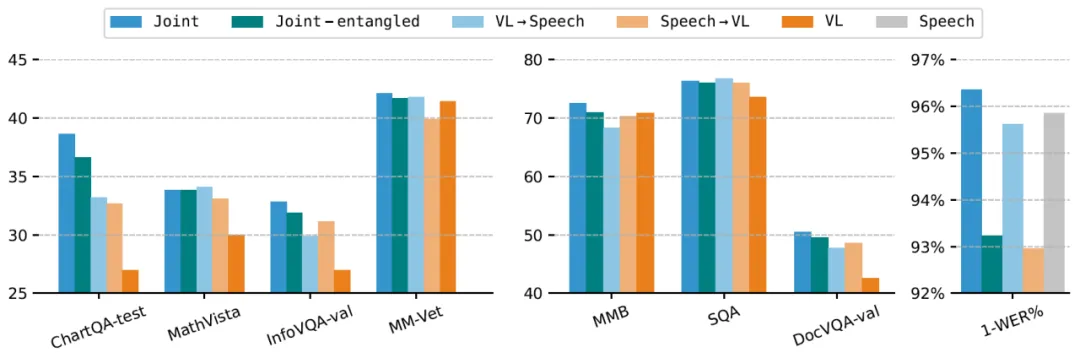
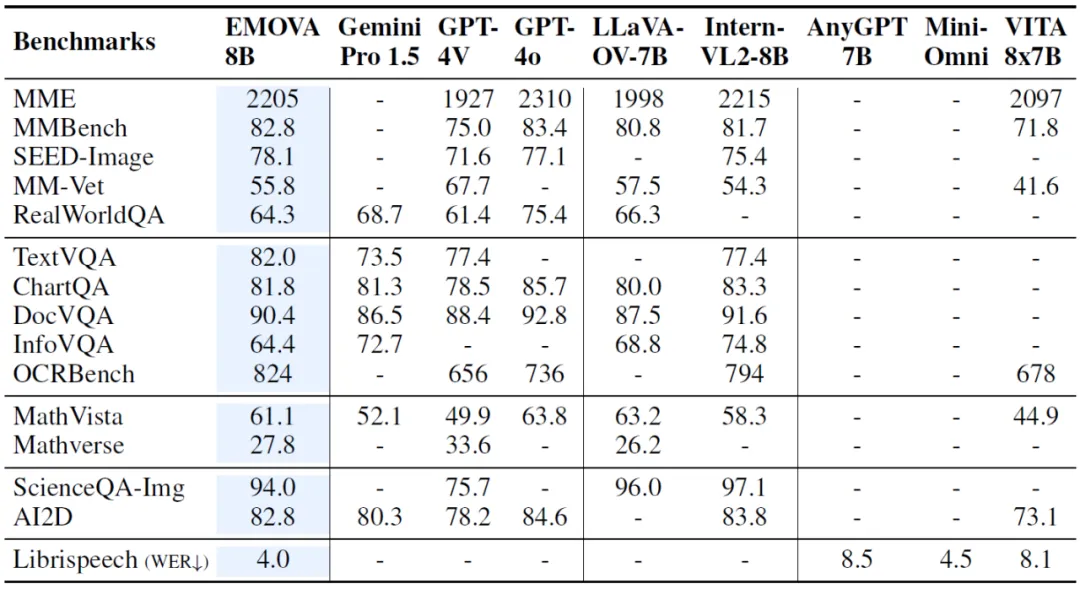
图 3 EMOVA 在视觉文本和语音文本任务上的性能测试
EMOVA 作为一个全模态的情感语音助手,实现了端到端的语音、图像、文本处理,并通过创新的语义声学分离和轻量化的情感控制模块,展现出优越的性能。无论是在实际应用还是研究前沿,EMOVA 都展现出了巨大的潜力,为未来 AI 具备更加人性化的情感表达提供的新的实现思路。
参考文献:
[1] Liu, H., Li, C., Wu, Q., & Lee, Y. J. (2024). Visual instruction tuning. In NeurIPS.
[2] Chen, Z., Wu, J., et al. (2024). InternVL: Scaling up vision foundation models and aligning for generic visual-linguistic tasks. In CVPR.
[3] Xie, Z., & Wu, C. (2024). Mini-Omni: Language Models Can Hear, Talk While Thinking in Streaming. arXiv preprint arXiv:2408.16725.
