
 语音小管家
CDSD: Chinese Dysarthria Speech Database
引 言
研究背景
CDSD数据库描述
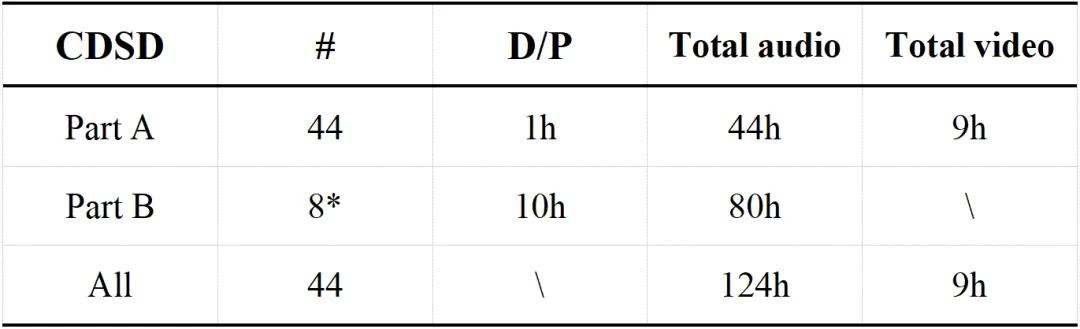
A部分:包含44名说话者的音频数据,共44小时,每人录制1小时。此外,还包括9名说话者的音视频同步录制。
B部分:由A部分中的8名说话者组成,录制了80小时的音频数据,每人录制10小时。
表1:CDSD数据库规模
数据库构建
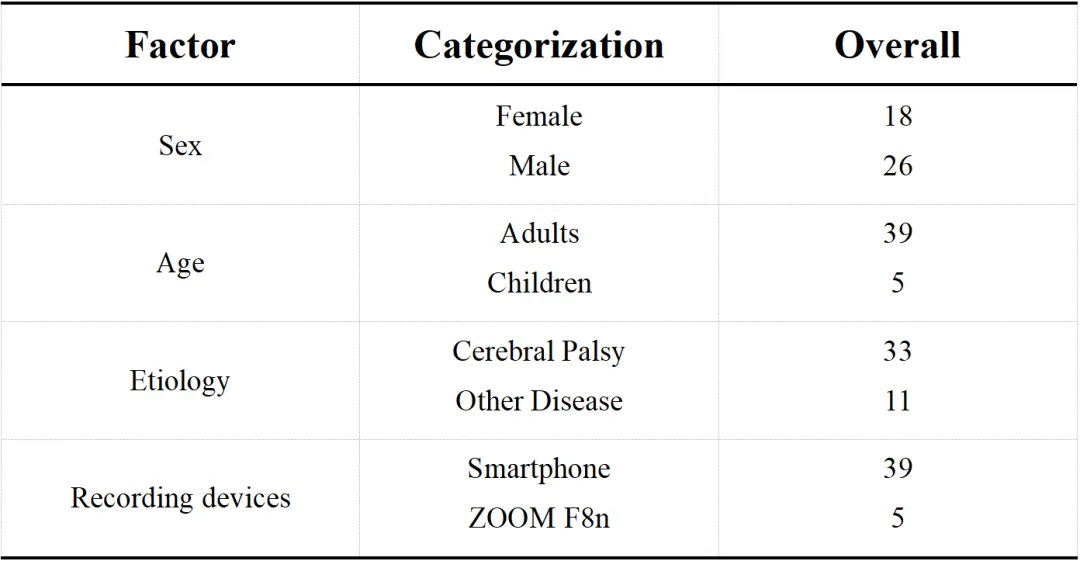
一、录音志愿者
表2:CDSD数据库录音志愿者的总体信息
二、文本池
考虑到成年与未成年录音志愿者在识字水平上的差异,CDSD数据库的文本池包括两种类型。
AISHELL-1数据库文本:涵盖语言多样性,代表日常言语,包含常用中文词汇和字符,增强了数据库的普遍性和模型鲁棒性,并已清除敏感或不当内容。
儿童文本:包括小学和中学演讲稿及童话故事,以适应儿童的阅读习惯和知识水平。
三、采集设备
为适应不同的录音场景,CDSD数据库的数据收集使用了两种录音设备。
ZOOM F8n现场录音机:部分说话者在约10平方米的录音室中使用该专业录音设备录制音频,提供高规格的音频录制质量,减少了后续数据分析中的潜在干扰。
智能手机:构音障碍录音志愿者可以在舒适的家庭环境中使用智能手机录制音频。智能手机录音有效模拟了说话者的日常语音识别任务,提高了音频数据的生态有效性,增强了语音识别模型的鲁棒性。
四、录制过程
环境要求:确保录音环境安静。
录制要求:麦克风距口部约20-40厘米。设备保持稳定,音量一致。视频录制时,面部保持屏幕中央,肩膀和嘴唇清晰可见。
基线与实验
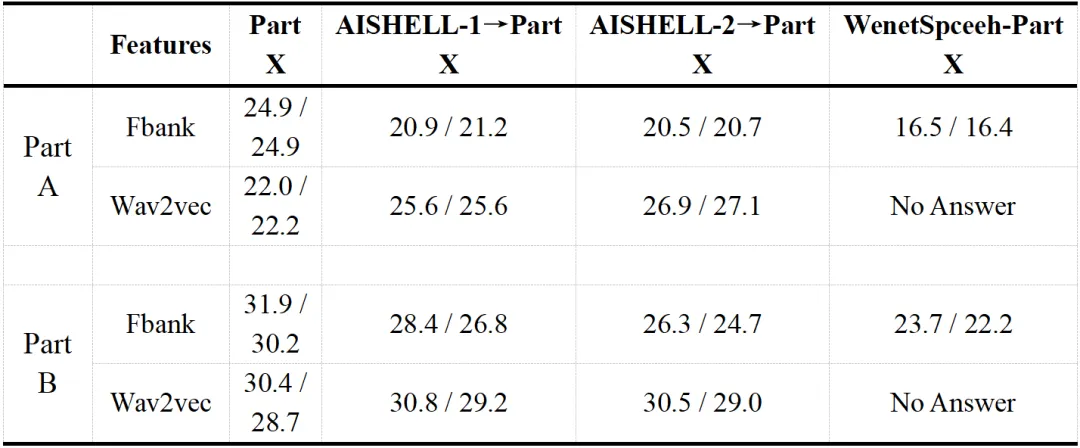
实验使用了CDSD的A部分和B部分进行评估。A部分包括44名说话者的总计44小时音频数据,B部分包含7名说话者的70小时数据。数据被分为训练集、开发集和测试集,切分比例为8:1:1。实验采用Fbank和Wav2vec特征,其中Wav2vec显著提升了DSR性能。模型基于ESPnet工具包训练,分别在CDSD和AISHELL-1、AISHELL-2、WenetSpeech等预训练数据库上进行。
结果显示,Wav2vec特征在CDSD上的直接建模效果较好,但未超越使用Fbank特征的AISHELL数据库。人机比较实验表明,有经验的参与者识别构音障碍语音的平均字符错误率(CER)为20.45%,而无经验者为35.71%。计算机的语音识别能力优于人类,体现了DSR在提升构音障碍患者社会互动中的潜力。
在表3中,A部分的平均语音识别性能优于B部分。尽管B部分的录音时长长于A部分(70小时/7名说话者对44小时/44名说话者),但A部分的说话者数量更多。这表明,在说话者数量受限的情况下,模型的泛化能力较差,无法学习更多样的语音特征。
表3:不同预训练模型下 Fbank 和 Wav2vec 的 CER。[D/T] 表示开发集(D)和测试集(T)的CER。箭头“→”表示在前述数据库上进行预训练后,再在CDSD的A或B部分上进行微调
为了探究模型在单一说话者环境下的表现,我们将B部分用于说话者依赖模型训练,使用Fbank特征,并计算了每位说话者样本的CER(开发集和测试集)。实验结果见表4。
表4:B部分中每位说话者的计算机和人工转录的CER
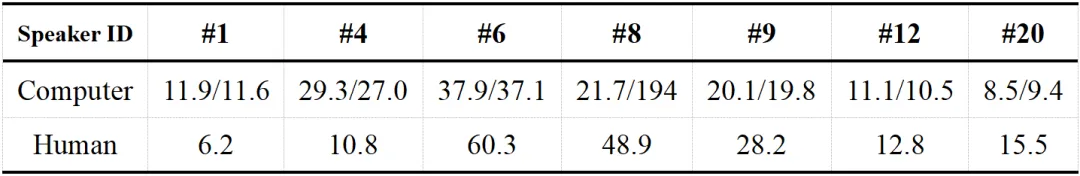
我们将计算机的DSR结果与有构音障碍交流经验的参与者的识别结果进行了比较。结果如表4所示,计算机在大多数情况下优于参与者。然而,由于构音障碍患者的语音特征差异,计算机的识别性能存在波动。长时间的停顿和音节间的不连贯增加了模型训练的难度,导致模型可能过度依赖预训练特征,从而在处理这些不规则语音时出现较高的CER。
低资源语音识别旨在用最少的数据实现最佳性能。我们比较了表4中CER最低的说话者在不同训练时长下的DSR性能。
结果如图1所示,当训练数据时长达到4小时或更多时,性能提升有限。因此,针对构音障碍说话者的语音识别微调,使用来自大规模数据集的预训练模型时,大约需要5小时的数据。这可以降低数据收集和标注的成本。
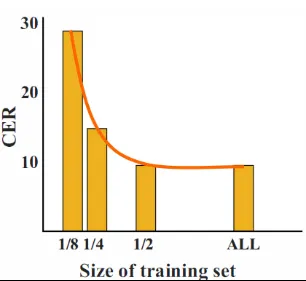
图1:确定最佳训练数据量
结论与展望
我们构建了中文构音障碍语音数据库CDSD,该数据库包含了来自44名构音障碍者的133小时数据。CDSD是目前最大的中文构音障碍语音数据库。数据在不同场景和设备下收集,以确保音频质量并更好地模拟构音障碍语音的日常使用。CDSD的构建旨在提升中文构音障碍语音识别的性能,为中国的构音障碍患者群体提供更实用的语音识别技术。
[1] J. Deller Jr, M. Liu, L. Ferrier, and P. Robichaud, “The Whitaker database of dysarthric (cerebral palsy) speech,” The Journal of the Acoustical Society of America, vol. 93, no. 6, pp. 3516–3518,1993.
[2] H. Kim, M. Hasegawa-Johnson, A. Perlman, J. Gunderson, T. S. Huang, K. Watkin, and S. Frame, “Dysarthric speech database for universal access research,” in Ninth Annual Conference of theInternational Speech Communication Association, 2008.
[3] F. Rudzicz, A. K. Namasivayam, and T. Wolff, “The TORGO database of acoustic and articulatory speech from speakers with dysarthria,” Language Resources and Evaluation, vol. 46, pp. 523–541, 2012.
[4] R. Turrisi, A. Braccia, M. Emanuele, S. Giulietti, M. Pugliatti, M. Sensi, L. Fadiga, and L. Badino, “EasyCall Corpus: A Dysarthric Speech Dataset,” in Proc. Interspeech 2021, 2021, pp. 41–45.
[5] R. L. MacDonald, P.-P. Jiang, J. Cattiau, R. Heywood, R. Cave,K. Seaver, M. A. Ladewig, J. Tobin, M. P. Brenner, P. C. Nelson et al., “Disordered speech data collection: Lessons learned at 1 million utterances from project Euphonia.” in Proc. Interspeech,2021, pp. 4833–4837.
