论文题目:C-LLM: Learn to Check Chinese Spelling Errors Character by Character
单位:新疆大学计算机科学与技术学院、清华大学电子工程系
研究背景
汉语拼写检查(Chinese Spell Checking,CSC)旨在检测和纠正句子中的拼写错误。尽管大型语言模型表现出强大的能力,并广泛应用于各种任务中,但它们在CSC上的性能往往不能令人满意。我们发现大语言模型不能满足CSC任务的汉字级约束,即句子等长和拼音相似,从而导致纠错性能出现瓶颈。进一步分析表明,这个问题源于大语言模型分词粒度,当前LLM字词混合的分词方式使得模型难以理解和满足CSC任务的字符级约束。
具体来说,字词混合的分词将CSC的字符替换任务复杂化为一种推理任务,不能清晰地建立字符之间的对应关系,这也就使得模型不能很好地理解任务的字符级长度和拼音约束。因此,建立字符间一一对应的关系十分关键。
本文方案
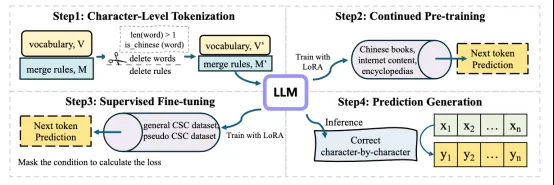
如图所示,我们构建了字符级分词,以确保分词是根据单个汉字进行编码。为了使模型适应新的词汇表,我们在大型数据集上进行持续训练。为了使LLM能够进一步学习CSC任务,还在CSC数据集上进行了有监督的微调。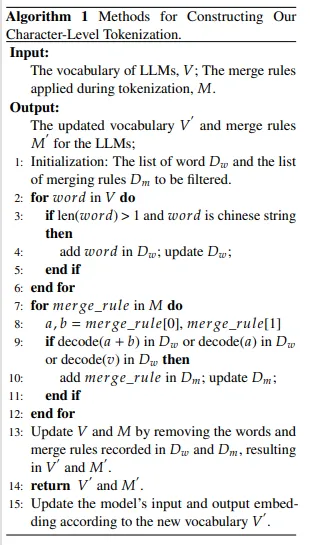
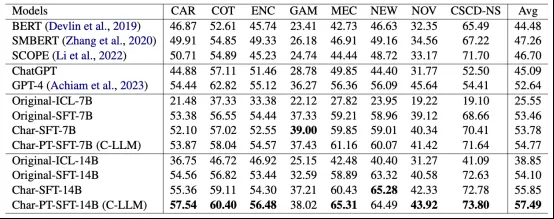
在通用数据集CSCD-NS和多领域数据集LEMON 上的实验表明,C-LLM在通用和垂直领域场景下的性能均优于现有方法,取得了最先进的性能。从上表可以得到以下结论:(1) 基于提示的模型纠错性能欠佳。即使使用GPT-4,取得的结果也不佳。然而,有监督的微调显著提高了性能,强调了其重要性。(2) 与C-LLM相比,没有持续预训练的LLM(Char-SFT)的性能有所下降,这凸显了持续预训练对更好地适应新词汇和提高性能的必要性。(3)在特定领域的数据中,新闻数据集中新闻语言的简练性质和GAM数据集中的惯用表达方式使得持续预训练的模型更容易出现错误修正。(4)原始LLM的纠错性能优于BERT类模型,表明LLM在CSC任务中比BERT类模型具有优势,特别是在垂直领域。(5)与BERT类模型和原始LLM相比,C-LLM在通用和垂直领域都表现出了优越的纠错性能,实现了最佳性能。
该文指出,LLMs未能满足CSC任务的中文字符级约束,即长度相等和语音相似,影响了其纠错性能。我们发现,根本原因在于分词的粒度,将字符和单词混合在一起,使得模型难以满足字符级约束。为了解决这个问题,我们提出了C-LLM,建立字符之间的一一映射,使模型能够学习字符对应关系和拼音相似性。该方法将CSC任务简化为字符复制和替换。实验结果表明,C-LLM在通用和垂直领域的纠错性能均优于之前的方法,达到了最先进的性能。
[1]Jinze Bai, Shuai Bai, Yunfei Chu, Zeyu Cui, Kai Dang, Xiaodong Deng, Yang Fan, Wenbin Ge, Yu Han, Fei Huang, et al. 2023. Qwen technical report. arXiv preprint arXiv:2309.16609.[2]Tom Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared D Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, et al. 2020. Language models are few-shot learners. Advances in neural information processing systems, 33:1877–1901.[3]Josh Achiam, Steven Adler, Sandhini Agarwal, Lama Ahmad, Ilge Akkaya, Florencia Leoni Aleman, Diogo Almeida, Janko Altenschmidt, Sam Altman, Shyamal Anadkat, et al. 2023. Gpt-4 technical report. arXiv preprint arXiv:2303.08774.

 语音小管家