
 语音小管家
近期,昆山杜克大学联合武汉大学、腾讯AI Lab和太原理工大学团队联合在语音旗舰期刊IEEE/ACM Transactions on Audio, Speech and Language Processing (TASLP)上发表了一篇题为“Investigating Long-Term and Short-Term Time-Varying Speaker Verification”的论文。论文通过对说话人时变数据的分析,旨在研究长期时变和短期时变对说话人验证的影响,并提出解决方案以减小时变问题带来的不利影响。
对于长期时变的说话人验证(即跨年龄说话人确认),论文通过从VoxCeleb数据集中挖掘年龄信息,提出Vox跨年龄测试集(Vox-CA)并引入了一种年龄解耦对抗学习方法,学习年龄不变的说话人表征。 对于短时间的说话人验证,论文收集了SMIIP-TimeVarying (SMIIP-TV) 数据集,该数据集包含来自373名说话人连续90天每天多个时间段的录音及其他相关元信息。利用该数据集,论文分析了说话人表征的时变性,提出了一种增量序列对说话人验证任务,并引入了基于强化学习的模板更新方法以对抗短期时变带来的负面影响。
SMIIP-TV数据资源链接:https://openslr.org/156
Trials & Code资源链接:https://github.com/qinxiaoyi/TimeVarying_ASV
论文题目:Investigating Long-Term and Short-Term Time-Varying Speaker Verification
作者列表:覃晓逸,李娜,段淑斐,李明
论文链接:https://ieeexplore.ieee.org/document/10599875
自动说话人验证(Automatic Speaker Verification, ASV),又称声纹识别,是一种通过语音信号来确认说话人身份的技术。近些年,随着深度学习的广泛应用,ASV技术取得了快速的发展,并在通用测试集上取得了令人瞩目的成绩。然而,实际应用中说话人的语音信号会因环境和自身状态的变化而发生显著波动。例如,年龄、情绪和及生理状态都会影响人的声音表现。其中人的语音特征会随时间自然变化甚至老化,这一问题被称为语音的时变问题。现实场景中,语音的时变特性可能会导致在一定时间跨度后的说话人验证系统性能下降,增加错误识别的风险。
论文主要研究了短期时变(说话人语音在几年内的变化)和长期时变(说话人语音在十几年的变化)场景。不同于传统的说话人识别单样本对打分时不考虑时间影响(如图1.a所示),本文提出两种不同的任务对解决不同的时变场景:
1.跨年龄单对说话人验证(Cross-Age Single Pair-Wise Speaker Verification):这一任务同样是单样本对打分,但考虑了时间因素的影响,重点在于选择具有显著年龄差距的正样本对(如图1.b所示)。
2.增量序列对说话人验证(Incremental Sequence-Pair Speaker Verification, ISSV):这是一种全新的针对短期时变的说话人任务,每一个样本对由一个注册模板和多个测试音频组成,这些测试音频按时间顺序与注册模板交互,并且系统可以在连续交互过程中逐步更新模板以对抗时间变化的影响(如图1.c所示)。在如图1.d中我们展示了一种embedding级别的模版更新方式流程。
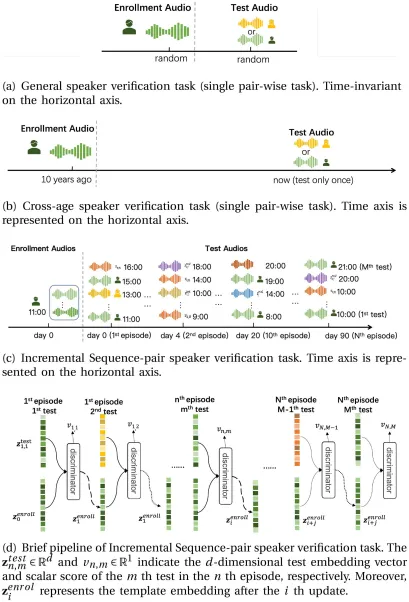
图1不同ASV任务介绍和示意图
为了解决长期时变场景下的说话人识别难点,论文通过挖掘VoxCeleb中的名人年龄信息,采用人脸年龄预测技术为音频标注年龄。最终提出Vox-CA测试集,并发布了VoxCeleb1&2对应的人脸年龄信息。
为了对抗长期时变导致的说话人类内方差增大,论文首先对说话人embedding进行分析并进行年龄组识别,得到了82%的准确率。这表明说话人embedding中含有年龄信息。基于此,如图2所示,论文提出了一种学习年龄不变的说话人表征方法——Age Decoupling Adversarial Learning(ADAL),该方法通过多任务和对抗学习的方式,将说话人embedding中的身份信息和年龄信息进行线性解耦,从而减少年龄信息对说话人任务的不利影响。
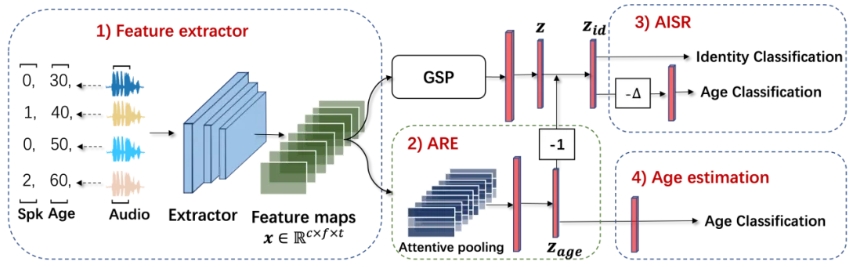
图2 ADAL框架示意图
实验结果(表1)表明,论文提出的学习年龄不变的表征的ADAL方法,不仅在Vox-E和Vox-H的通用测试集上性能没有下降,在Vox-CA测试集上有较为明显的提升,且随着年龄差距增加性能提升越为显著。
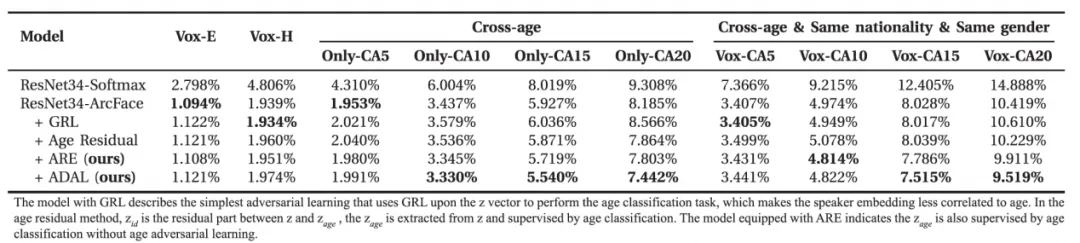
表1长期时变场景下的说话人验证系统性能
首先,为解决短期时变场景下数据不足的问题,论文采集了SMIIP-TV数据集,该数据对373名说话人进行了连续90天的数据采集,录制时间涵盖了早上6点到晚上11点并且记录了说话人录制时的身体状态、环境状态以及噪声情况。数据集中的文本内容包含文本相关和文本无关的内容。
通过增量序列对说话人验证,论文对短期时变场景下的说话人系统进行了检验。为对抗时间变化带来的负面影响,论文引入了模板更新方法,并将模板更新过程表述为一个马尔可夫决策过程,在固定权重模板更新的基础上,提出了一种基于深度强化学习(DRL)的模板更新方法,其中DRL的策略网络被视为一个代理,用来决定是否更新模板以及权重。由于传统的等错误率(EER)是一种全局评估指标,无法反映时间变化的影响,论文还提出了时延EER(TD-EER)和时延得分曲线(TDS-curve)以更好地衡量时间变化带来的影响。
首先通过观察时延得分曲线,可以发现随着时间的变化,正样本得分逐渐降低,而负样本得分基本不变。这表明随着时间的变化,正样本距离原始注册音频的相似度越来越低。
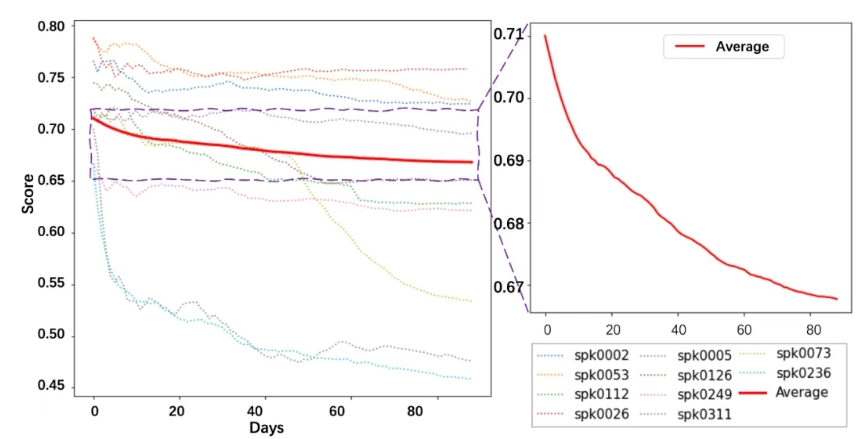
图2正样本时延得分曲线
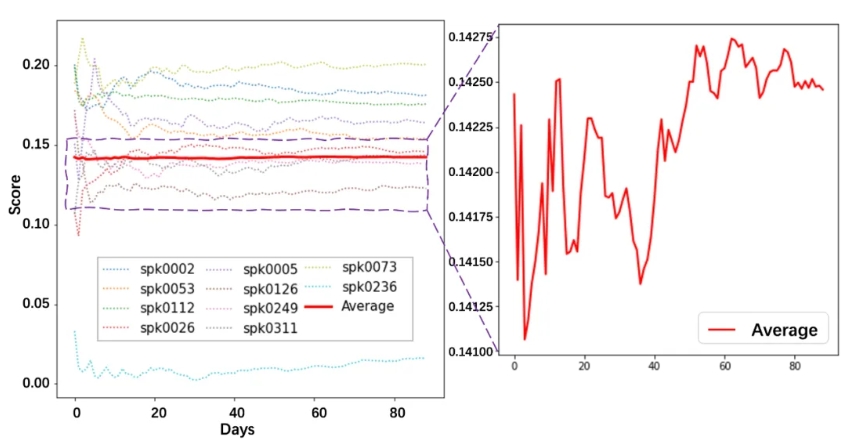
图3负样本时延得分曲线
因此论文引入了模版更新,并将该任务抽象为马尔科夫决策任务,并在固定权重的模版更新方法(FixW-TU)基础上,提出基于DRL的自适应权重的模版更新方法(DRL-TU-AdW)以及基于DRL的多头模版更新方法(DRL-TU-MH)。
固定权重模版更新公式如下所示:
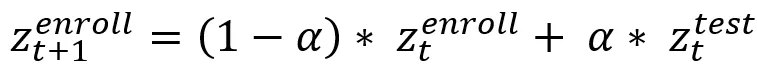
其中
基于深度学习的模板更新推理框架如图4所示,论文为此设计了一个专门的强化学习模板更新交互环境,包含状态、动作、状态转移函数和奖励函数。在该环境中,状态由模板embedding和测试embedding组成,动作为是否进行模板更新的二分类判决以及更新权重数值多少的决策。在设计奖励函数时,论文通过实验发现,当模板接近类中心时,模型的性能最佳。因此,奖励函数由以下三部分组成:1)当前模板与下一个测试音频的相似度,2)当前模板与类中心的相似度,3)更新判决是否正确。为了优化强化学习策略,论文采用了近端策略优化(PPO)算法。
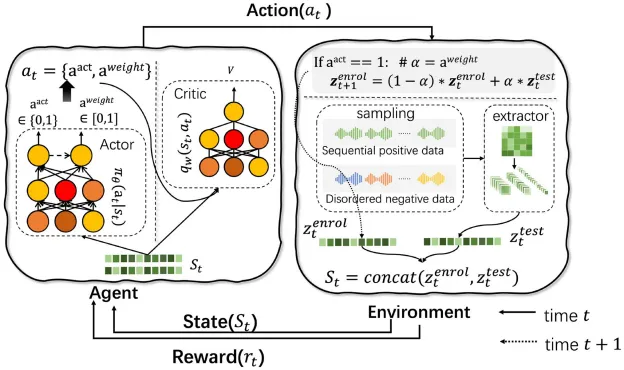
图4 基于深度强化学习的模版更新框架图
论文设计了随机场景以及定量场景进行方法的验证,表2中展示了随机场景下的短期时变说话人验证性能。可以看到相比于不进行模版更新,进行了模版更新的说话人系统有极大的提升,并且基于DRL的模版更新策略由于有更灵活的权重和更新判决,性能更优于固定权重的模版更新。
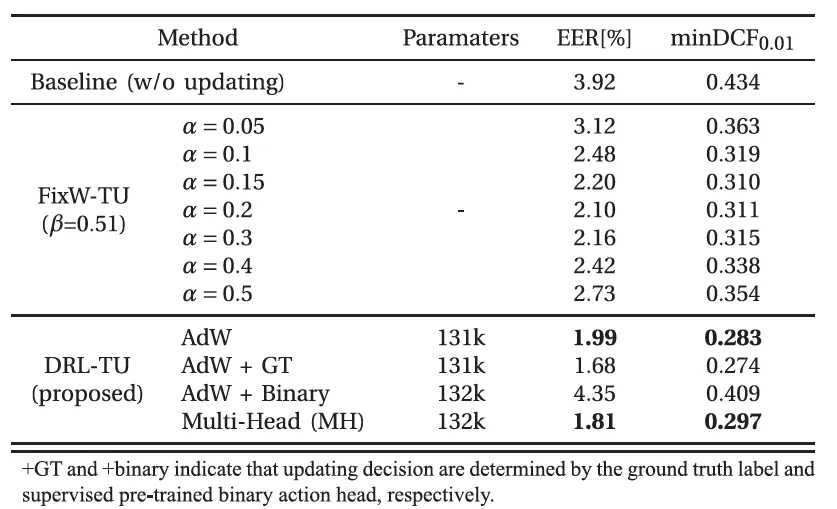
表2 随机场景下的短期时变说话人验证性能
同时通过观察图4可以发现,随着时间的增加,相比于不进行模版更新的基线系统,DRL-TU的TD-EER增幅逐渐变缓并趋于稳定(图4.a),且正样本得分也不会随着时间的变化而逐渐降低,相反由于模版更趋近于类中心而得分越来越高,正负样本得分差距越来越大(图4.b)
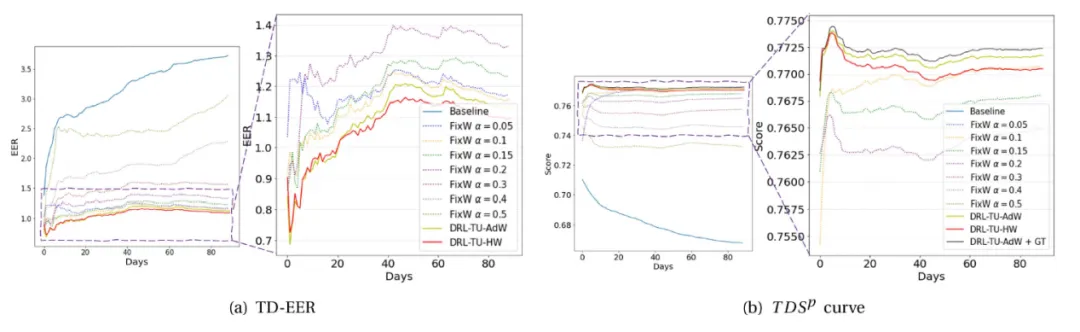
图4短期时变场景下的说话人系统性能
论文提出了新的基准和解决方案以应对长期和短期时变说话人验证的挑战。对于长期说话人验证,论文从VoxCeleb数据集中挖掘年龄信息,并引入了Vox-CA测试集作为跨年龄说话人识别的任务基准。论文提出的ADAL方法能够有效地学习年龄不变的说话人表示。对于短期说话人验证,论文引入了SMIIP-TV数据集来研究这一挑战并提出了一种增量序列对的说话人验证任务。论文通过采用模板更新方法来减轻时变的影响,将模板更新过程表述为一个马尔可夫决策过程,并建议使用基于深度强化学习的多头PPO策略方法来预测更新决策和权重。实验结果表明,DRL-TU方法显著提升了性能。论文提出的方法和发布的数据集有助于提升时变场景的鲁棒性说话人系统。
