
 语音小管家
F5-TTS是一款基于流匹配的全非自回归文本到语音转换系统,由上海交通大学、剑桥大学和吉利汽车研究院的研究团队联合开发。该系统无需复杂设计,如持续时间模型、文本编码器和音素对齐,能够实现快速训练,并达到RTF(实时因素)0.15的推理速度,明显优于当前基于扩散的TTS模型。
F5-TTS在公共的100K小时多语言数据集上进行训练,展现出高自然性和表现力的零样本能力、无缝代码切换能力和速度控制效率。项目提出了一种推理时的摇摆采样策略,显著提高了模型的性能和效率。
论文:https://arxiv.org/abs/2410.06885
模型下载:https://huggingface.co/SWivid/F5-TTS
Demo:https://huggingface.co/spaces/mrfakename/E2-F5-TTS
项目地址:https://github.com/SWivid/F5-TTS
零样本 (Zero-shot) 声音克隆 速度控制(基于总时长) 可以控制合成语音的情感表现 长文本合成 支持中文和英文多语言合成 在 10 万小时数据上训练 最重要的是支持商用
技术优势
并行处理:不像传统系统那样依赖逐步生成语音,F5-TTS 能够同时处理多个步骤,从而显著加快了生成速度。 多场景支持:无论是智能助手、在线教育、语音阅读器,还是其他需要 TTS 支持的场景,F5-TTS 都能够提供自然流畅的语音输出。 大规模数据训练:F5-TTS 在超过 100K 小时的多语言数据集上进行训练,这让它能够在不同语言和语境下提供卓越的语音生成能力。
DEMO
使用方法
1、自定义本地部署服务
本地部署,需要保证GPU资源(算力)充足及Python环境。
克隆项目
git clone https://github.com/SWivid/F5-TTS.git
cd F5-TTS
安装项目依赖包
pip install -r requirements.txt 安装合适的CUDA包(英伟达显卡必须)
pip install torch==2.3.0+cu118 --extra-index-url https://download.pytorch.org/whl/cu118
pip install torchaudio==2.3.0+cu118 --extra-index-url https://download.pytorch.org/whl/cu118
准备数据集并训练、推理、运行项目
python gradio_app.py 2、在线使用
通过官网直接体验其多语言语音生成和速度、情感控制功能。
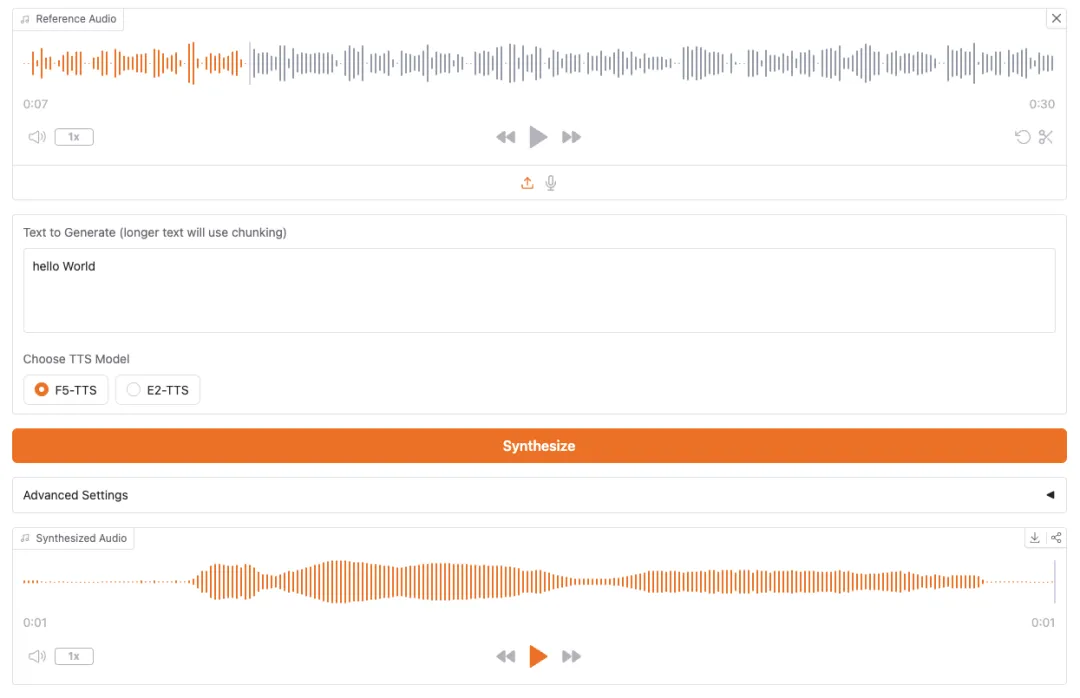
上传原始音色音频,最好是说话的音频,也可以录制自己的声音上传。
然后输入需要转成语音的文本。
同步生成,最后就可生成带预期音色的音频了。
总结
