异常声音检测(Anomalous Sound Detection,ASD)在工业环境中通过应用人工智能技术获得了显著关注。尽管具有潜力,ASD系统在实际应用中因数据收集困难和环境复杂而面临泛化问题。近期,清华大学语音与音频技术实验室(SATLab)和上海交通大学听觉认知与计算声学实验室提出了一种改进的ASD模型,使用低秩适应(Low-Rank Adaptation,LoRA)微调替代完全微调,以应对数据有限的挑战。该论文已被SLT 2024接收。X. Zheng(本科生), A. Jiang, B. Han, Y. Qian, P. Fan, J. Liu, and W.-Q. Zhang, “Improving anomalous sound detection via low-rank adaptation fine-tuning of pre-trained audio models,”2024 IEEE Spoken Language Technology Workshop (SLT 2024), to be published.
背景介绍
在工业自动化中,设备的正常运行对工厂生产至关重要,设备故障可能导致严重的经济损失。异常声音检测(ASD)是一种重要的监测手段,能够实时监测设备的运行状态,通过检测设备在运行过程中产生的异常声音来提前识别潜在故障。然而,工业设备的多样性和环境的复杂性使得ASD系统的泛化能力面临重大挑战。此外,获取充足的标注异常数据通常非常困难,导致基于深度学习的ASD模型在应用中表现不佳。因此,探索能够有效应对数据不足、提升泛化能力的模型微调技术成为了一个重要的研究方向。
工作原理
该系统由前端和后端两部分组成。前端负责对原始音频进行预处理,包括分割、加窗、增强等,生成的特征输入音频模型,提取出语义音频嵌入。在训练阶段,这些嵌入通过全连接层进行分类。在异常检测阶段,音频嵌入被传递到后端的异常检测器,以确定是否存在异常,并计算异常得分。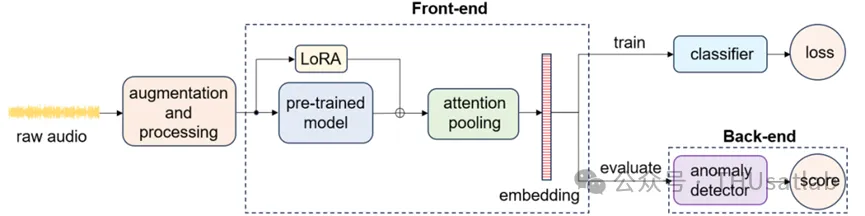
我们采用了低秩适应(LoRA)微调的微调方法。LoRA微调通过引入低秩矩阵来调整模型权重,而无需改变原始架构。该方法显著降低了微调的计算需求,同时支持增量学习,使模型在不完全重新训练的情况下适应新任务或新数据。
实验结果
在DCASE2023任务2数据集上,所提出的模型在评估集上取得了77.75%的得分,比之前的最好(SOTA)结果提升了6.48%,超越了传统的卷积网络和语音预训练模型,证明了LoRA微调在音频预训练模型中的有效性。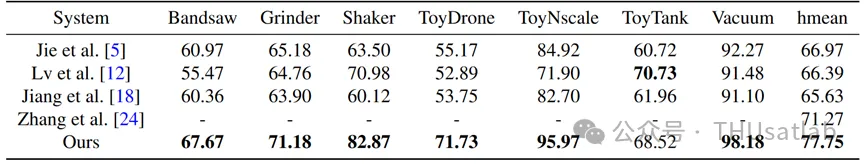
结论
本文提出了一种基于音频预训练模型的鲁棒ASD模型,该模型结合机器操作数据微调和SpecAugment数据增强,同时通过LoRA微调替代全模型微调,以解决数据不足的问题。在DCASE2023任务2的实验中,我们的方法优于传统的卷积网络和语音预训练模型,展现了LoRA微调的有效性和提升工业环境ASD应用性能的潜力。 
 语音小管家
