
 语音小管家
端到端语音到语音翻译的研究兴趣和趋势日益高涨。然而,大多数端到端模型都难以超越级联模型,即通过串联语音识别、机器翻译和文本到语音模型的层级式框架。主要挑战来自直接翻译任务的内在复杂性和数据的稀缺性。在本工作中,我们介绍了一种新颖的模型框架 TransVIP,它以级联方式利用各种数据集,并通过联合概率促进端到端推理。此外,我们还提出了两个独立的编码器,以在翻译过程中保留说话者的语音特征和源语音的等时性,使其非常适合视频配音等场景。我们在实验证明,我们的模型优于目前最先进的语音到语音翻译模型。
TransVIP: Speech to Speech Translation System with Voice and Isochrony Preservation
作者列表:Chenyang Le, Yao Qian,Dongmei Wang,Long Zhou,Shujie Liu,Xiaofei Wang,Midia Yousef,Yanmin Qian,Jinyu Li,Sheng Zhao, Michael Zeng
背景动机
方 案
(c) 等时信息。 我们的等时控制模块包含三种嵌入:常规位置嵌入、反向位置嵌入和语音活动检测(VAD)0-1 嵌入。反转位置嵌入为模型提供了时长信息,即自回归推理阶段未来需要生成的token数。VAD 0-1嵌入提供了说话的停顿信息。
这三种特征各自通过一个编码器输入到模型之中。其中语义信息和等时信息由交叉注意机制输入到自回归解码器中,而声学信息通过单个特征向量方式输入。在自回归解码中我们采用第一层语音Codec作为生成语音的离散表征,并且文本与语音连续生成。这整个架构通过语音-文本,文本-语音等多任务训练的方式进行优化。
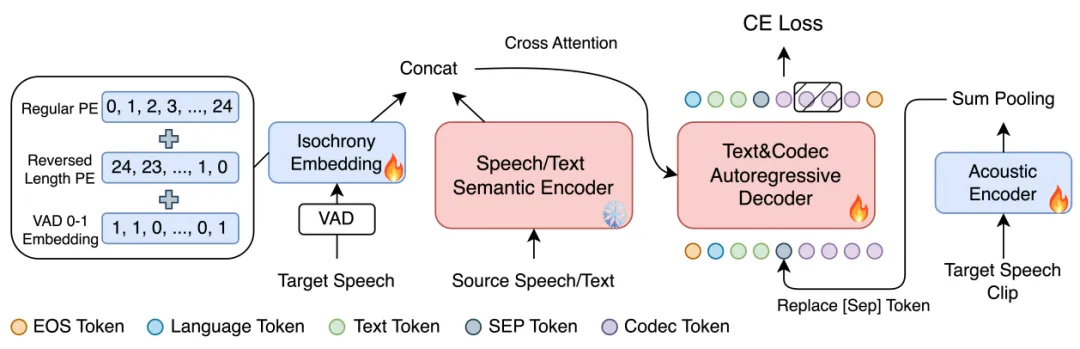
图1 TransVIP联合自回归生成框架框架图
SpeechTokenizer[1]提出将N层codec编码解耦为一层语义层和N-1层声学层以更好地契合自回归和非自回归阶段生成的特性。我们在其基础上进一步改进,加入了DAC[2]中解耦与L2正则化的量化模块。我们采用MMS[3]替代Hubert[3]作为语义teacher模型以更好适应多语种。我们将我们的codec命名为SASC(语义感知的语音codec)。
基于SASC的这些特性,其声学非自回归生成不再需要文本的介入也可以做的同样好。同时无文本介入还可以提供两项优势:1)可以有效地利用大量无标注音频数据进行训练,2)无需获得输入语音的文本,可以简化推理流程。此外我们还采用了创新的基于采样的在层level的beam search算法来改进生成质量。
实 验
1. 实验配置
2. 实验结果
我们在表(1)中显示了评估结果,并按带宽(BW)对结果进行了分组。经过语义提炼的 SpeechTokenizer 在 NISQA 分数上表现出色,能生成干净自然的语音。另一方面,DAC 在相似度和 WER 方面表现出色,显示出忠实重建原始语音的强大能力。最后,我们的 SASC 成功地结合了两种编解码器的优势,在所有四项指标上都取得了极具竞争力的结果。
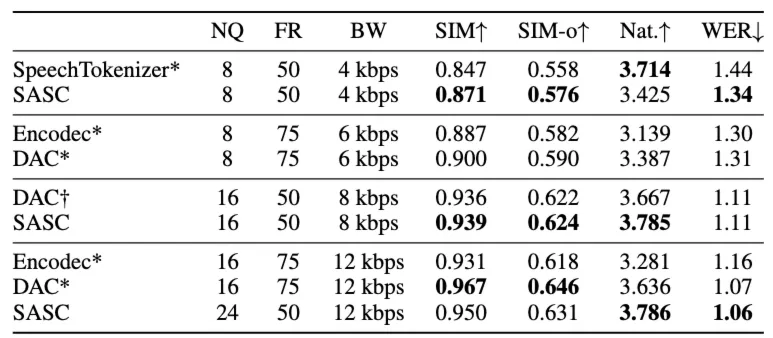
表1 SASC与其他Codec在相似带宽下的对比评估
我们将我们的的方法与ST + TTS的级联系统,无文本的S2UT方法以及Meta Seamless的两个模型(M4T Medium和Expressive)进行对比,
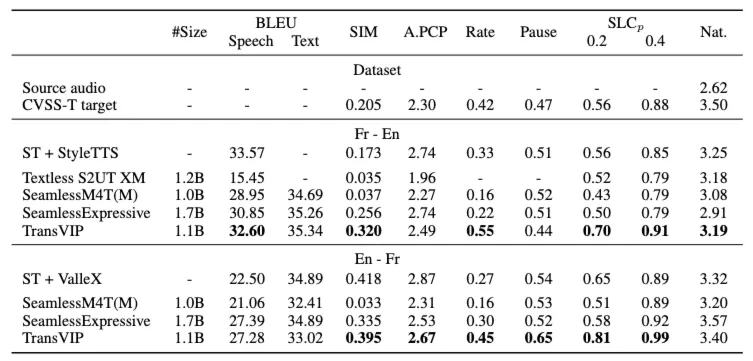
表2 端到端语音翻译评估
应用不同Codec的生成质量对比
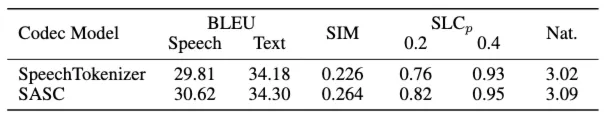
表3 使用SASC对比Speechtokenizer生成质量
总结
在本文中,我们开发了一种语音到语音的翻译框架,它能保留说话人的声音和等时性,生成高质量的翻译语音,既适用于日常交流,也适用于自动视频配音。我们的框架可以端到端方式进行推理,在推理阶段联合考虑文本和语音概率,并在训练阶段充分利用各种数据。在实验中,TransVIP 超越了当前最先进的模型,其翻译性能相当,语音和等时性保持方面也有显著改善。
参考文献
[1] X. Zhang, D. Zhang, S. Li, Y. Zhou, and X. Qiu, “SpeechTokenizer: Unified Speech Tokenizer for Speech Language Models,” in The Twelfth International Conference on Learning Representations, 2023.
[2] R. Kumar, P. Seetharaman, A. Luebs, I. Kumar, and K. Kumar, “High-Fidelity Audio Compression with Improved RVQGAN,” Advances in Neural Information Processing Systems, vol. 36, pp. 27 980–27 993, 2023.
[3] W.-N. Hsu, B. Bolte, Y.-H. H. Tsai, K. Lakhotia, R. Salakhutdinov, and A. Mohamed, “HuBERT: Self-Supervised Speech Representation Learning by Masked Prediction of Hidden Units,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 29, pp. 3451–3460, 2021.
[4] S. Communication, L. Barrault, etc, “SeamlessM4T:Massively Multilingual & Multimodal Machine Translation.” arXiv, 2023.
