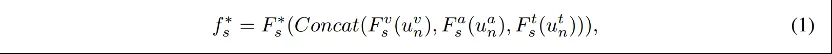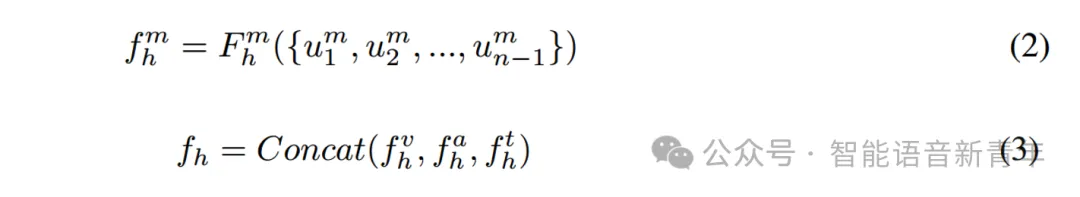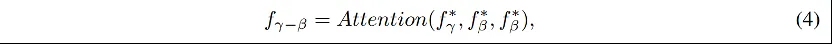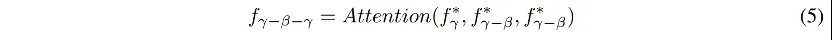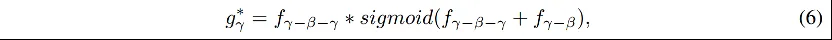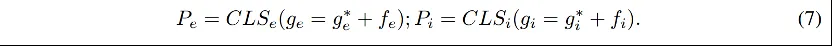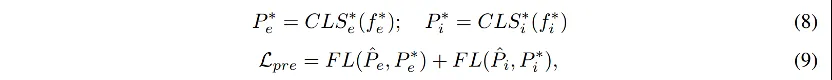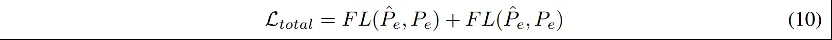本次分享由内蒙古大学刘瑞研究员与中国科学院自动化研究所助理教授连政、华南理工大学邢晓芬副教授、德国慕尼黑工业大学Björn W. Schuller教授、香港中文大学(深圳)李海洲教授合作完成的多语种多模态情感意图联合理解工作《Emotion and Intent Joint Understanding in Multimodal Conversation: A Benchmarking Dataset》。
1️⃣该工作构建了一个包含53个小时的语料的多语种多模态情感意图联合理解对话数据集MC-EIU。该数据集涉及到7种情感类别,9种意图类别,由英语和普通话两个子集组成,总计56012条语句。
2️⃣我们还通过建模多模态对话中情感和意图之间的深层相关性,开发了一个情感和意图交互网络(Emotion and Intent Interaction (EI2) network)作为参考系统。通过对比实验、消融实验,以及案例分析,我们验证了所提出的EI2方法在MC-EIU数据集上的有效性。


项目相关网址:

📍MC-EIU Paper:https://arxiv.org/abs/2407.02751
📍MC-EIU GitHub:https://github.com/AI-S2-Lab/MC-EIU-main
📍MC-EIU Dataset(Huggingface):https://huggingface.co/datasets/YulangZhuo/MC-EIU

0、Abstract

多模态对话中的情感和意图联合理解(Emotion and Intent Joint Understanding in Multimodal Conversation,MC-EIU)旨在解码多模态对话历史中表现出来的语义信息,同时推断当前话语的情感和意图。MC-EIU技术保障了人机交互的可靠性。然而,现在缺乏满足标注、模态、语言多样性和可访问性方面要求的可用数据集。在这项工作中,我们提出了一个MC-EIU数据集,其中包含7个情感类别、9个意图类别、3种模态(即文本、声学和视觉),以及两种语言(即英语和普通话)。此外,MC-EIU完全开放源代码,免费访问。据我们所知,MC-EIU 是第一个针对多模态对话的全面而丰富的情感和意图联合理解数据集。随着数据集的发布,我们还通过建模多模态对话中情感和意图之间的深层相关性,开发了一个情感和意图交互(Emotion and Intent Interactio,EI2)网络作为参考系统。通过对比实验和消融研究,我们验证了所提出的EI2方法在MC-EIU数据集上的有效性。


1、Introduction

多模态对话中的情感和意图联合理解(MC-EIU)旨在通过对多模态对话之间的语义依赖进行建模,同时推断出情感状态和意图信息。与情感或意图识别的单独任务不同,MC-EIU任务提供了更丰富的信息,以帮助机器更好地理解人类的需求,并提高人机对话中的同理心。它在各种人机交互场景中具有巨大的应用潜力,包括呼叫中心对话系统、会话代理和心理健康咨询等。
MC-EIU任务具有挑战性,涉及两个关键问题:1)建模多模态上下文信息,2)建模情感和意图之间的相互作用。为了支持这样的研究,以前的研究人员在数据集和方法方面都做了大量的工作。1)在数据集方面,提出了多个数据集来标注人类对话视频片段的情感或意图标签。然而,在标注、模态、语言多样性和可访问性方面缺乏可用的数据集。例如,IEMOCAP[10]、MEISD[11]、MELD[12]、30和M3ED[13]数据集分别用5、8和7个情感类别标注多模态对话数据。然而,它们的标注多样性有限,因为它们只提供了情感标签,缺乏意图标签。OSED[14]是一个开源数据集,包含32种情感和9种意图。然而,它在模态和语言多样性方面是有限的,因为它只由英语文本数据组成。虽然EmoInt-MD[1]与MC-EIU任务非常一致,但它只提供英语数据,缺乏语言多样性。另外,EmoInt-MD提供的用于访问数据的开源地址不可用。2)在方法上,一些工作利用最先进的网络架构来构建多任务框架,用于情感和意图的联合识别。具体来说,EmoInt-Trans[1]只是利用相邻话语的嵌入来增强对当前话语的表征,然后采用带有两个投影头的Transformer来预测情感和意图标签。这种方法忽略了多模态对话历史中复杂的依赖关系,以及情感和意图信息之间的深度交互,而这些在多模态对话理解中是至关重要的[6]。
本文提出了同时满足标注、模态、语言多样性和可访问性四个属性的MC-EIU数据集,以支持MC-EIU任务的研究。该数据集由3部英文电视剧和4部中文电视剧的4,970个对话视频片段组成,提供了与现实世界密切相关的对话场景。它包括对7种情感和9种意图的标注,包括文本、声学和视觉模态,共有45,009条英语话语和11,003条普通话话语。重要的是,它是完全开源的,允许访问。据我们所知,该数据集是第一个面向多模态对话的全面而丰富的情感和意图联合理解数据集,可以促进英汉语言情感计算的研究。
此外,我们还开发了一个情感和意图交互(EI2)框架作为参考系统,在考虑多模态对话上下文的情况下,对多模态对话中情感和意图之间至关重要的深层相关性进行建模。具体来说,我们设计了一个多模态历史编码器来充分建模对话历史。然后,我们将对话历史特征与当前话语的情感和意图特征进行彻底整合。最后,我们提出了一个情感-意图交互编码器来学习情感和意图之间复杂的交互关系。
综上所述,本工作的主要贡献如下:
1、我们构建了第一个全面而丰富的多模态对话情感和意图联合理解数据集,称为MC-EIU,该数据集满足四个属性:标注、模态、语言多样性和可访问性。它可以促进情感计算和人机交互的研究。
2、我们进一步提出了MC-EIU任务的伴随系统,即情感和意图交互(EI2)框架。它包括建模多模态对话历史和深层情感意图交互。
3、对比实验结果表明,我们的EI2超过了我们基准数据集上所有先进的基线。消融和案例研究进一步验证了我们的EI2的有效性。


2、Related Works

2.1、Related Dataset

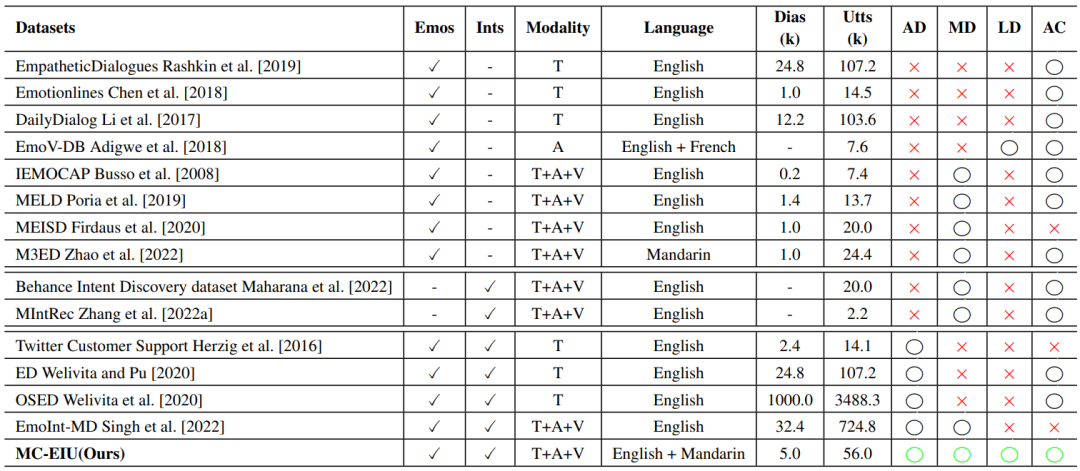
表1提供了与我们的工作相关的一些最重要数据集的概述和总结。为了突出MC-EIU数据集的重要性,我们基于标注、模态、语言多样性和可访问性对多个数据集进行了详细的比较.


标注多样性:EmpatheticDialogues[15]、EmotionLines[16]、DailyDialog[17]、EmoV- db[18]、IEMOCAP、MELD、MEISD和M3ED被广泛用于情感识别,但是这些数据集主要关注情感标签,缺乏标注多样性,因为它们不包括意图标签。同样,Behance Intent Discovery数据集[19]和MIntRec[4]在标注多样性方面受到限制,因为它们仅用于意图识别,而不提供情感标签。相比之下,Twitter Customer Support[20]、ED [21]、OSED和EmoInt-MD包含了同时包含情感和意图标签的优势。
模态多样性:EmpatheticDialogues、EmotionLines、DailyDialog、Twitter Customer Support [20]、ED[21]和OSED提供了大量的对话文本数据。EmoV-DB是用5种情感类别的语音数据构建的。然而,这些数据集仅提供单一模态的信息,而不包括多个模态。因此,缺乏对多模态的支持限制了这些数据集的模态多样性。与它们不同的是,IEMOCAP、MELD、MEISD、M3ED、Behance Intent Discovery Dataset[19]、MIntRec[4]和EmoInt-MD提供了更广泛的模态,包括文本、声学和视觉数据。
语言多样性:表1中大部分数据集主要由英文数据组成,而M3ED数据集仅由中文数据组成。因此,这些数据集在语言多样性方面表现出局限性。只有EmoV-DB脱颖而出,因为它同时包含英语和法语数据。
可访问性:表1中列出的所有数据集都是可访问的,除了MEISD和Twitter。值得一提的是,EmoInt-MD中提供的开源地址的数据集目前是不可用的,这给访问数据带来了挑战。
简而言之,MC-EIU任务的上述四个方面缺乏可用的数据。我们的数据集填补了这些空白,并提供了满足所有四个方面的数据。


2.2、Related Method

多任务预测:多任务学习旨在利用多个相关任务中的有价值信息来提高所有任务的泛化性能[22],在情感识别[23]、对象检测[24]、对话语音合成[25]等领域有着广泛的应用。多任务学习方法大致可分为硬参数共享(Hard Parameter Sharing, HPS)和软参数共享(Soft Parameter Sharing, SPS)[26,27]。HPS作为基础深度神经网络,在不同的任务之间共享,而每个任务使用自己独特的顶层[26,23]。SPS允许模型在不同任务之间共享一些参数,同时保留特定于任务的参数[27]。
需要注意的是,与HPS相比,SPS的优势在于网络能够通过共享底层参数来利用不同任务之间的共享特征。它允许更好地利用任务之间的交互信息。
情感-意图交互作用:前人的研究证实了情感和意图之间存在很强的交互作用[21,14,1,6]。例如,[1]强调说话者的情感会受到对话中特定意图的影响。为了探索情感和意向之间的相互作用,他们建立了遵循HPS框架的EmoInt-Trans模型。它使用MISA网络[23]作为主干,其中情感和意图预测任务共享该主干的所有参数。然而,情感和意图之间的复杂关系给HPS带来了挑战,因为它可能难以适应每个任务的不同特征。请注意,我们的EI2模型和EmoInt-Trans之间最大的区别在于,我们采用了SPS方法来学习情感和意图的深层次交互信息。


3、MC-EIU Dataset Construction

3.1、Data Collection

为了模拟真实情境中的情感对话场景,我们从3部英语(716集)电视剧和4部中文(119集)电视剧中选取了情感视频片段,涵盖了家庭、爱情、犯罪等类型。所有视频都配有相应的字幕文件。然后,我们对数据进行预处理以获得所需的格式,并过滤掉不符合标准的低质量数据。具体来说,
1)我们首先设计正则表达式脚本,从字幕中提取文本转录和时间戳;
2)然后,我们利用VideoFileClip根据时间戳将视频划分为多个剪辑;
3)最后,我们让群众工作者从相同的对话场景中挑选出高质量的对话片段。
请注意,根据Zhao等人的相关工作,我们为志愿者提供了以下具体指导方针:a)对话场景应该只涉及两个说话者之间的互动;b)所选的对话场景应没有噪音或特效声音,以确保视频质量不受影响;c)每个对话片段应至少包含两轮说话者之间的互动,以提供丰富的语境信息;d)文字内容要准确,并与视频剪辑对齐。


3.2、Data Annotation

标注方案:标注方案包括情感标注、意图标注和说话人标注。对于情感标注,我们选择Ekman的六种基本情感(快乐、惊讶、悲伤、厌恶、愤怒和恐惧)以及中性标签,这是前人工作中广泛使用的一种7情感标注方案。对于意图标注,我们根据9个意图对每句话进行标注:质疑、同意、承认、同情、鼓励、安慰、建议、希望和中立。对于说话人标注,我们为每个对话分配标签“0”和“1”来标注说话人。
我们从外国语学院招收研究生担任项目标注员。在开始标注过程之前,所有标注人员都要经过培训和评估阶段。只有获得及格分数的人才会被选中进入数据标注阶段。未达到合格标准的标注员需要接受额外的培训和重新评估,直到成功通过评估。
标注过程:我们招募了21名标注者,并将他们分为7组。每组由3名志愿者组成,将不重复的数据分配给每组进行标注。这确保了每个对话数据都由三个志愿者标注。每个标注者都可以访问多模态对话中的当前话语和历史,包括标注过程中的文本、音频和视频剪辑。要求标注者在观看完视频片段后,从标注方案中选择合适的情感和意图标签。同时,要求标注者根据说话顺序为对话中的每个话语分配说话人标签。假设标注者在为视频片段分配特定类别时遇到困难。在这种情况下,他们将话语分类为其他,并且包含该话语的整段对话将从我们的数据集中剔除。


3.3、Data Annotation Finalization

我们对所有话语标注采用多数投票策略来获得最终的情感和意图标签。如果至少有两个标注员为一个话语提供相同的标注,则将其视为最终标签。如果所有三个标注者都有不同的标注,则咨询额外的情感专家以确认最终标签。


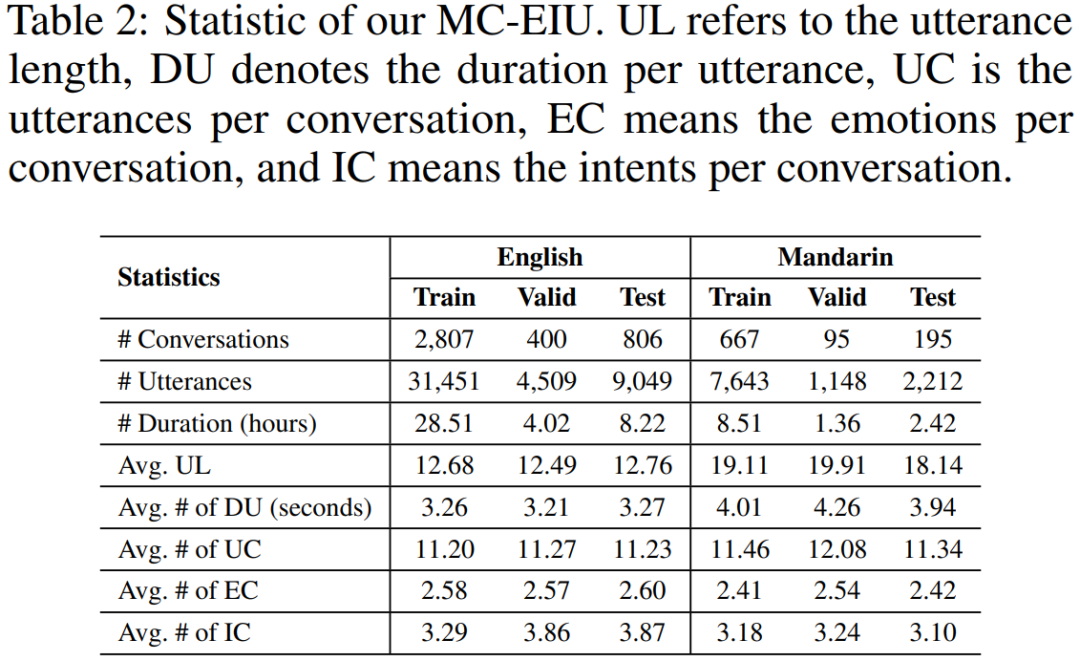
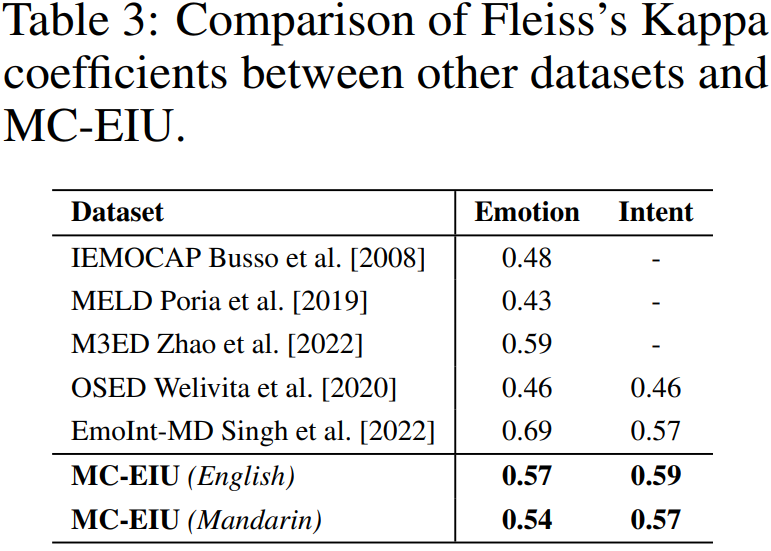
MC-EIU数据集的统计数据如表2所示。它共有56012个话语,包括4013个英语对话和957个普通话对话。MC-EIU数据集的总时长为53.06小时。我们将数据集划分为训练集、验证集和测试集,比例为7:1:2。为了评估数据标注的可靠性,我们分别计算了Fleiss等[2013]对情感和意图标注的Kappa (κ),如表3所示。注意,我们数据集的κ值要高于或等于与以往的研究,这有力地证明了我们标注的可靠性和准确性。


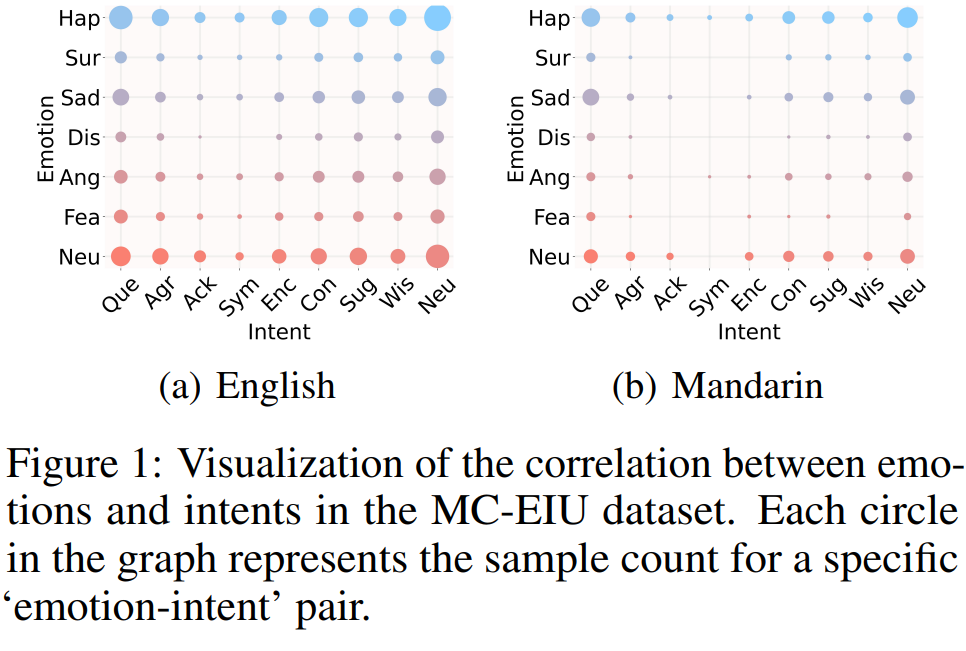
我们进一步探讨了情感和意图之间的相关性。我们创建了两个7x9的二维矩阵,每个元素表示数据集中每个“emotion - intent”对的样本数量。使用样本数量作为半径,我们在相应的矩阵位置绘制圆点。可视化结果如图1所示。圆圈越大,表示样本越多,相关性越高。可以看出,情感和意图并不是严格一对一的对应关系,不同的意图对特定情感的影响是不同的,反之亦然。


以图1 (a)为例,与“Hap-Sym”相比,“Hap-Agr”出现的频率更高,说明“agree”更有可能驱动“Happy”的表达。同样,与“disi - que”相比,“Sad- que”的出现率更高,这表明“Questioning”与“Sad”的联系比“Disgust”更紧密。此外,我们观察到,与汉语数据集相比,英语数据集中情感和意图之间的相关性更为复杂。例如,情感“Sur”与英语数据集中的所有意图类别相关联,而在普通话数据集中,它仅与6个意图类别(“Que”,“Agr”,“Con”,“Sug”,“Wis”和“new”)相关联。这种复杂的关系给MC-EIU任务带来了重大挑战。


4、Emotion-Intent Interaction(EI2)Network

4.1、Overall Architecture
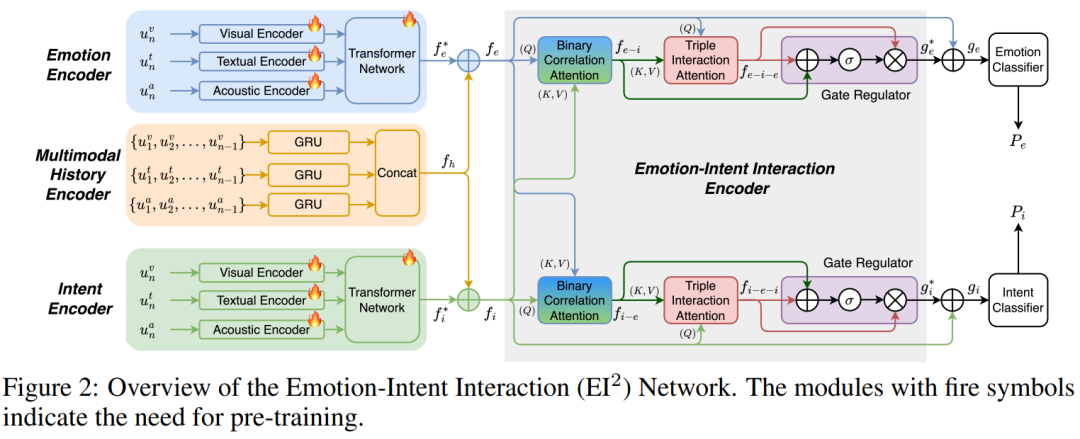

为了对多模态对话历史以及情感和意图之间的深层次交互进行建模,我们提出了一个EI2网络,如图2所示。该网络由以下部分组成:1)情感和意图编码器旨在生成当前话语的多模态情感和意图表示;2)多模态历史编码器负责从多模态历史中捕获多模态上下文语义信息;3)提出了情感-意图交互编码器(Emotion-Intent Interaction Encoder),学习对话中情感与意图之间的深度交互;4)情感与意图分类器旨在基于情感-意图交互信息进行预测。
情感和意图编码器:我们为情感和意图理解添加了单独的特征编码器,以提取更明确的情感和意图特征。情感和意图编码器具有相似的结构,其中包括视觉编码器、文本编码器、声学编码器和Transformer融合网络。多模态情感/意图表示可以表示为:

值得注意的是,图2中带有火焰符号的模块表明需要对我们的意图和情感编码器进行预训练。进一步的细节将在第4.2节中提供。
多模态历史编码器:与EmoInt-Trans(Singh等人[2022])单独建模相邻话语的上下文信息不同,我们的多模态历史编码器考虑了更广泛的历史信息。对于当前话语,多模态对话历史信息可以表示为:

情感-意图交互编码器:简单地共享隐藏状态的方法不足以实现两个任务之间显式的信息传递。因此,我们提出了情感-意图交互编码器,通过考虑它们之间的复杂相关性来学习它们之间的深层交互信息。如图2所示,情感-意图交互编码器包含两个用于情感或意图预测的分支,其中每个分支由二元相关注意、三重交互注意和门调节器组成。
二元相关注意:首先通过交叉注意来学习情感和意图之间的相互影响,这也可以称为两个任务之间的二元相关。二元相关注意可表示为:

三元交互注意:通过整合各分支的二元相关性和特定任务信息,进一步挖掘两个任务之间的深层交互信息,获得更全面、更深入的任务交互特征:

Gate Regulator:利用门控机制自动学习二元相关特征和三元交互特征的权重,模拟图1中不同情感意图对之间的相关性对交互特征的潜在影响。这允许我们调整二元相关性对情感或意图的最终识别的贡献。

通过这三个组件的协作,我们的EI2模型捕获了情感和行为之间的深层次交互。
情感和意图分类器:为了在融合深度交互信息的同时保留情感和意图表征的特定信息,我们将门调节器的输出与情感特征和意图特征分别结合起来,再进行最终预测。最后,情感分类器和意图分类器利用残差连接的结果分别预测最终的情感和意图类别:


4.2、Training Strategy

我们首先对情感和意图编码器进行预训练,确保情感和意图信息的有效提取。鉴于数据集中存在类别失衡,我们在预训练阶段采用Focal Loss (FL)作为损失函数,以约束情感和意图的预测接近于情感和意图的真值,并提高模型关注小样本类别的能力:

在EI2的训练阶段,我们用预训练的权重初始化情感和意图编码器。这些编码器然后在EI2培训期间进一步更新。最后,我们采用联合训练的方法,并将FL损失作为MC-EIU任务的最终损失函数。


5、Experiment and Analysis

5.1、Main Results
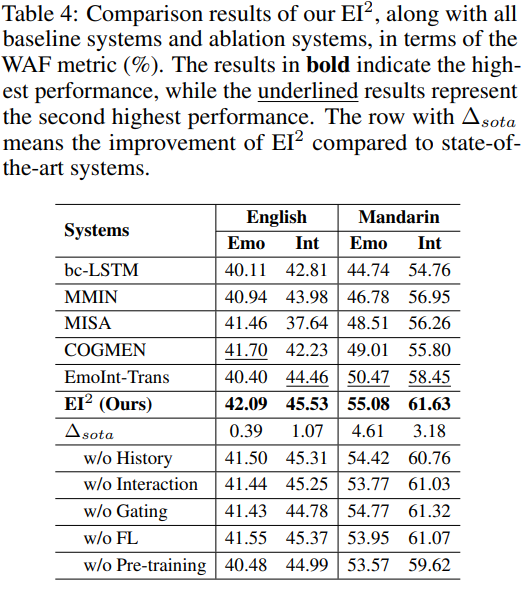
我们首先比较了EI2和基线系统在英语和普通话上的识别性能。如表4所示,我们观察到EI2在两种语言的情感和意图识别中都达到了最高的WAF,明显优于基线系统。例如,英语EI2的情感和意图WAF分别为42.09%和45.53%。在普通话中,情感得分为55.08%,意图得分为61.63%。这些结果证明了我们方法的有效性。通过对多模态对话历史的学习,利用软参数共享来捕捉情感和意图之间的交互,我们的模型实现了对情感和意图的联合识别。


5.2、Ablation Study

我们设计了模块消融、任务消融和模态消融三种不同的消融实验,以进一步验证EI2系统的组件。
模块消融:我们对多模态历史编码器、情感-意图交互编码器、门调节器以及情感-意图编码器的预训练策略进行了消融实验:1)w/o History:我们去除EI2的多模态历史编码器;2) w/o Interaction:直接使用情感和意图编码器输出的特征进行最终预测;3) w/o Gating:我们移除门调节器;4) w/o FL:我们将4.2节中提到的Focal Loss替换为Cross-Entropy Loss;5)w/o Pre-training:我们在EI2训练时随机初始化情感和意图编码器的参数。
如表4所示,EI2在两个数据集上都优于所有消融模型。这为以下断言提供了令人信服的证据:1)引入对话历史有助于分析当前说话人的情感和意图状态;2)通过对深层交互信息的建模和集成,提高了联合理解任务的性能,进一步证明了对意图和情感之间的交互信息进行建模对于联合理解的重要性;3)减少门控机制后,模型的性能显著下降,突出了门控调节器在调整二值相关权重以最终识别情感或意图方面的关键作用;4)情感和意图编码器的预训练结果显著提高,表明他们能够通过预训练学习到大量的语义信息和明显的情感和意图特征。
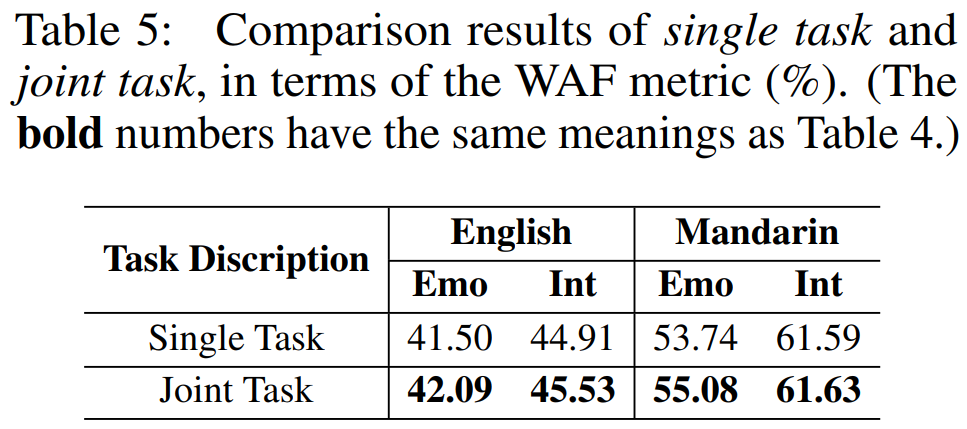
任务消融:为了进一步研究联合识别任务的有效性,我们在MC-EIU数据集上进行了独立的情感和意图识别任务。这些单独任务的结果如表5所示。


我们可以观察到,联合任务的识别效果优于单个任务。这进一步证实了意图和情感之间的强相关性,联合任务可以通过情感和意图之间的深度交互来提高预测的准确性。
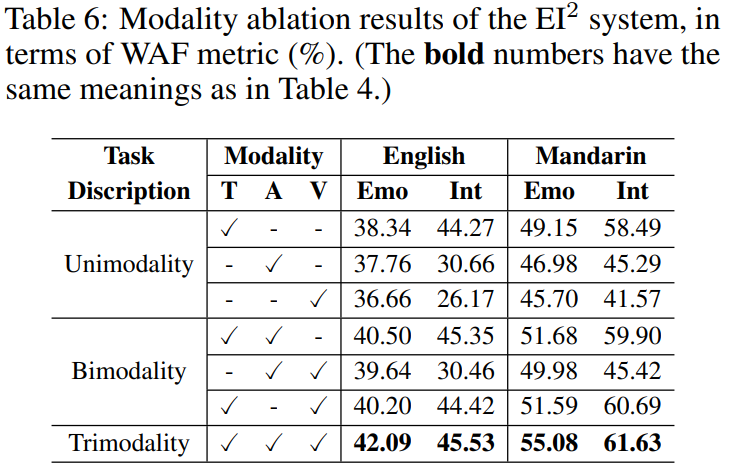
模态消融:我们进行了模态消融实验来验证不同模态数据的影响,如表6所示。


在单模态实验中,我们发现文本模态表现出最高的综合性能,而视觉模态表现最差。这与Fu等人先前的研究一致,他们认为文本模态包含了最全面的语义信息,而视觉模态在这方面相对有限。此外,模型的性能随着融合模态数量的增长而提高,当所有三种模态相结合时,实现了最高的性能。这突出了整合来自不同模态的互补信息的有效性。


6、Conclusion

这项工作引入了一个新的数据集,称为多模态对话情感和意图数据集(MC-EIU),它具有几个关键属性:标注多样性(包括情感和意图标签),模态多样性(包括文本,声学和视觉数据),语言多样性(包括英语和普通话数据),以及可访问性。此外,针对MC-EIU任务,我们提出了一个情感和意图交互(EI2)网络,该网络有效地捕获了情感和意图之间的对话历史和复杂交互。在我们的数据集上进行的大量实验证明了我们的EI2的有效性,展示了其优越的性能。我们的工作致力于推进情感计算领域的发展。