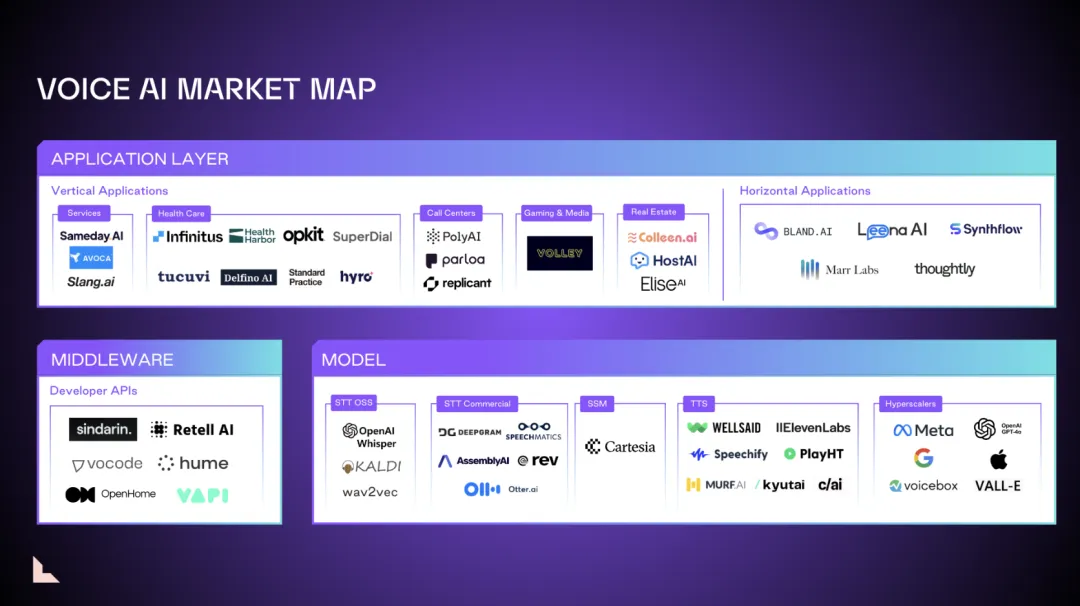
语音小管家
核心要点:
语音技术的演变:语音技术从 1970 年代的「交互式语音应答」(IVR)系统发展到现代智能语音电话树,再到如今的 LLM 系统,用户体验不断提升。
市场机遇:目前 IVR 系统市场价值 60 亿美元,未来语音应用市场有望增长四倍,特别是在医疗和酒店等垂直行业。
语音 AI 的现状:语音 AI 依赖于语音转文本(STT)、文本到文本(TTT)和文本到语音(TTS)三种基本架构;两类主要模型:扩散模型(适用于异步编辑和有声书等)和自回归模型(适用于实时对话和翻译)。
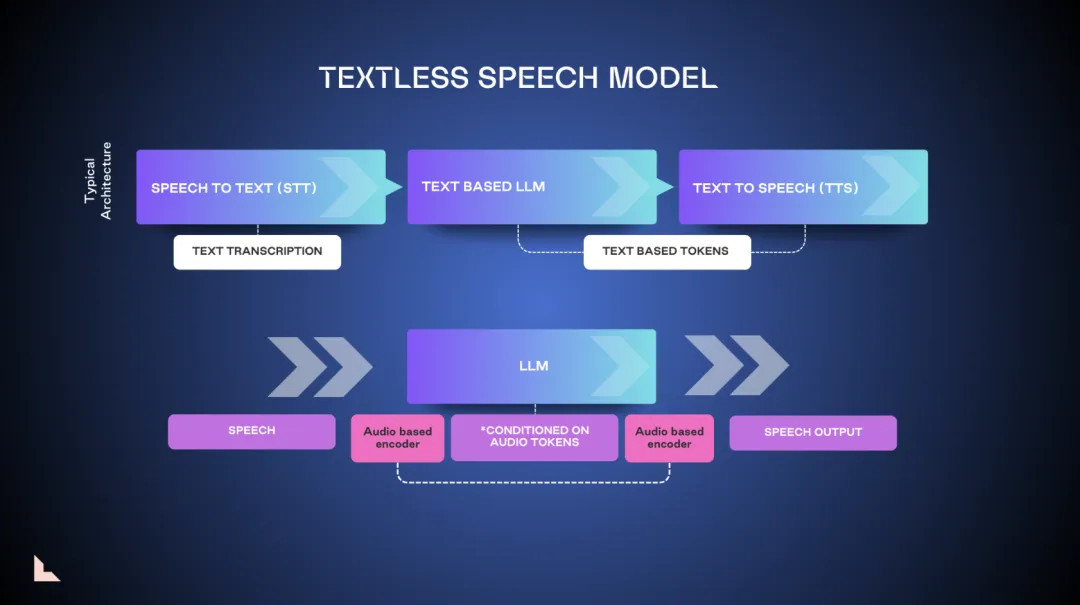
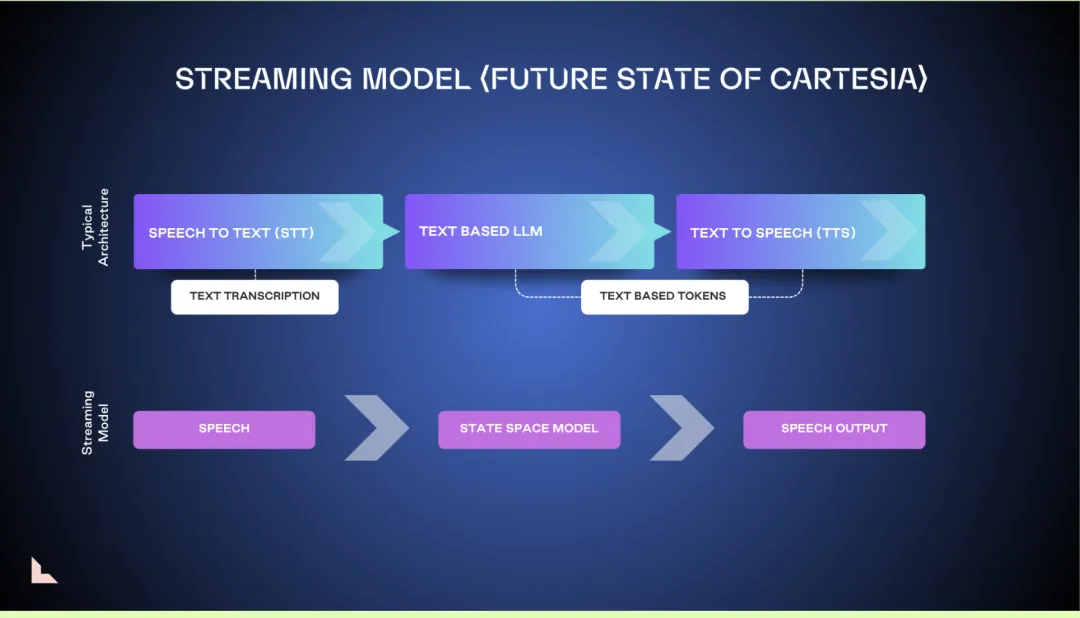
下一代语音 AI 模型:潜在声学表示(LAR)、tokenized 语音模型、无文本语音模型、流式传输模型。
文章认为语音 AI 初创公司在确定市场定位之前,需要先克服三个关键挑战:1.无缝人机协同:智能识别 AI 局限性,并在必要时无缝切换至人工客服,确保流畅的用户体验。2.性能与成本平衡:实现低延迟、高性能的语音 AI 交互,同时控制计算和数据成本。自主搭建应用通常比全栈式解决方案更具成本效益。3.垂直领域优先:专注于医疗或金融等垂直领域的应用,解决实际业务问题,比构建通用模型更易获得早期成功。
语音的未来:语音如何改变对话式 AI
作者:Lisa Han
商业语音应用的演变
过去 50 年间,商业语音应用领域经历了翻天覆地的变化。1970 年代,首个交互式语音响应(IVR)系统问世,那时用户只能通过键盘输入来响应语音提示进行操作。然而,在过去的二十年间,这种传统的按键导航逐渐被更先进的智能语音电话树取代,客户现在可以用自然语言下达指令,而不再局限于按键选择。
如今,我们正迈入一个全新的时代——基于大规模语言模型(LLM)的系统,它们让用户与软件的互动不再是单向的对话,而是双向的交流。这些系统能够像人类一样理解语言的微妙之处和对话的上下文。
语音 AI 的机遇
目前,仅交互式语音响应(IVR)系统的市场价值就高达 60 亿美元,这还不包括更广泛的语音应用领域,如音频书籍、播客、翻译、配音、游戏和陪伴应用等。我们相信,随着人工智能技术在延迟、音调和响应能力上的不断进步,语音应用市场的规模有望增长至四倍。
在短期内,最成功的语音技术公司将专注于医疗、酒店等垂直行业的应用,以及那些设计用于处理简单任务(比如日程安排)的应用。然而,这些新兴的语音应用最终将融入更广泛的 SaaS 平台,从而显著扩大可服务的市场范围。
像 ChatGPT 4o 这样的多模态聊天机器人,不仅能帮助组织与用户建立更紧密、更个性化的联系,还能收集语气、意图和情绪状态等信息。利用这些数据,企业可以改进服务并推动新产品的开发。
语音 AI 的现状
语音转文本(STT)输入:捕捉口语并将其转为文本。 文本到文本(TTT)推理:利用 LLM 对文本转录进行 tokenized 并形成书面响应。 文本到语音(TTS)生成:将书面响应转为口语。
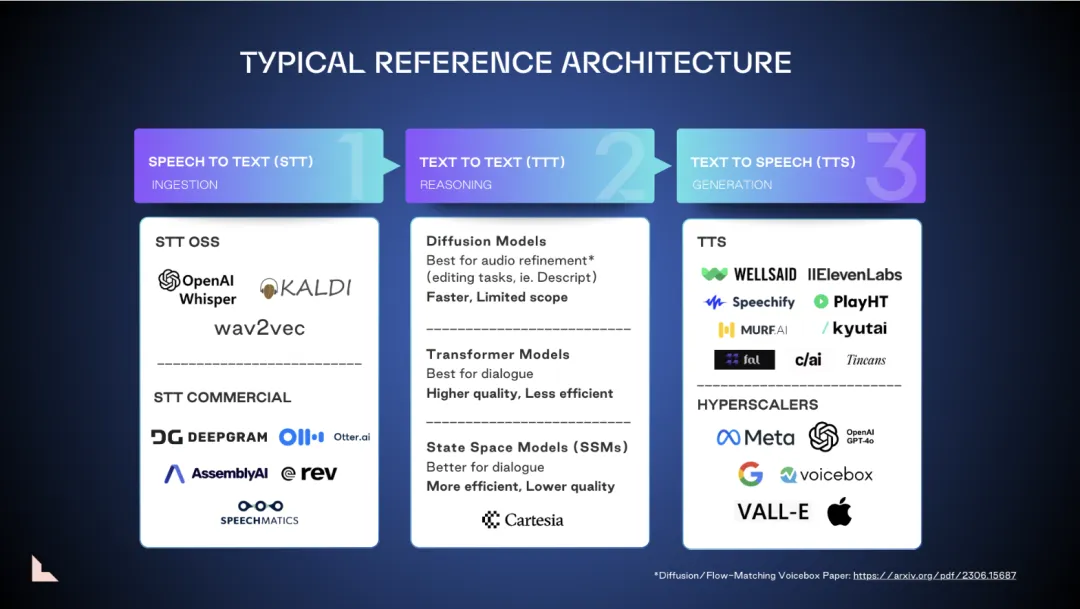
类别 1:扩散模型(Diffusion Models)
扩散模型是一种生成建模方法,可以利用 Transformer 或状态空间模型(SSM)作为模型架构。它们通过逐步向神经网络的训练数据集引入噪声,然后教会模型如何逆转这一过程。虽然扩散模型有时可以利用 Transformer 组件来解释文本输入并生成图像、音频或视频等输出,但其生成过程本质上还是基于扩散机制。这些模型生成速度快,但功能相对有限,它们最适合异步编辑(例如 Descript)和有声书、播客等应用。由于扩散模型缺乏推理能力,通常被视为「点缀」,需要与其他模型结合使用才能发挥更大的作用。
类别 2:自回归模型(Autoregressive Models),如 Transformer 和状态空间模型(State Space Model,简称 SSM)
Transformer 模型通过记住一系列输入并将其转换为所需输出来工作。它们最适合需要细微对话能力的场景,如一对一对话或语言翻译。这些模型提供更高质量的输出,但需要更多的内存和系统资源。
状态空间模型(SSM)则根据对话中的当前状态和最近的历史来做出响应。这使得它们比内存密集型的 Transformer 模型运行更快、成本更低。SSM 还具有更低的延迟和更自然的语音再现能力,并且能够处理比 Transformer 更长的上下文序列(尽管目前还不确定它们是否能够充分利用整个序列以高质量方式输出)。虽然 SSM 需要的内存比 Transformer 少,但真正的挑战在于如何利用其扩展的序列处理能力来实现高质量的输出。
在文本到文本、文本到语音和语音到语音技术方面,已经取得了显著的进展。像 Cartesia 和 Kyutai 这样的公司在状态空间模型和开源解决方案方面取得了重大突破。同时,Meta 的 Voicebox 和 OpenAI 的 ChatGPT 4o 等行业巨头也在不断推动文本到语音模型的创新。
下一代语音 AI
潜在声学表示(Latent Acoustic Representation ,LAR)
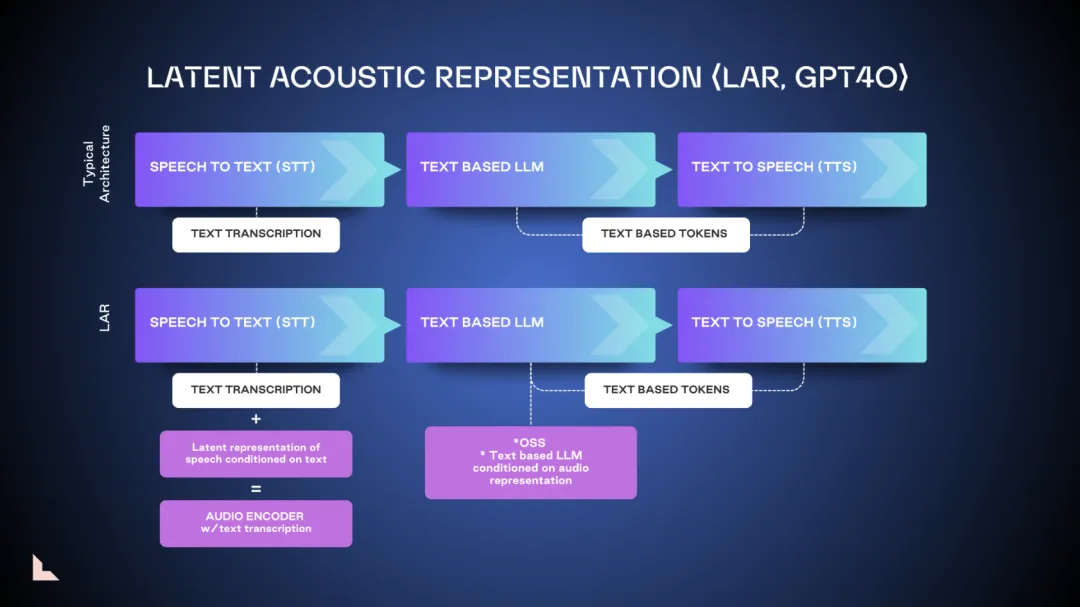
Tokenized 语音模型 (Tokenized Speech Model)
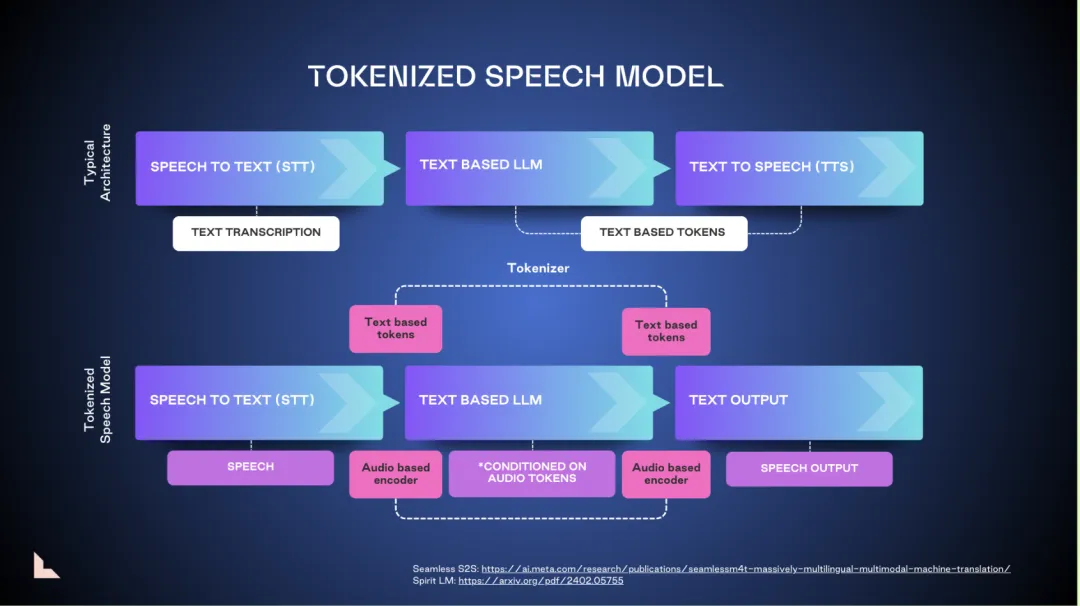
无文本语音模型 (Textless Speech Model)
流式模型(Streaming Model)
语音 AI 市场的未来及其挑战
以大规模语言模型为核心,并巧妙融合人工干预:对于任何语音 AI 交互,准确识别 AI 无法有效处理的场景至关重要。应用必须能够在用户体验受损之前,无缝且高效地将对话转交给人工客服。此外,公司需要深入了解技术架构的每一层,以便追踪语音应用错误或信息不准确的根本原因。 在提升性能的同时,降低延迟和成本:新兴架构面临的一个主要挑战是如何提供近乎实时的性能。虽然根据客户需求定制通用模型至关重要,但这在大规模应用中可能会耗时且成本高昂。为了提高质量和智能水平,基于 Transformer 模型的应用需要进行大规模的音频数据标注。将延迟降低到 250 毫秒以下对于打造自然的对话体验至关重要,而这通常通过自主搭建应用而非依赖全栈式架构更容易实现。成本始终是一个关键因素:对于大规模部署的语音代理而言,即使每分钟成本的细微差异也会对最终收益产生显著影响。 制定精准的市场进入策略:在现阶段,专注于特定垂直领域的应用比通用的多模态 AI 模型更具竞争优势。聚焦医疗、金融等大型垂直领域的企业级应用能够更快地获得市场份额,尽管随着新架构的成熟和价值的验证,这种情况可能会有所改变。早期成功的关键在于解决「最后一公里」问题,降低技术门槛,使其更易于被消费者和企业用户所接受。