
 语音小管家
最近,西工大音频语音与语言处理研究组(ASLP@NPU)与微软、CUHK-Shenzhen提出首个说唱生成模型Freestyler,以歌词和伴奏输入,生成与伴奏风格节奏匹配的说唱;同时开源了首个说唱数据集RapBank。现对该论文进行简要的解读和分享。
论文题目:Drop the beat! Freestyler for Accompaniment Conditioned Rapping Voice Generation
作者列表:宁子谦,王帅,姜月鹏,姚继珣,何磊,潘诗锋,丁杰,谢磊
合作单位:微软,CUHK-Shenzhen
论文原文:https://arxiv.org/abs/2408.15474
数据集开源地址:
HuggingFace: https://huggingface.co/datasets/zqning/RapBank
普通的歌唱语音合成(Singing Voice Synthesis, SVS)需要将歌词、音符以及时长作为输入内容。鉴于说唱(Rap)从本质上来说是⼀种节奏多变的⾃由表演形式,歌唱语音合成中预先设定的节奏可能会妨碍生成的自然性。相比之下,文本生成歌曲(Text to Singing, TTSing)提供了更大的灵活性,仅通过歌词和风格提示就能生成人声及伴奏。一种典型的文本生成歌曲方法是,首先依据歌词创建人声音轨,然后利用自然语言提示以及已生成的人声来生成伴奏音轨。然而,仅依据歌词条件来生成说唱歌声可能会有损节奏的完整性。此外,当前缺乏说唱数据集给说唱生成带来了额外的挑战。
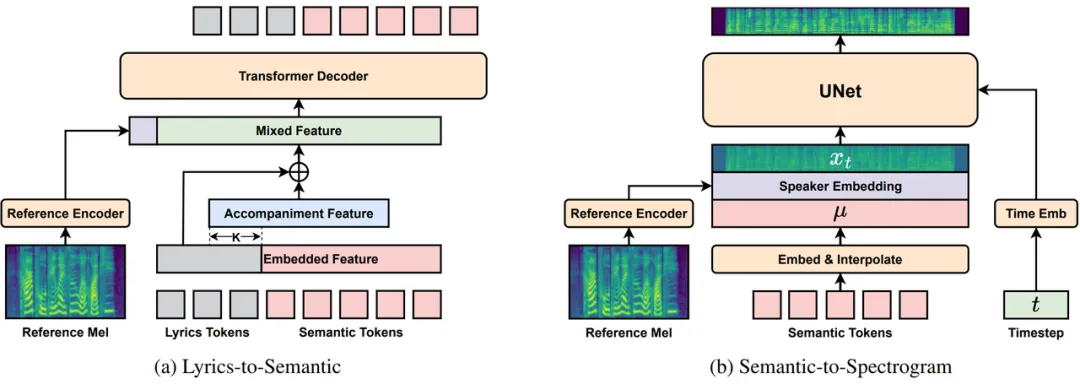
图 1 模型整体结构
为应对数据稀缺的挑战,我们将说唱生成任务划分为三个阶段:lyrics-to-semantic, semantic-to-spectrogram, 和 spectrogram-to-audio。我们并非直接从歌词生成声学 token 或梅尔谱,而是采用通过对自监督学习(SSL)表征进行 K-means 聚类而得到的语义标记作为一种中间特征,以此在 lyrics-to-semantic 以及 semantic-to-spectrogram 这两个阶段之间建立联系。这种方法有两个主要优势。首先,语义 token 与文本模态的关联性更强,使得第一阶段的模型能够使用较少的标注数据进行训练。其次,后续的两个阶段可以通过利用更多的无标注数据以无监督的方式进行训练。我们在 lyrics-to-semantic 阶段使用一个语言模型(LM),该模型以歌词、伴奏特征以及一段 3 秒的参考音频片段作为条件,生成离散的语义 token。在 semantic-to-spectrogram 阶段,我们采用条件流匹配(CFM)模型将离散的语义 token 转换为连续的梅尔谱。参考音频也被输入条件流匹配模型中,以补足语义 token 中缺失的音色信息。最后,利用一个预训练的声码器从频谱图中重构音频。整体的模型设计如图 1 所示。
任务定义
Lyrics-to-Semantic
表征提取
在SSL模型中不同层有不同的特征成分,其中浅层含有更多声学信息,深层有更多语义信息[2]。因此我们利用 SSL 模型的两个不同层来提取离散语义 token 和连续的伴奏特征。如图 2 所示,我们使用一个预训练的 Wav2Vec XLS-R[3]进行特征提取,人声输入通过其 18 层进行处理,随后利用 K-means 聚类获取语义token。而伴奏输入则通过 6 层来提取伴奏特征。对于歌词,我们采用 G2P[4] 来获取歌词 token。
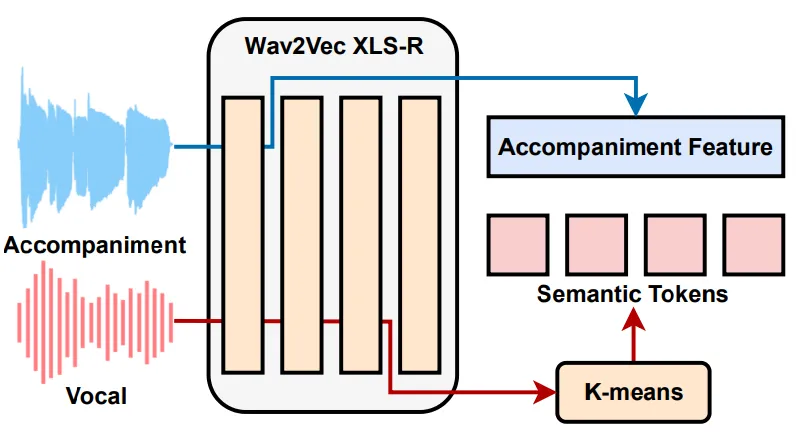
图 2 表征提取
细粒度伴奏条件的语言模型
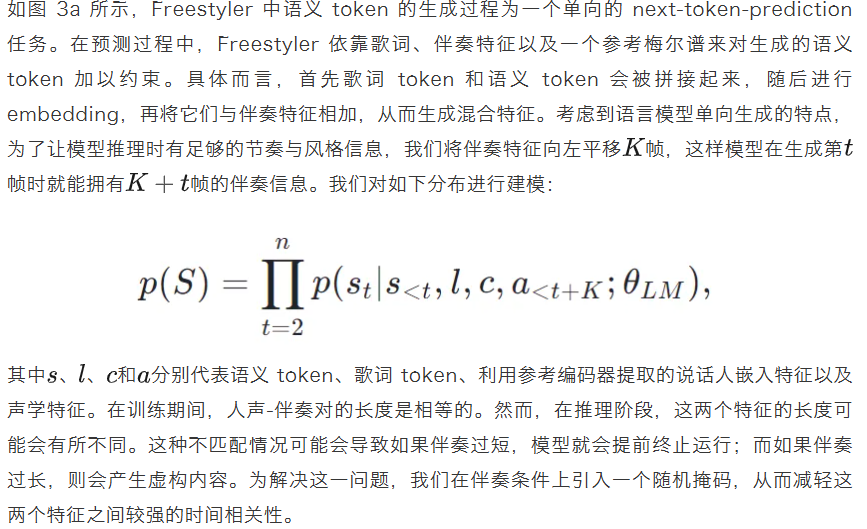
零样本音色控制
用于语音合成或歌唱合成的主流零样本方法通常涉及两种主要方式:利用语音 prompt 来发挥语言模型的 in-context learning 学习能力,或者使用说话人嵌入特征作为全局音色条件。Freestyler 用后一种方法,原因在于语音 prompt 的风格会对最终生成的语音风格产生重大影响。这意味着我们需要要求用户提供一段说唱片段作为提示,而这并非易事。
另一方面,说话人嵌入特征主要影响音色,而说唱风格主要是由伴奏特征来控制的。这样就能确保我们可以生成具有任何目标音色的说唱歌声。在具体的实现过程中,我们使用一个参考编码器从一段参考音频中提取全局说话人嵌入特征。然后,将该嵌入特征拼接到混合特征的头部,以此来实现对音色的控制。
Semantic-to-Spectrogram
我们采用条件流匹配的方法将语义 token 映射到梅尔谱上。鉴于语义 token 由于其离散性的特点而缺乏完整的音色信息,我们在这一阶段引入了额外的音色条件。如图 3b 所示,条件流匹配模型参考 Matcha-TTS [3]的做法,使用 UNet 架构作为主干网络,其包含一维卷积残差块,用于对输入进行下采样和上采样。每个残差块之后都跟着一个 Transformer 模块,该模块的前馈网络使用 Snake Beta 激活函数。此外,说话人嵌入特征是由一个参考编码器提取的。需要注意的是,语言模型和条件流匹配模型中的参考编码器并不共享参数。
Spectrogram-to-audio
我们采用 BigVGAN [4]的 V2 版本进行音频还原。与 V1 版本相比,BigVGAN-V2 使用包含多种音频类型的数据集进行训练,这些音频类型涵盖了多种语言的语音、歌唱以及环境音。此外,其鉴别器通过多尺度子带 CQT 判别器以及多尺度梅尔谱损失得到了改进。我们发现 BigVGAN-V2 在说唱歌声方面展现出了高品质的音质以及出色的鲁棒性。
目前并没有公开可用的用于说唱合成的数据集。因此我们创建了一个自动化流程来收集并标注一个全新的数据集 ——RapBank,用于所提出的说唱合成模型的训练。RapBank 包含 92371 首说唱歌曲,总时长为 5586 小时。经过切分处理后,我们生成了 904548 个说唱片段,时长为 4353 小时,同时还配有相应的歌词以及各类与质量相关的指标。我们首先从YouTube上爬取了大量说唱歌曲,随后经过人声-伴奏分离、切分、歌词识别、质量筛选后得到可用于训练模型的干净数据。
数据集
我们利用 RapBank 的英文子集来训练 LM,该子集包含大约 58200 首歌曲,总时长为 3800 小时。经过处理后,我们得到了 Basic 、 Standard 和 Premium 三个子集,它们分别包含 1 小时、321 小时和 295 小时的数据。我们使用整个 RapBank 来训练 CFM 模型,因为该模型不需要任何标签。我们随机预留了 200 个样本用于评估,这些样本中的歌手与训练集不存在重叠情况。这些样本经过人工标注,以获取准确的歌词标注。
人声质量评估
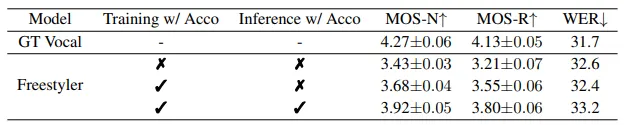
Freestyler 在所有指标上都取得了与真实音频 (GT) 可比的效果。值得注意的是,当在训练和推理阶段都不输入伴奏时,生成的说唱内容在自然度和节奏感方面会显著下降,这强调了该条件的必要性。当在训练阶段包含伴奏条件,但在推理阶段不输入该条件时,其表现仍优于在两个阶段都不输入伴奏条件的情形。这一发现表明当模型在训练过程中使用了伴奏时,它能学习到歌词与伴奏之间的节奏关联性,从而即便在仅依据歌词进行推理时也能提升表现。与普通语音相比,包括 GT 在内的所有说唱的词错误率都明显偏高,这主要是因为用于评估词错误率的 Whisper 模型缺乏针对歌唱数据的训练。不过这些模型有着相近的词错误率,这意味着它们达到了与真实情况相当的可懂度水平。
表1 Freestyler生成人声的主客观测试结果
带伴奏说唱评估
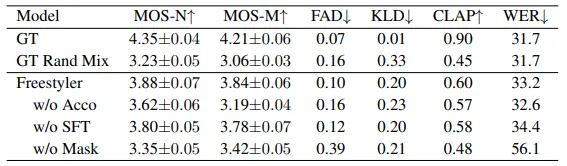
我们将真实说唱歌曲的片段作为 topline ,同时从测试集中随机选取并混合不匹配的人声和伴奏来作为 bottomline。如表 2 所示,随机混合的真实样本得分最低,这表明了人声与伴奏之间在风格和节奏上保持一致对于自然的说唱表演的重要性。相反, Freestyler 取得了与 GT 相当的分数,证明了它能够生成自然的说唱内容。
我们还对三个消融实验系统进行了实验:1)去除伴奏条件;2)去除有监督微调;3)去除随机掩码。去除伴奏条件会导致人声与伴奏之间的匹配性显著降低,进而使整体的自然感下降。去除有监督微调会使总体指标略有下降。值得注意的是,没有随机掩码产生的影响最为显著,它会明显降低自然度和匹配性,同时还会导致词错误率急剧上升。之所以出现这种现象,是因为在没有随机掩码的情况下,会导致训练和推理之间出现严重的不匹配情况。
表 2 带伴奏说唱的主客观测试结果
零样本评估
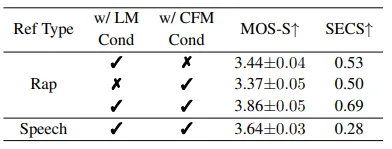
表 3 中的音色相似度指标表明:1)Freestyler 在两个阶段都使用了参考音频输入,其主观MOS分达到了 3.86,说话人嵌入余弦相似度得分达到了 0.69,这表明我们所提出的系统生成的说唱歌声具有较高的说话人相似度;2)无论是在第一阶段还是第二阶段仅实施单阶段的音色条件,都会导致相似度显著下降,从而佐证了我们关于语义标记无法传递完整音色信息的这一假设。
此外,我们还进行了实验,使用语音(而非说唱)作为参考音频,让非专业人士也能够进行说唱表演。如表中最后一行所示,达到了令人满意的主观相似度水平,这体现了 Freestyler 出色的零样本音色控制泛化能力。不过客观指标较低,这可能是因为我们用于计算说话人嵌入余弦相似度(SECS)的模型在训练期间从未见过同一说话人在风格上存在如此大的差异,从而导致说话人嵌入余弦相似度得分较低。
表 3 音色相似度测试结果
人声-伴奏对齐可视化:
为了将说唱中人声与伴奏音乐之间的节奏关联性可视化,我们对真实以及合成的说唱进行了分析。如图 3 依次展示了真实的伴奏与人声的频谱图以及合成人声的频谱图。我们手动标注了伴奏中节拍的位置,以竖线表示。结果显示,无论是真实的人声还是生成的人声,都与伴奏的节奏呈现出很强的关联性。这一发现凸显了 Freestyler 利用伴奏作为条件来生成节奏匹配的说唱内容的能力。
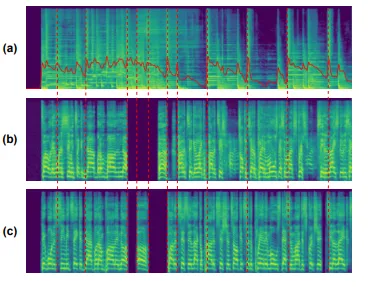
图 3 频谱与节拍位置可视化
[1] Li, S.; Liu, S.; Ma, L.; and Xing, C. 2024b. Asymptotic construction of locally repairable codes with multiple recovering sets. CoRR, abs/2402.09898.
[2] Pasad, A.; Chou, J.; and Livescu, K. 2021. Layer-Wise Analysis of a Self-Supervised Speech Representation Model. In Proc. ASRU, 914–921.
[3] Conneau, A.; Baevski, A.; Collobert, R.; Mohamed, A.; and Auli, M. 2021. Unsupervised Cross-Lingual Representation Learning for Speech Recognition. In Hermansky, H.; Cernock´y, H.; Burget, L.; Lamel, L.; Scharenborg, O.; and Motl´ıcek, P., eds., Proc. Interspeech, 2426–2430.
[4] Bernard, M.; and Titeux, H. 2021. Phonemizer: Text to Phones Transcription for Multiple Languages in Python. Journal of Open Source Software, 6: 3958.
[5] Mehta, S.; Tu, R.; Beskow, J.; Sz´ekely, ´E.; and Henter, G. E. 2024. Matcha-TTS: A fast TTS architecture with conditional flow matching. In Proc. ICASSP, 11341–11345.
[6] Lee, S.; Ping, W.; Ginsburg, B.; Catanzaro, B.; and Yoon, S. 2023. BigVGAN: A Universal Neural Vocoder with Large Scale Training. In Proc. ICLR.
