
 语音小管家
📂 代码仓库及体验链接
GitHub仓库:CosyVoice(https://github.com/FunAudioLLM/CosyVoice)查阅最新更新的CosyVoice 2
在线体验DEMO:https://www.modelscope.cn/studios/iic/CosyVoice2-0.5B 开源代码:https://github.com/FunAudioLLM/CosyVoice 开源模型:https://www.modelscope.cn/models/iic/CosyVoice2-0.5B
▎核心模型与算法亮点
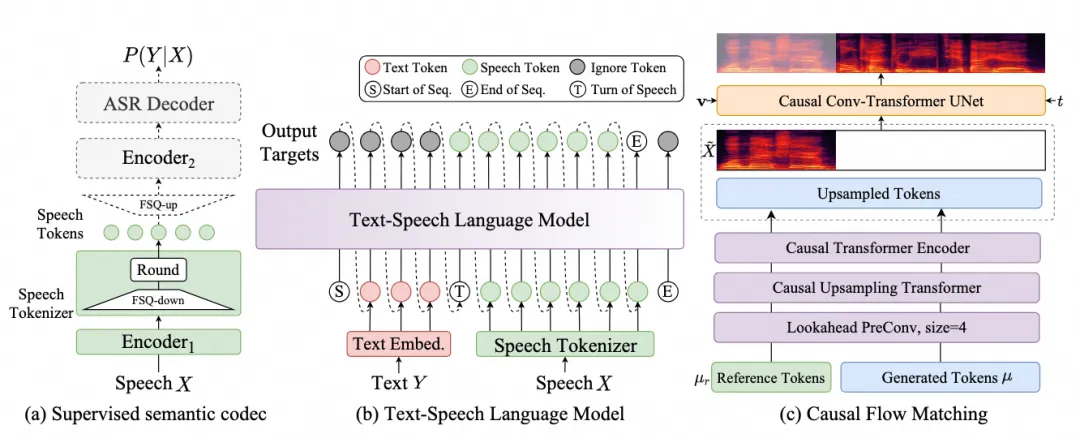
图1. CosyVoice 2 模型结构框图
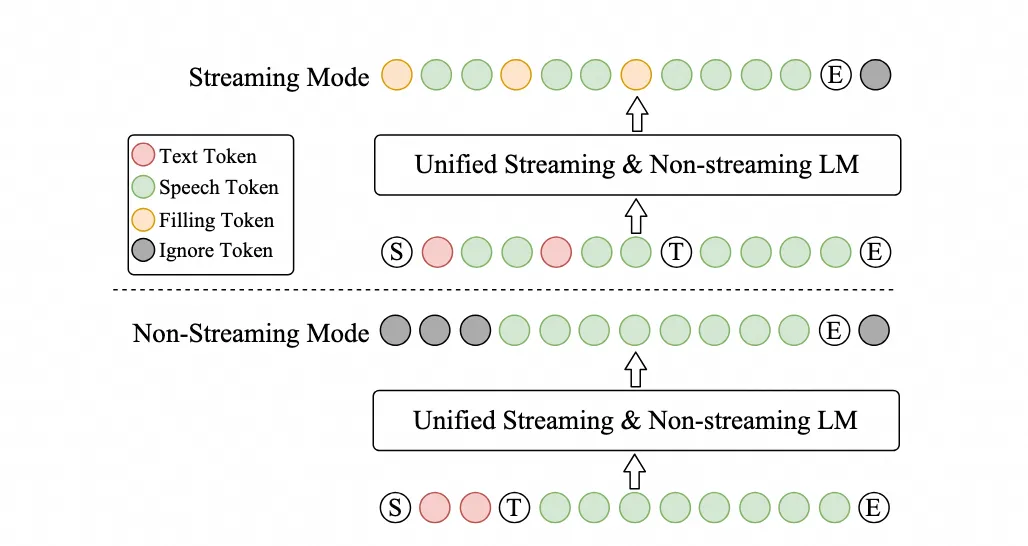
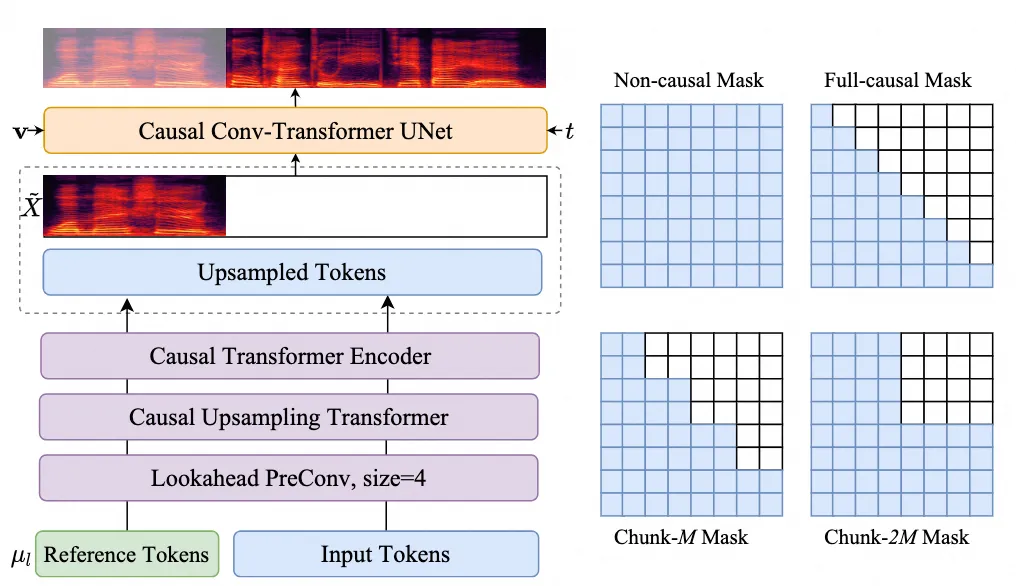
图2. CosyVoice 2 离线和流式一体化建模方案
▎效果体验与部署
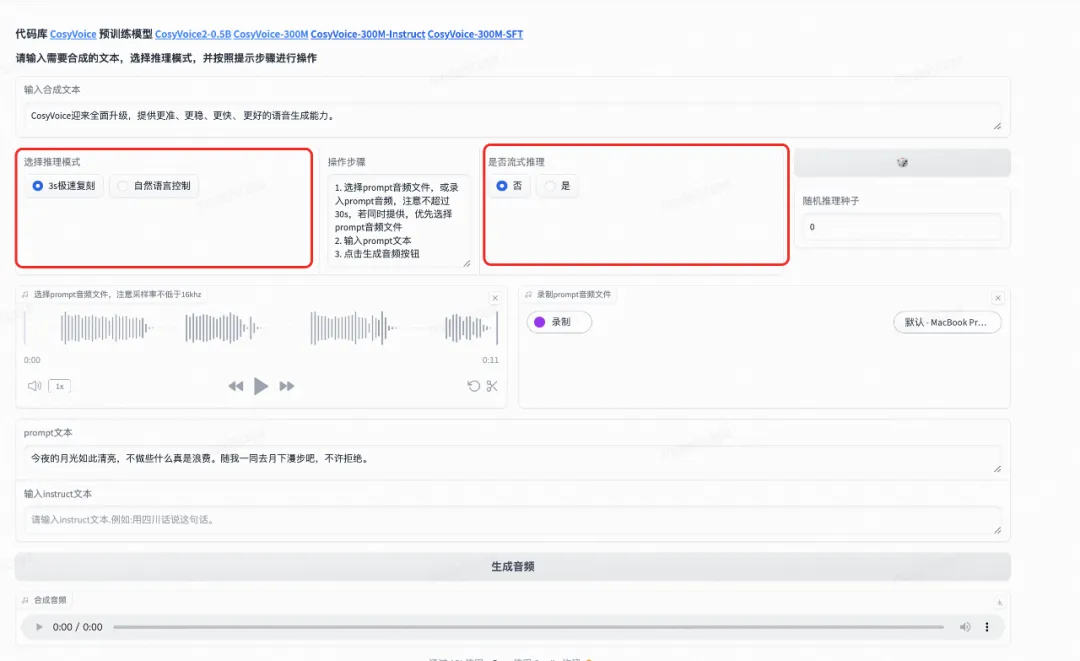
CosyVoice 2支持音色克隆以及自然语言控制的音频生成,可以选择相应的推理模式。
1)3s极速复刻
输入待合成文案
选择是否流式推理,流式推理具有更低的延迟,离线推理具有更好的上限效果
上传prompt音频,或者录制prompt音频
点击生成音频,等待一会儿就会听到合成的音频。
2)自然语言控制
输入待合成文案
上传prompt音频,或者录制prompt音频
输入instruct文本:例如“用粤语说这句话”,“用开心的语气说”,“模仿机器人的声音”等
点击生成音频,等待一会儿就会听到合成的音频。
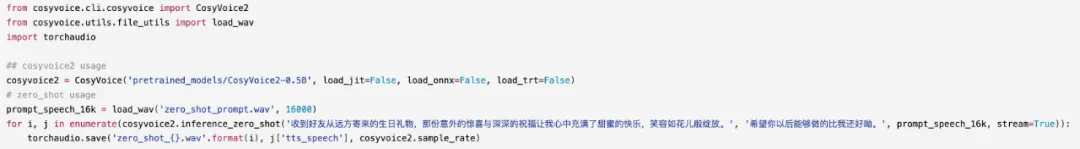
同时,通义实验室也开源了cosyvoice2-0.5B的代码以及预训练模型,方便用户进行本地体验或部署。
下载模型后并安装好环境后,本地体验有两种方法:
启动webui,执行python webui.py即可;
脚本推理,根据readme在python中执行如下代码:
相关文献参考:
【1】 Du Zhihao, Chen Qian, Zhang Shiliang, et al. Cosyvoice: A scalable multilingual zero-shot text-to-speech synthesizer based on supervised semantic tokens[J]. arXiv preprint arXiv:2407.05407, 2024.
【2】Mentzer F, Minnen D, Agustsson E, et al. Finite scalar quantization: Vq-vae made simple[J]. arXiv preprint arXiv:2309.15505, 2023.
【3】 Du Zhihao, Wang Yuxuan, Chen Qian, et al. CosyVoice 2: Scalable Streaming Speech Synthesis with Large Language Models.
