
 语音小管家
论文链接:https://arxiv.org/pdf/2501.01957
Demo视频:https://youtu.be/tyi6SVFT5mM
项目地址:https://github.com/VITA-MLLM/VITA
VITA-1.5大幅降低互动延迟,从 4 秒缩短至 1.5 秒,显著提升用户体验。
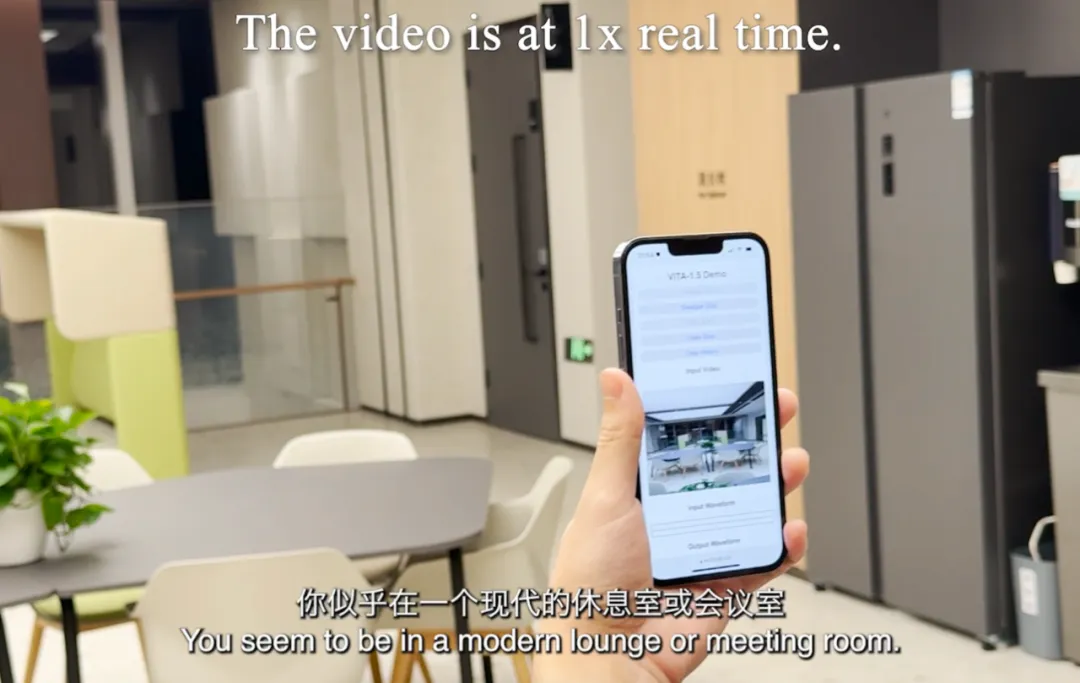
显著降低交互延迟 增强多模态性能 改进语音处理能力 渐进式多阶段训练策略
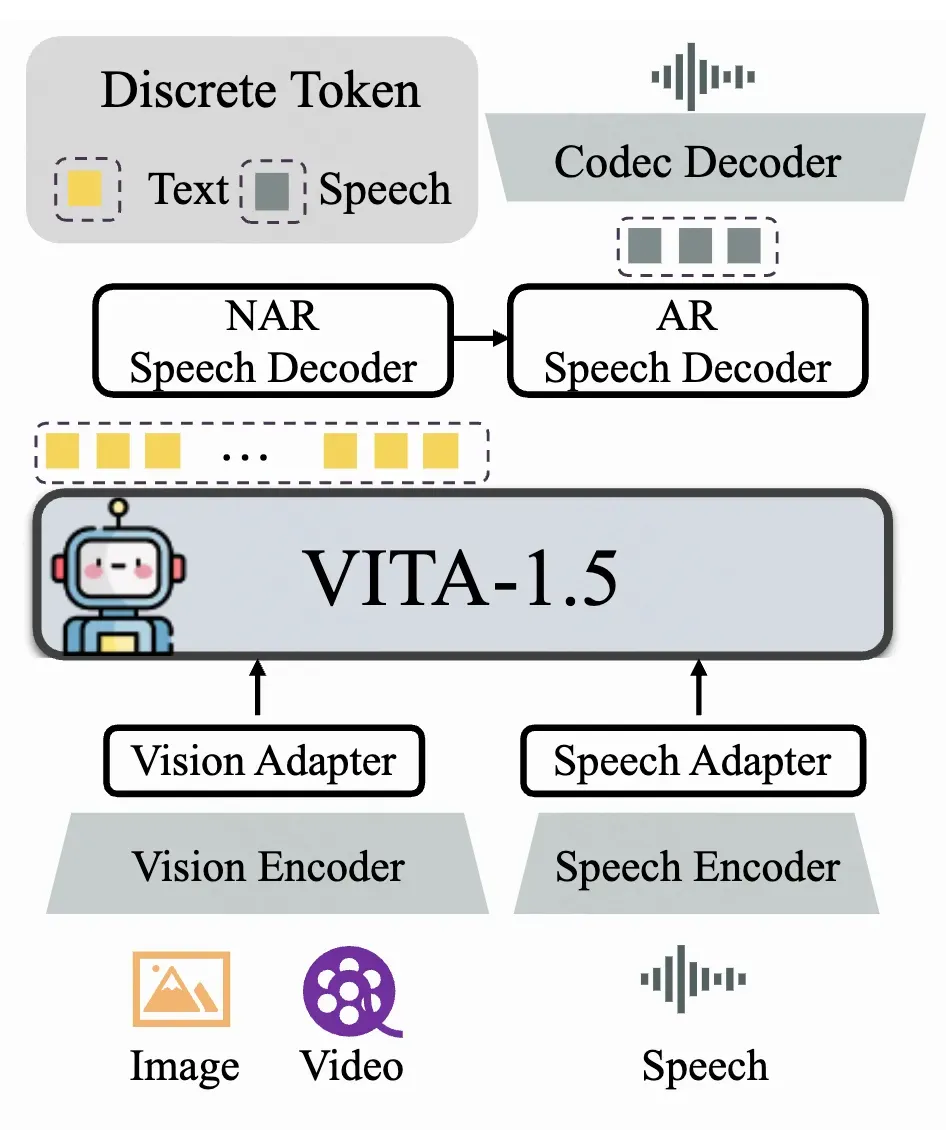
VITA-1.5的整体架构包括视觉和音频编码器,以及连接到大型语言模型的适配器。输出端则具有一个端到端的语音生成模块,而不是像最初的 VITA-1.0 版本那样使用外部 TTS 模型。视觉编码器采用 InternViT-300M,输入图像大小为 448×448 像素,每张图像生成 256 个视觉令牌。
模型架构
视觉模态
VITA-1.5 使用 InternViT-300M 作为视觉编码器,输入图像大小为 448×448 像素,每张图像生成 256 个视觉 token。对于高分辨率图像,采用动态分块策略以捕获局部细节,从而提升图像理解的精度。
视频被视为多帧图像的特殊输入:
视频长度小于 4 秒时,均匀采样 4 帧;
长度在 4 至 16 秒之间时,每秒采样 1 帧;
长度超过 16 秒时,均匀采样 16 帧。视频帧不使用动态分块,以避免生成过多视觉 token,影响处理效率。
视觉适配器
音频模态
语音适配器
语音解码器
语音解码模块采用 TiCodec 作为 Codec 模型,使用一个大小为 1024 的单一码本。这种设计简化了推理阶段的解码过程。编解码器负责将连续的语音信号编码为离散语音 token,并能解码回 24,000Hz 的语音信号。
为了让 LLM 能够输出语音 token,VITA-1.5 在文本 token 的基础上增加了两个语音解码器:
非自回归(NAR)语音解码器:对文本token进行整体处理,建模语义特征,用于生成初始的语音 token 分布。
自回归(AR)语音解码器:基于 NAR 解码器生成的语音信息,逐步生成高质量的语音 token。
最终生成的语音 token 序列通过 Codec 模型解码为连续的语音信号流。
实验发现
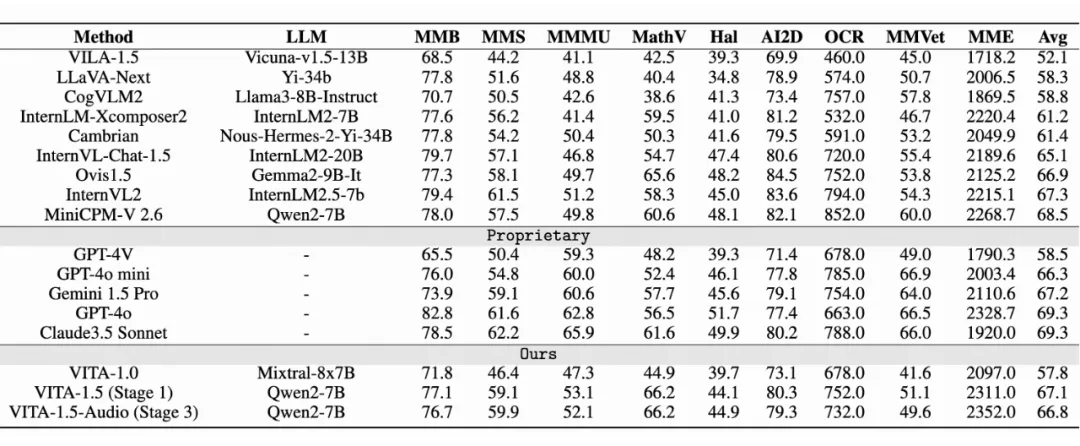
▲ 图像理解能力评测
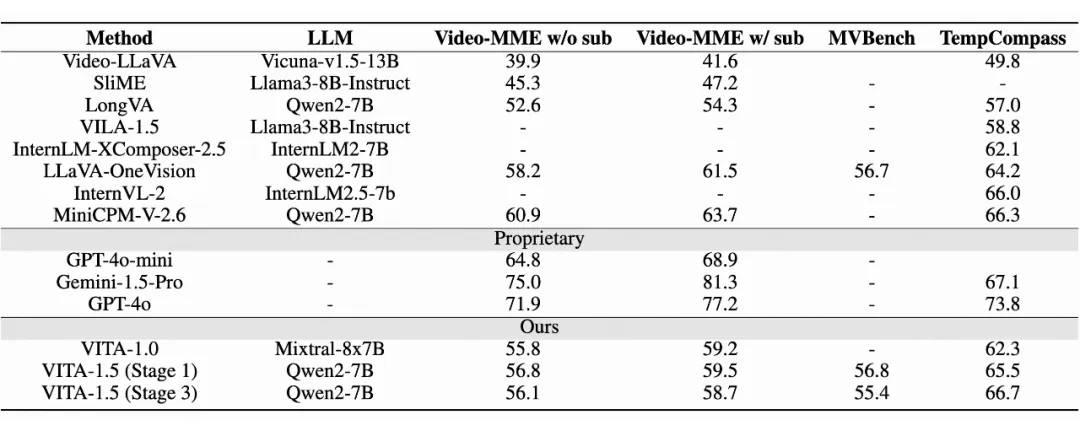
上表展示了 VITA-1.5 在图像理解性能上的对比。经过三阶段训练后,VITA-1.5 的表现可与最先进的开源图像-语言模型媲美,显示了 VITA-1.5 在图像-语言任务中的强大能力。在视频理解评估中,VITA-1.5 的表现与顶尖开源模型相当。但与私有模型仍有较大差距,这表明 VITA-1.5 在视频理解方面仍有较大的改进空间和潜力。
VITA-1.5 的一个亮点在于,在第二阶段(音频输入微调)和第三阶段(音频输出微调)训练后,VITA-1.5 几乎保留了其在第一阶段(视觉-语言训练)中的视觉-语言能力,尽量避免了因为引入语音信息导致多模态能力下降。
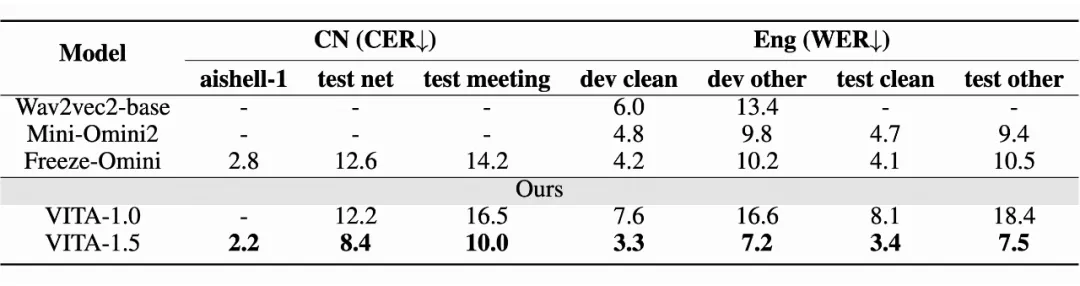
使用了以下三个基准模型进行比较:Wav2vec2-base、Mini-Omini2、Freeze-Omini 和 VITA-1.0。
总 结
在本文中,介绍了VITA-1.5,这是一个设计用于通过精心制定的三阶段训练策略整合视觉和语音的多模态大型语言模型(LLM)。通过缓解模态间的固有冲突,VITA-1.5 在视觉和语音理解方面都具备强大的能力,能够在不依赖独立的ASR或TTS模块的情况下实现高效的语音转语音交互。广泛的评估表明,VITA-1.5 在多模态基准测试中具有竞争力。希望VITA-1.5能够继承VITA-1.0的旗帜,继续推动实时多模态交互领域开源模型的进步。
