
 语音小管家
ZyphraAI 近日发布了其最新的多语言文本到语音(TTS)模型——Zonos-TTS。
模型地址:https://huggingface.co/Zyphra/Zonos-v0.1-hybrid
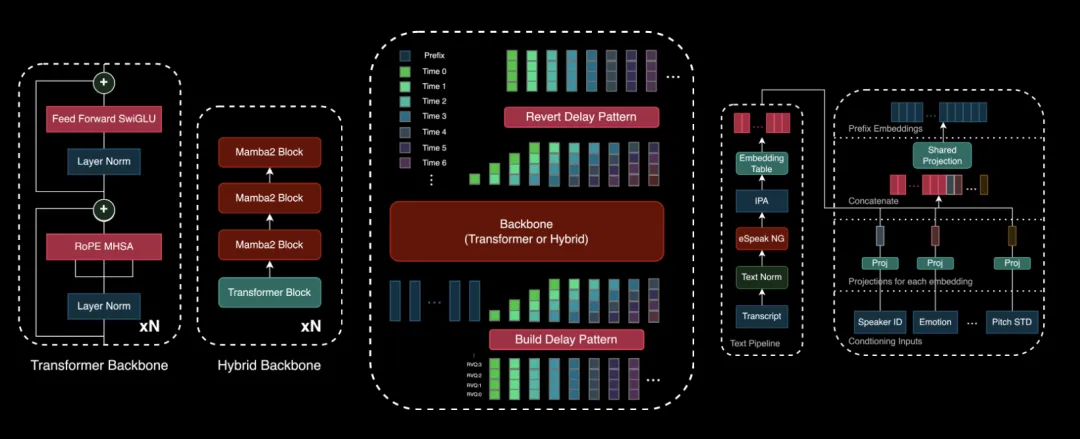
核心亮点
高保真语音克隆:通过输入5到30秒的语音样本进行高保真的语音克隆。
多语言支持:支持英语、日语、中文、法语和德语。
情绪调节与语音定制:提供了多种语音定制选项,包括音高、语速、音质和情绪等方面。
前缀匹配与说话人定制:通过添加文本和音频前缀,能实现更精细的说话人匹配效果。
超高性能与实时生成:在性能方面表现得非常突出,特别是在 RTX 4090 显卡上运行时,实时率约为2倍。
内置简易界面:Zonos 内置了一个易于使用的 gradio 界面,用于生成语音。
使用方法
Zonos的使用并不复杂,对于小白用户来说,可以直接体验测试版。
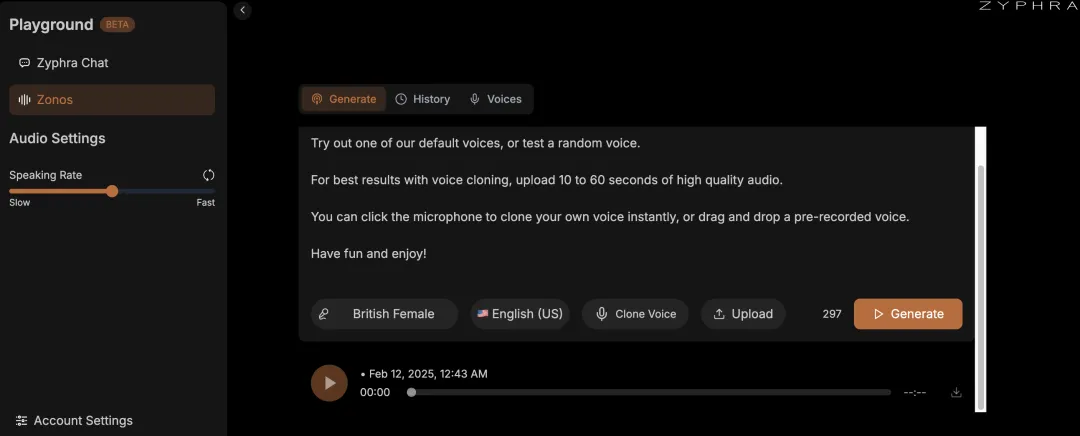
Python
import torch
import torchaudio
from zonos.model import Zonos
from zonos.conditioning import make_cond_dict
# model = Zonos.from_pretrained("Zyphra/Zonos-v0.1-hybrid", device="cuda")
model = Zonos.from_pretrained("Zyphra/Zonos-v0.1-transformer", device="cuda")
wav, sampling_rate = torchaudio.load("assets/exampleaudio.mp3")
speaker = model.make_speaker_embedding(wav, sampling_rate)
cond_dict = make_cond_dict(text="Hello, world!", speaker=speaker, language="en-us")
conditioning = model.prepare_conditioning(cond_dict)
codes = model.generate(conditioning)
wavs = model.autoencoder.decode(codes).cpu()
torchaudio.save("sample.wav", wavs[0], model.autoencoder.sampling_rate)
Gradio 界面(推荐)
uv run gradio_interface.py
# python gradio_interface.py
这将应在您的项目根目录中生成一个 sample.wav 文件。
对于重复采样,我们强烈推荐使用gradio界面,因为最小示例每次运行时都需要加载模型。
功能
零样本TTS与声音克隆:输入所需文本和10-30秒的说话人样本,以生成高质量的TTS输出
音频前缀输入:添加文本和音频前缀以实现更丰富的说话人匹配。音频前缀可用于引发诸如耳语等行为,这些行为在从说话人嵌入克隆时可能难以复制
多语言支持:Zonos-v0.1支持英语、日语、中文、法语和德语
音频质量和情感控制:Zonos提供了对生成音频许多方面的精细控制。这包括说话速度、音调、最大频率、音频质量以及各种情感,如快乐、愤怒、悲伤和恐惧。
快速:我们的模型在RTX 4090上以约2倍实时因子运行
Gradio WebUI:Zonos 随带一个易于使用的 Gradio 界面,用于生成语音
简单的安装和部署:Zonos 可以通过我们仓库中打包的 Docker 文件简单地安装和部署。
