语音小管家
来源丨 CreateAMind
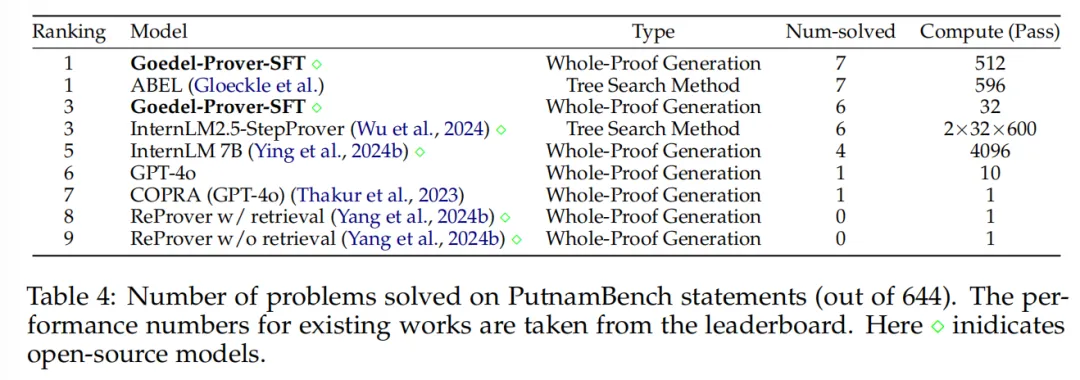
Goedel-Prover是一个开源的大型语言模型,专注于数学问题的自动形式化证明生成。通过训练语句形式化工具,将自然语言的数学问题翻译成形式化语言(Lean 4),并创建了一个包含164万条形式化语句的数据集。模型在miniF2F基准测试中达到了57.6%的成功率(Pass@32),在PutnamBench中成功解决了7个问题,生成了29.7K个Lean Workbook问题的形式化证明,几乎是之前工作的两倍。
论文题目:Goedel-Prover: A Frontier Model for Open-Source Automated Theorem Proving
Goedel-Prover 是一个开源的大型语言模型(LLM),在数学问题的自动化形式化证明生成方面达到了最先进的性能(SOTA)。该领域的主要挑战是形式化的数学陈述和证明的稀缺性,我们通过以下方式解决这一问题。我们训练了陈述形式化器,将 Numina 中的自然语言数学问题翻译成形式语言(Lean 4),创建了一个包含 164 万条形式化陈述的数据集。LLM 用于检查形式化陈述是否准确保留了原始自然语言问题的内容。然后,我们通过训练一系列证明器,迭代构建一个大型的形式化证明数据集。每个证明器都成功证明了许多前一个证明器无法证明的陈述,这些新的证明被添加到下一个证明器的训练集中。最终的证明器在完整证明生成方面超越了所有现有的开源模型。在 miniF2F 基准测试中,它实现了 57.6% 的成功率(Pass@32),比之前的最佳开源模型高出 7.6%。在 PutnamBench 上,Goedel-Prover 成功解决了 7 个问题(Pass@512),在排行榜上排名第一。此外,它为 Lean Workbook 问题生成了 29.7K 的形式化证明,几乎是之前工作产生的 15.7K 的两倍。
最近在大型语言模型(LLM)方面的进展展示了其在推理任务中的显著能力,尤其是在解决数学问题方面(Guo 等,2025;Yang 等,2024a)。这些模型在自然语言推理方面表现出色,我们称之为非形式化推理。然而,基于自然语言的推理很难被机器自动验证,这削弱了非形式化推理在实际应用中的可靠性,并且也使得进一步提高语言模型的推理能力更加困难。与非形式化推理相比,形式化推理允许以机器可验证的格式进行推理,为验证和自动化开辟了新的可能性。特别是,像 Lean(De Moura 等,2015;Moura 和 Ullrich,2021)、Isabelle(Paulson,1994)和 Coq(Barras 等,1997)这样的证明助手提供了可以机械验证的形式化语言来表达推理。因此,训练 LLM 在这些形式化语言中撰写证明具有极大的兴趣。
在形式化语言中训练 LLM 进行定理证明的一个重大挑战是形式化的数学陈述和证明的稀缺性。为形式化语言中表达的定理撰写证明是非常具有挑战性的,需要相当多的领域专业知识。
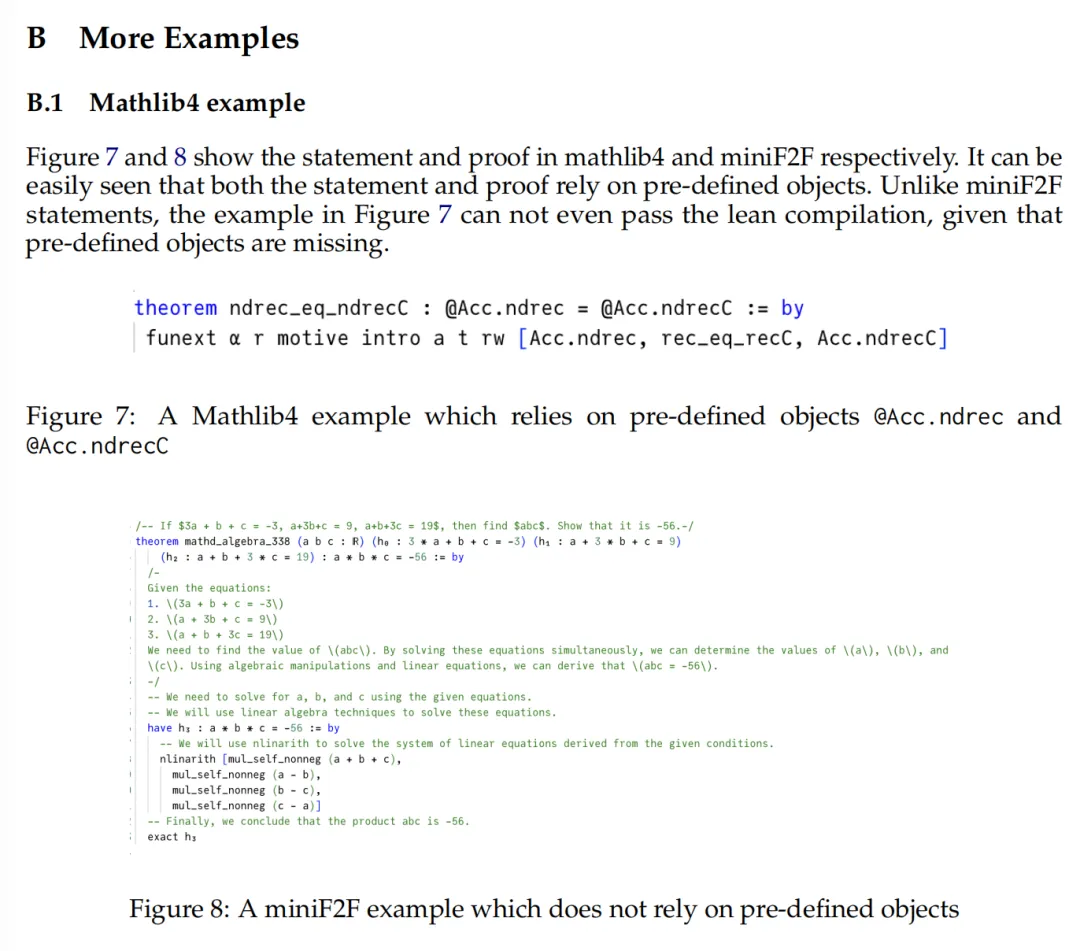
我们的模型在 miniF2F 上超越了 DeepSeek-Prover-V1.5-RL(之前的 SOTA 模型)7.6%,实现了 57.6% 的 Pass@32 分数,相比之下 DeepSeek-Prover-V1.5-RL 的分数为 50.0%,如图 1(左)所示。它在所有采样预算中都一致地超过了 DeepSeek-Prover-V1.5-RL,包括 Pass@32、64 以及高达 25600,如图 1(中)所示。 我们在 Lean Workbook 中累计解决了 29.7K 个问题,显著增加了 InternLM2.5-StepProver 和 InternLM-Math-Plus(Wu 等,2024;Ying 等,2024b)找到的现有 15.7K 证明,如图 1(右)所示。 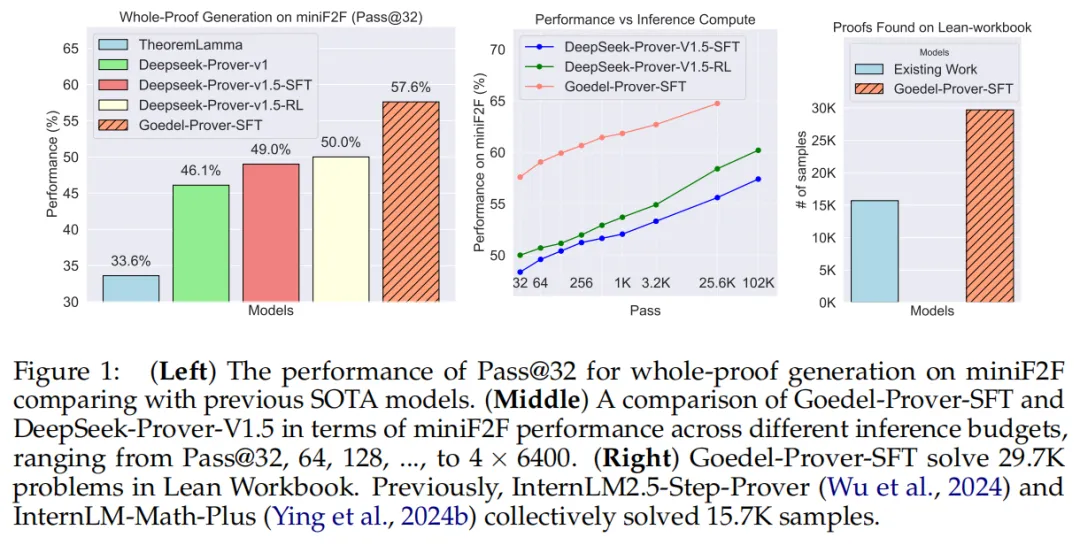
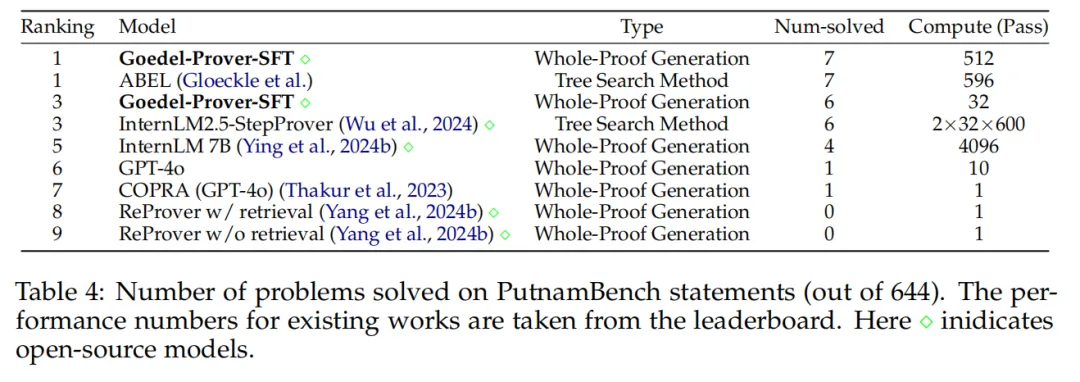
我们的模型通过 Pass@512 在 PutnamBench 上解决了 7 个问题,在排行榜上获得了第 1 名的位置(表 4)。
我们开源我们的代码、模型以及在 Lean Workbook 中发现的新证明,以促进未来的研究。
自动形式化和合成数据生成高质量形式化数学数据的短缺是训练定理证明模型的一个重大瓶颈。尽管像强化学习这样的技术可能会减少对人工编写的证明的依赖(Google DeepMind,2024),但仍需要大量的形式化定理陈述。一个有前景的方法是通过自动形式化合成形式化陈述,其中大型语言模型(LLMs)将非形式化的数学陈述翻译成形式化陈述(Wu 等,2022;2024;Xin 等,2024a;b)。
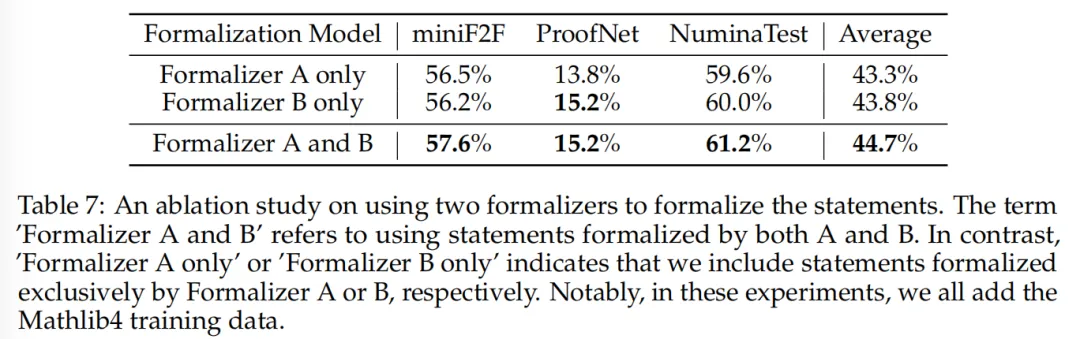
DeepSeek-Prover(Xin 等,2024a)和 InternLM2.5-StepProver(Wu 等,2024)已经成功地实施了这一策略,将大量陈述形式化为 Lean,用于专家迭代。我们采用了类似的方法。不同之处在于:虽然 Liu 等(2024)专注于形式化他们内部的数据集,我们则专注于形式化 Numina 数据集(Li 等,2024a)以及一个私下收集的数据集。此外,我们训练了两个形式化器以增强形式化风格的多样性,我们在第 4 节中展示了这一点是有益的。
陈述形式化
我们首先训练陈述形式化器,将 Numina 中的非形式化陈述翻译成形式化陈述,如图 2 所示。为了增强形式化陈述的多样性,我们训练了两个模型来形式化非形式化陈述。
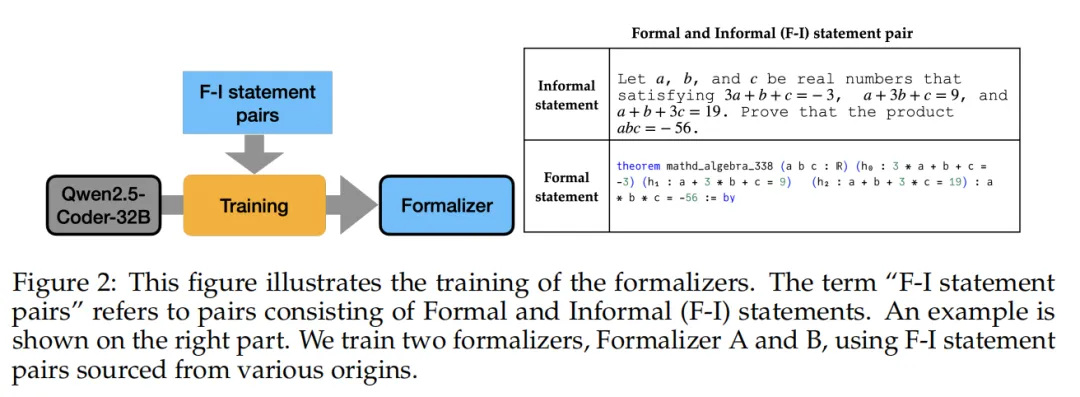
形式化器 A:我们使用来自 Lean Workbook 的形式化和非形式化(F-I)陈述对来训练形式化器 A 模型。
形式化器 B:我们使用 Claude-sonnet-3.5 来形式化 Numina 中的 230K 条陈述。从这个集合中,我们提取了 170K 条成功通过 Lean 编译的陈述。这 170K 条 F-I 陈述对随后被用来训练形式化器 B。
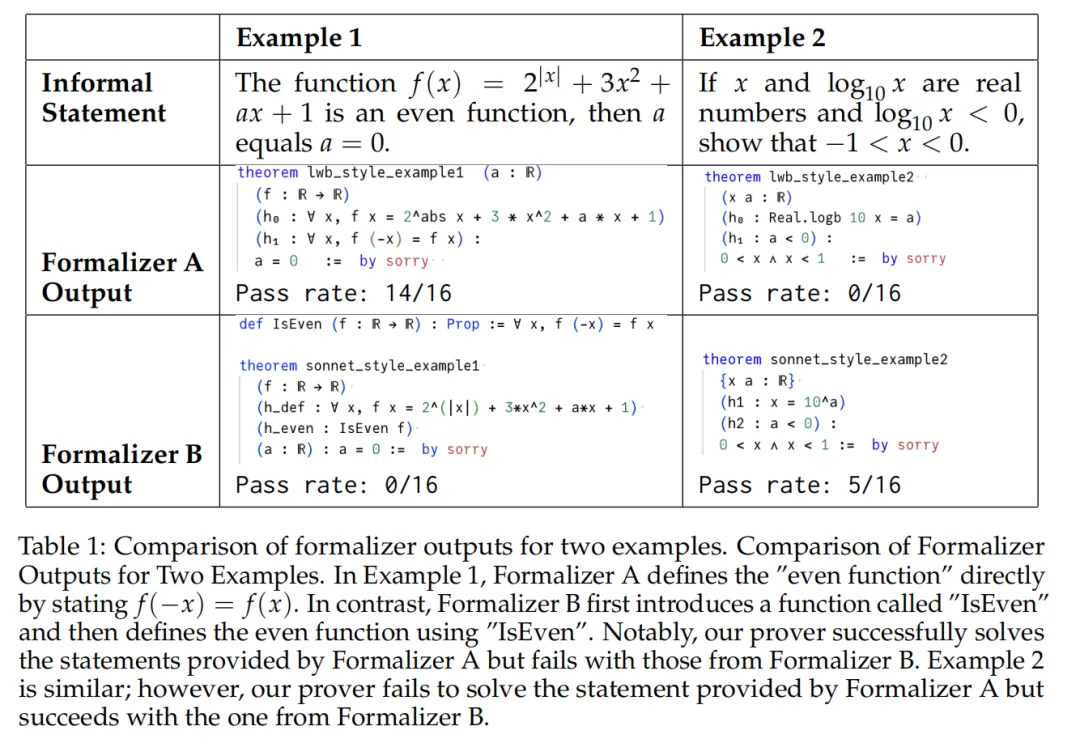
形式化器 A 和 B 都是使用 Qwen2.5-Coder-32B 进行监督微调训练的。在 8 个 H100 GPU 上,这两个形式化器的训练时间不到 24 小时。表 1 提供了两个例子,形式化器 A 和 B 在这两个例子中都给出了合理的形式化结果。然而,我们的最终证明器在这些形式化的陈述上表现各异,这突显了形式化风格对模型有效性的影响。
质量评估
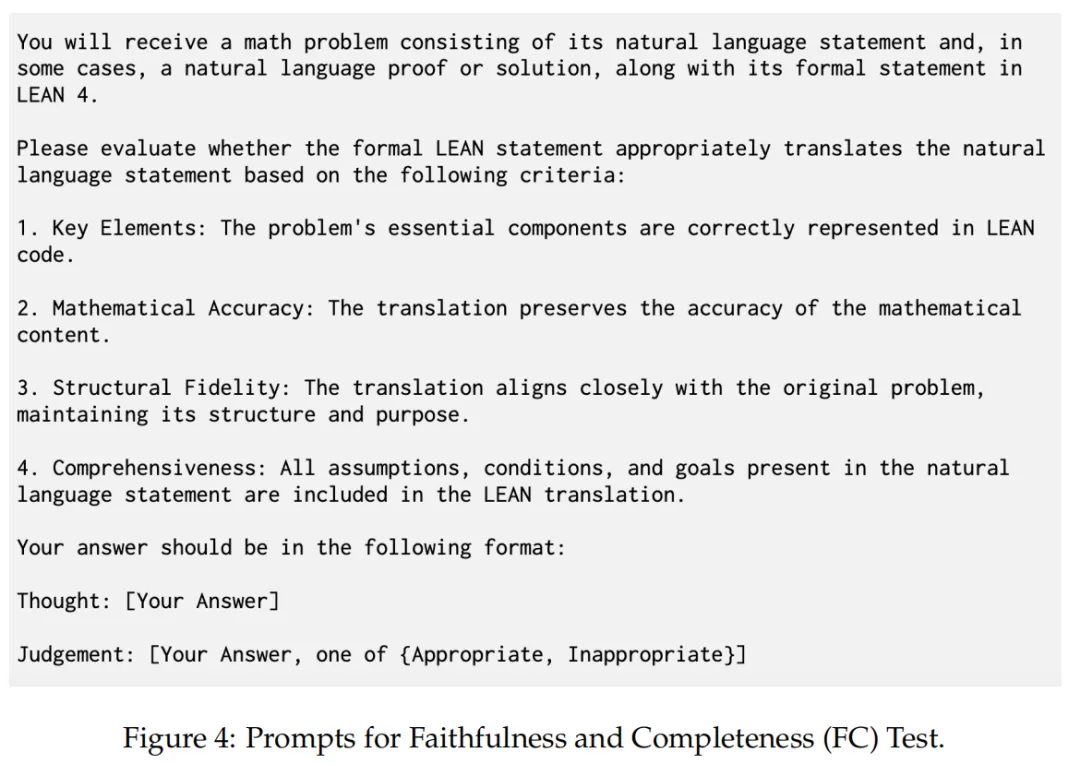
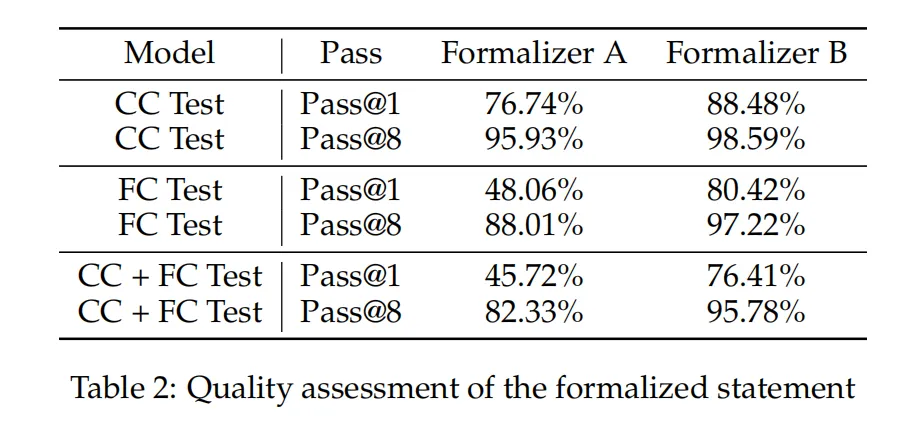
我们采用两种测试来评估形式化陈述的质量。首先,形式化陈述必须符合 Lean 语法并能够成功编译,潜在的证明被替换为占位符“:= by sorry”。这种语法检查在文献中被称为编译正确性(Compiling Correctness, CC)测试(Ying 等,2024a)。其次,形式化陈述必须准确捕捉原始非形式化问题,包含所有假设、条件和隐式定义。我们将这种测试称为忠实性和完整性(Faithfulness and Completeness, FC)测试。对于 FC 测试,我们使用 Qwen2.5-72B-Instruct,提示语如图 4 所示。对于每条形式化陈述,我们生成四个独立的判断,并将 FC 分数计算为四个判断中“适当”的数量除以 4。例如,如果 Qwen2.5-72B-Instruct 生成的四个判断中有三个“适当”和一个“不适当”,则整体 FC 分数计算为 0.75。我们筛选出 FC 分数低于 0.5 的形式化陈述。
对于 Numina 中的每条非形式化陈述,我们从每个形式化器生成八条形式化陈述,每条问题共产生 16 条形式化陈述。每条陈述都经过 CC 和 FC 测试,我们只保留有效的陈述。然后,我们从每个形式化器中随机选择一条有效的陈述。例如,如果形式化器 A 的八条陈述中有五条有效,形式化器 B 的八条陈述中有三条有效,我们分别从每个形式化器中随机选择一条。如果一个形式化器没有生成任何有效陈述,则排除该问题的所有陈述。表 2 汇总了对两个形式化器进行的每项测试的统计数据。
除了形式化开源的 Numina(Li 等,2024a)数据集中的 860K 条非形式化陈述外,我们还形式化了来自 Art of Problem Solving(AOPS)的 68K 条数学问题的私有集合,这些数据由 Numina 团队(Li 等,2024a)收集和处理。在总共 928K 条非形式化陈述中,有 760K 条由形式化器 A 和 B 生成了两条有效的形式化陈述,而 123K 条只包含一条有效的形式化陈述。在形式化了 Numina 和 AOPS 数据集之后,我们进一步加入了 Lean Workbook(包括 Lean Workbook Plus)中的 140K 条陈述。因此,我们总共拥有 178 万条形式化陈述。
专家迭代
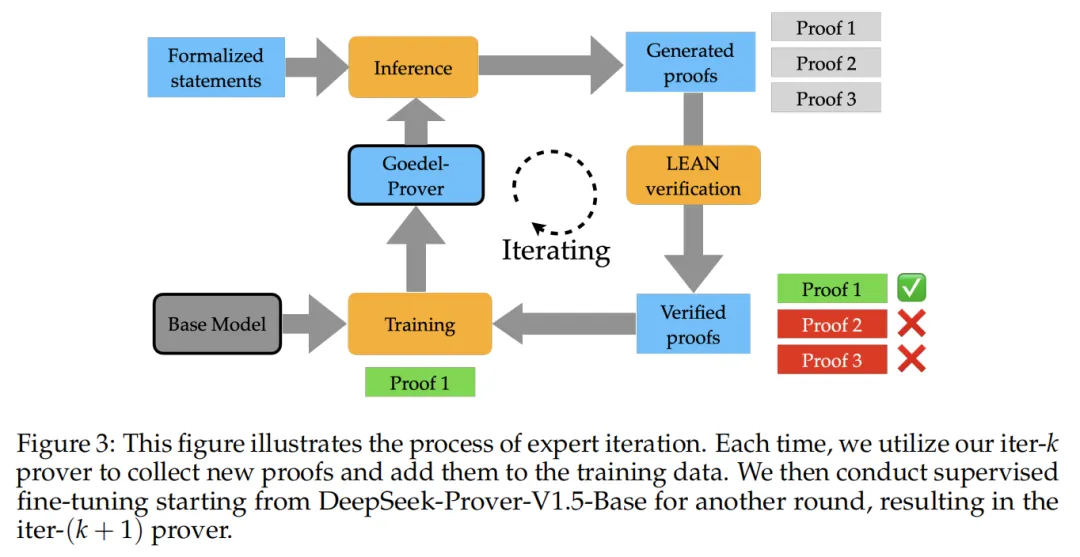
在第 3.1 节中获得大量形式化陈述后,我们采用专家迭代(Liu 等,2024;Wu 等,2024;Li 等,2024b)来训练证明器,如图 3 所示。具体来说,我们首先使用 DeepSeek-Prover-V1.5-RL为每条陈述生成 16 个证明。然后,我们使用 Lean 编译器验证这些证明。如果至少有一个证明解决了该陈述,我们为每条陈述保留一个证明。在有多个证明可用的情况下,我们随机采样一个解决方案。这些收集到的证明用于基于 DeepSeek-Prover-V1.5-Base的监督微调(SFT),从而得到 iter-1 证明器。我们继续这一专家迭代过程;每次,我们都使用 iter-k 证明器生成答案,并累计收集正确解决方案以训练 DeepSeek-Prover-V1.5-Base,用于下一次迭代,即 iter-(k + 1) 证明器。更多关于每次迭代的细节,请参阅附录 A。
我们尝试了 1×10⁻⁴ 和 5×10⁻⁵ 的学习率,训练 1 或 2 个 epoch。我们使用小批量大小 8 的打包技巧(Tunstall 等,2022)来加速训练。在每次迭代中,使用 4 个 H100 GPU,1 个 epoch 的训练时间约为 12 小时。对于 178 万条陈述集,使用 64 个 H100 GPU,Pass@16 的推理时间为 6 小时。此外,验证这些证明需要 8,000 个 CPU,耗时 10 小时。
miniF2F(Zheng 等,2021)是一个形式化定理证明基准,包含 488 条问题陈述(244 条验证问题和 244 条测试问题),使用 Lean 编写。这些问题来自高中练习题,以及高中水平的竞赛,包括 AIME、AMC 和国际数学奥林匹克竞赛(IMO)。原始基准是在 Lean 3 中发布的,为了我们的分析,我们使用了 Xin 等(2024a)提供的 Lean 4.9.0 版本的 miniF2F。
ProofNet(Azerbayev 等,2023)是一个本科水平数学的形式化定理证明基准,包含 371 条问题陈述(185 条验证问题和 186 条测试问题),使用 Lean 编写。这些问题主要来自本科纯数学科目,涵盖实分析、复分析、线性代数、抽象代数和拓扑学等主题。原始基准是在 Lean 3 中发布的,为了我们的分析,我们使用了 Xin 等(2024a)提供的 Lean 4.9.0 版本的 ProofNet。
Lean Workbook(Ying 等,2024a)是一个从自然语言数学问题(主要来自 AOPS 论坛)形式化的大型 Lean 4 问题集,包含 140K 条 Lean 4 陈述。我们还监控了在专家迭代过程中我们的模型解决的问题。值得注意的是,Lean Workbook 的问题集包含在训练中,这与 DeepSeek-Prover-V1.5(Xin 等,2024a)和 InternLM2.5-StepProver(Wu 等,2024)一致。
PutnamBench(Tsoukalas 等,2024)是一个基于威廉·洛厄尔·普特南数学竞赛(1962 - 2023 年)的竞赛数学问题的形式化定理证明基准。PutnamBench 包含 644 条 Lean 4 陈述,涵盖代数、分析、数论、几何、组合学、概率和集合论等主题。
NuminaTest. 我们从形式化的 Numina 数据集中随机抽取 250 条陈述,将其用作保留的测试集。我们称这个子集为 NuminaTest。
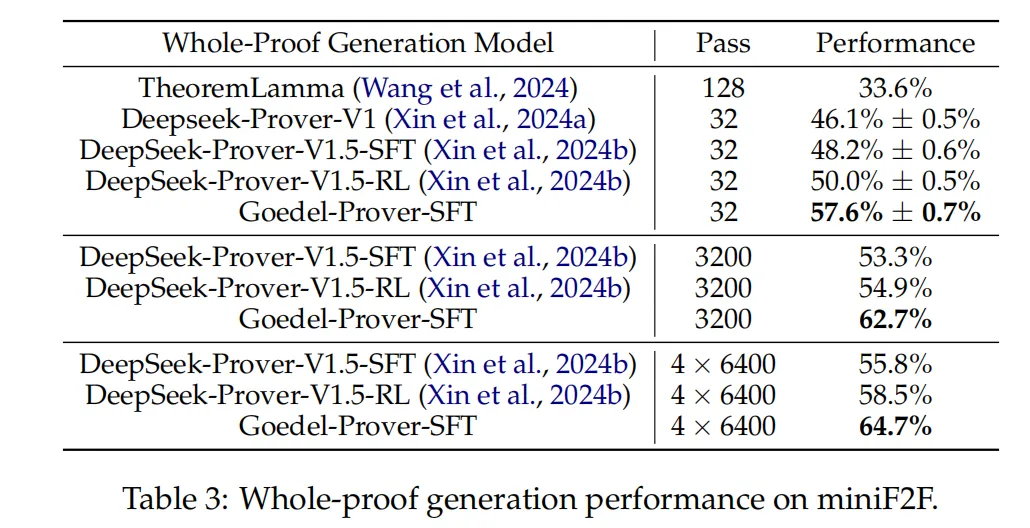
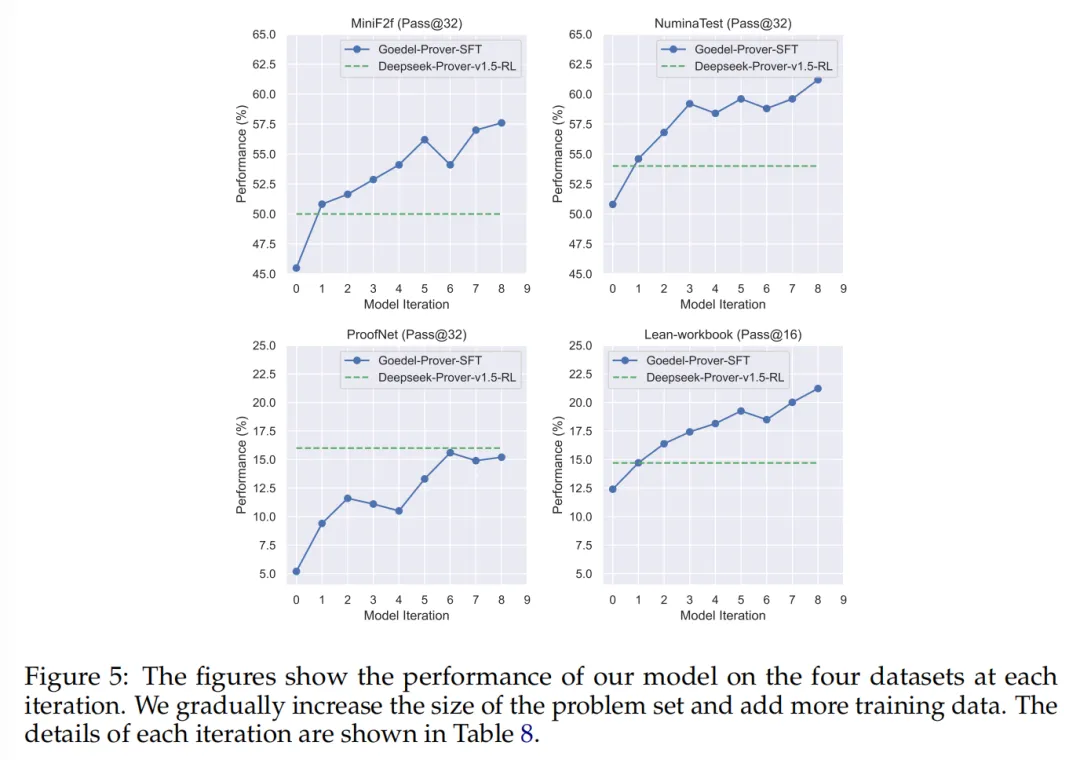
主要结果. miniF2F 上的表现如表 3 所示。我们的 Goedel-Prover-SFT 的 Pass@32 表现为 57.6%,超过了之前的 SOTA 开源模型 DeepSeek-Prover-V1.5-RL 7.6%。我们发现,Goedel-Prover-SFT 的 Pass@32 甚至比 DeepSeek-Prover-V1.5-RL 的 Pass@3200 高出 2.7%。此外,当两者都以 Pass@3200 评估时,我们的模型达到了 62.7%,超过了 DeepSeek-Prover-V1.5-RL 的 54.9%,高出 7.8%。图 1 展示了我们的 Goedel-Prover-SFT、DeepSeek-Prover-V1.5-RL 和 DeepSeek-Prover-V1.5-SFT 的推理时间扩展曲线。Goedel-Prover-SFT 在所有推理计算预算下,都显著优于 DeepSeek-Prover-V1.5-RL 和 DeepSeek-Prover-V1.5-SFT。图 5 展示了我们的模型在每次迭代中的表现。总体而言,我们观察到在迭代过程中表现有相对一致的提升。
PutnamBench 表现:Goedel-Prover-SFT 在 PutnamBench 上解决了 644 个问题中的 7 个(Pass@512),在 PutnamBench 排行榜上位居第一。之前表现最好的方法是 ABEL(Gloeckle 等人提出),它以略高的推理预算(Pass@596)解决了 7 个问题,而 InternLM2.5-Step-Prover(Wu 等,2024)解决了 6 个(Pass@2×32×600)。表现总结在表 4 中。
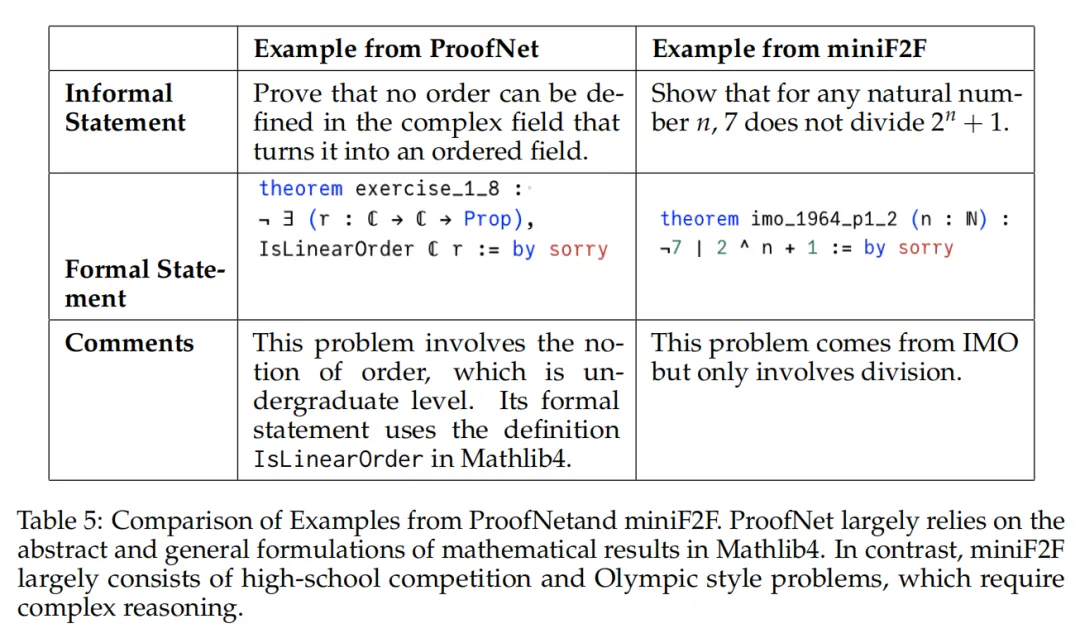
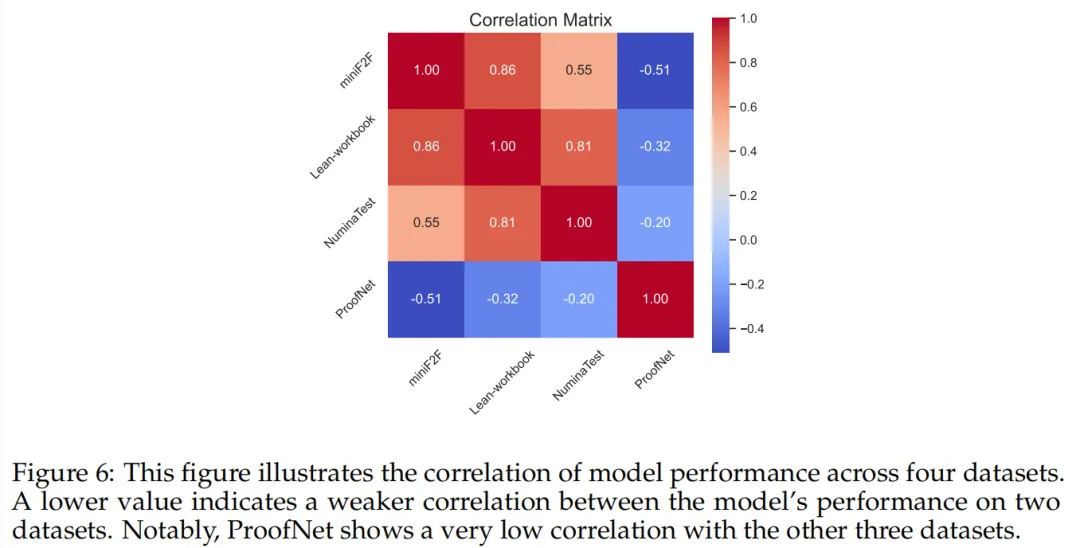
ProofNet 表现:我们发现 ProofNet 上的表现与 miniF2F、Lean Workbook 和 NuminaTest 的表现相关性非常低。具体来说,图 6 展示了模型在这四个数据集上的表现相关性。模型在 NuminaTest、miniF2F 和 Lean Workbook 上的表现呈现出强烈的正相关性,而其在 ProofNet 上的表现与其他三个数据集的相关性显著较低。我们还观察到 ProofNet 的数据分布与其他三个数据集有显著差异。ProofNet 中的问题主要来自本科纯数学科目的教科书,涵盖实分析、复分析、线性代数、抽象代数和拓扑学等主题。这些问题在很大程度上依赖于 Mathlib4(mathlib4,2023)中数学定义的抽象和一般表述。其他数据集,例如 miniF2F,主要包含竞赛和奥林匹克风格的问题,这些问题需要复杂的推理,但只依赖于关于整数、实数、计数和几何的一组相对较小的基本事实。我们在表 5 中展示了两个例子,以说明 ProofNet 和 miniF2F 之间的风格差异。
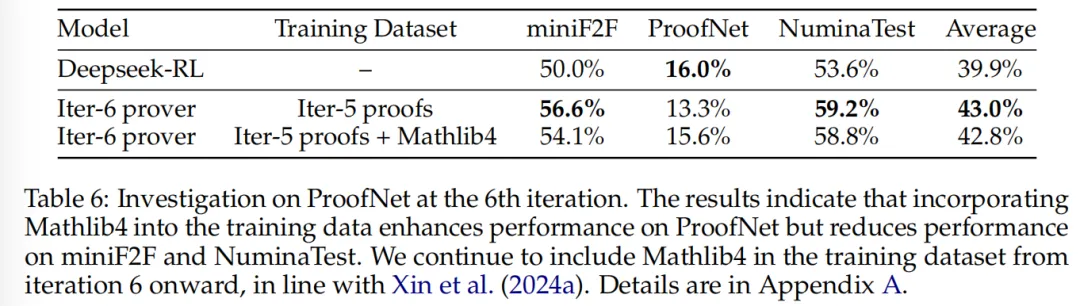
在训练数据中包含 Mathlib4鉴于 Mathlib4 与 ProofNet 之间的紧密联系,我们按照 Xin 等(2024b)和 Wang 等(2024)的方法,研究了将 Mathlib4 包含在训练数据集中的影响。我们在表 6 中的结果表明,虽然添加 Mathlib4 提高了模型在 ProofNet 上的表现,但同时也导致了 miniF2F 表现的下降。具体来说,我们在第六次迭代期间分析了将 Mathlib4 纳入训练集的影响,第五次迭代生成的证明被称为“Iter-5 证明”。我们观察到,包含 Mathlib4 使 ProofNet 的表现从 13.3% 提升到 15.6%,但导致 miniF2F 的表现从 56.6% 下降到 54.1%,以及 NuminaTest 的表现从 59.2% 下降到 58.8%。从第六次迭代开始,我们继续将 Mathlib4 包含在训练数据集中,这与 DeepSeek-Prover-V1.5-RL(Xin 等,2024b)和 TheoremLamma(Wang 等,2024)保持一致。更多细节可以在附录 A 中找到。
在 Lean Workbook 中找到的证明Lean Workbook(包括 Lean Workbook-plus,Ying 等,2024a;Wu 等,2024)形式化了 140K 条来自 AOPS 和 Compfiles 数据的高质量问题。目前,Lean Workbook 中只有 15.7K 条陈述的证明被 InternLM2.5-StepProver(Wu 等,2024)和 InternLM-Math-Plus(Ying 等,2024b)找到并开源。相比之下,我们的模型在 Lean Workbook 中发现了一个更庞大的证明集合,累计解决了 29.7K 个问题。图 1(右)展示了我们的模型和先前工作找到的证明数量的对比。我们开源了我们的模型找到的所有证明,以造福研究社区。
我们深入探讨了 Goedel-Prover-SFT 生成的证明的特征,并讨论了潜在的改进方向,特别是在模型采用的证明风格、搜索以及在线互动在证明生成中的作用,以及外部符号计算工具(如 SymPy)的整合方面。