最近,西工大音频语音与语言处理研究组(ASLP@NPU)与南洋理工大学(NTU)合作的论文 “GenSE: Generative Speech Enhancement via Language Models using Hierarchical Modeling” 被深度学习领域国际顶级会议ICLR2025录用,本文提出了一种新颖的基于语言模型(LM)的生成式语音增强框架,名为 GenSE,旨在通过利用LM来建模语音中的语义信息提升语音增强的鲁棒性和效果,现对该论文进行简要的解读和分享。
论文题目:GenSE: Generative Speech Enhancement via Language Models using Hierarchical Modeling
作者列表:姚继珣,刘和鑫,陈晨,胡宇晨,Eng Siong Chng,谢磊
合作单位:南洋理工大学
论文预印版:https://arxiv.org/pdf/2502.02942
Demo:https://yaoxunji.github.io/gen-se
代码:https://github.com/yaoxunji/gen-se
语音增强(Speech Enhancement, SE)是语音信号处理领域的重要任务,旨在从受噪声干扰的语音信号中恢复出清晰量的语音。传统的语音增强方法通常将任务视为连续信号的回归问题,即通过学习从噪声语音到干净语音的确定性映射,或者通过建模干净语音的分布来实现增强 [1,2]。然而,这些方法往往忽略了语音信号中蕴含的丰富语义信息,而这些信息对于提升语音的清晰度、说话人一致性以及整体信号质量至关重要[3,4]。在现实场景中,语音信号常常受到各种噪声的干扰,例如背景噪声、混响等。人类在嘈杂环境中能够通过上下文线索和语言模式等语义信息,重建被噪声掩盖的语音内容。然而,传统语音增强方法由于缺乏对语义信息的建模,在复杂噪声条件下或面对未知场景时,性能往往会显著下降。例如,当噪声类型与训练数据中的噪声分布不一致时,传统方法可能无法有效去除噪声,甚至会导致语音失真或语义信息的丢失。近年来,语言模型(Language Model, LM)在自然语言处理(NLP)任务中展现了强大的语义建模能力。通过将语言模型引入语音增强任务,可以更好地利用语音中的语义信息,从而在噪声去除的基础上,进一步提升语音的重建质量。具体来说,语言模型能够通过离散标记(tokens)的方式对语音进行建模,其中语义标记捕捉语音的高层信息(如语音、语法和语义),而声学标记则负责捕捉语音波形的细节信息。通过将语音增强任务转化为条件语言建模问题,语言模型可以在生成过程中更好地保留语音的语义结构和说话人特征。本文提出了GenSE,一个基于语言模型和分层建模的生成式语音增强框架。GenSE通过引入SimCodec和分层建模框架,显著提升了语音增强的质量和泛化能力。SimCodec通过码本重组技术减少了声学标记的数量,降低了语言模型的预测难度;而分层建模框架则将去噪和生成过程解耦,确保噪声不会影响语音生成阶段,从而提高了增强语音的稳定性和质量。
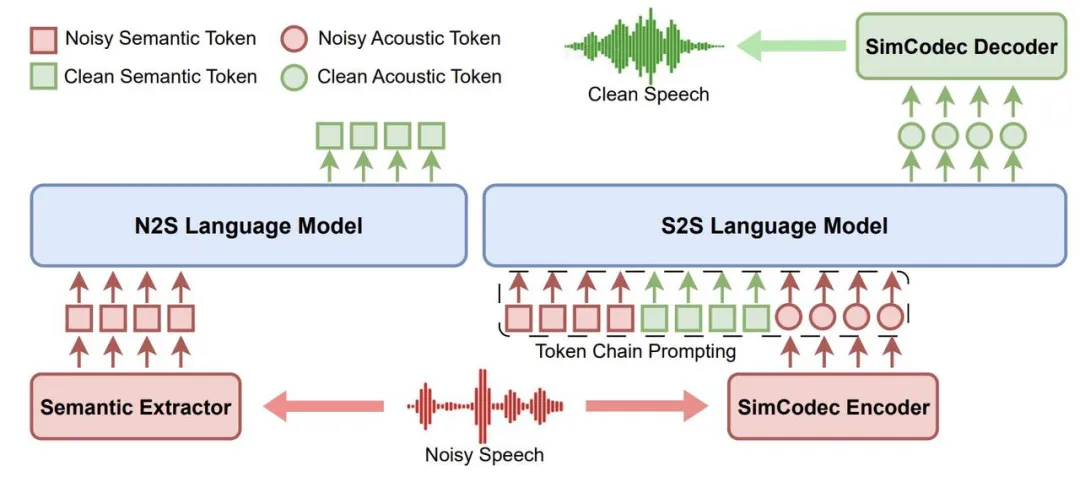
模型架构:如图1所示,GenSE 包含四部分:语义提取器,单码本的音频编码器,噪声到语义语言模型(N2S)和语义到语音语言模型。语义提取器用来从噪声音频中提取语音标记,N2S语言模型将噪声语义标记转换为干净语义标记,S2S语言模型将结合声学标记和语义标记生成干净的声学标记,最终通过音频编码器将生成的声学标记转换为语音信号。图1 提出的GenSE框架
分层建模框架:GenSE的核心创新是其分层建模框架,该框架将语音增强任务分解为两个阶段:噪声到语义模块和语义到语音模块。这种分阶段的设计不仅提高了生成过程的稳定性,还确保了增强语音的音色一致性。- 语义标记提取:N2S模块首先利用预训练的自监督模型(如XLSR)从噪声语音中提取语义标记。这些语义标记捕捉了语音的高层信息(如语音、语法和语义)。
- 去噪过程:通过语言模型,N2S模块将噪声语义标记转换为干净语义标记。这一过程通过自回归建模实现,确保语义标记的生成与语音的时序结构保持一致。
- 声学标记生成:S2S模块负责将干净语义标记转换为干净声学标记。为了确保生成语音的音色一致性,GenSE引入了令牌链提示机制。具体来说,S2S模块将干净语义标记、噪声语义标记和噪声声学标记拼接在一起,作为生成过程的提示信息。这种设计使得生成语音能够保留原始说话人的音色特征。
- 语音重建:生成的声学标记通过SimCodec的解码器重建为最终的增强语音信号。
通过将去噪和生成过程分离,N2S模块专注于去除噪声对语义标记的影响,而S2S模块则专注于生成高质量的语音信号。这种设计降低了语言模型的预测难度,提高了生成过程的稳定性。数据集:训练数据使用了 LibriLight、LibriTTS、VoiceBank 和深度噪声抑制(DNS)挑战数据集的子集作为干净语音数据。噪声数据集则使用了 WHAM! 和 DEMAND1,为了模拟混响,从 OpenSLR26 和 OpenSLR28 中随机选择房间脉冲响应(RIR)。所有训练数据都是动态生成的,有 80% 的概率在 -5 dB 到 20 dB 的信噪比(SNR)范围内添加噪声,并且有 50% 的概率将语音与 RIR 进行卷积。测试数据使用了DNS 挑战数据集的测试集来比较 GenSE 与现有最先进的基线系统。此外,还使用了 CHiME-4 数据集作为额外的测试集,以评估模型的泛化能力。所有样本的采样率均为 16kHz。
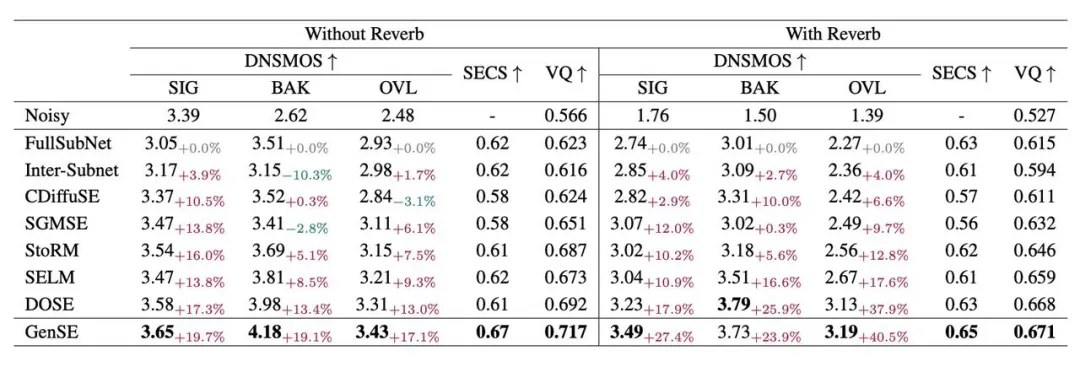
我们首先评估了GenSE在DNS测试集上的效果,实验结果如表1所示。在无混响条件下,enSE显著优于所有基准系统,特别是在DNSMOS、SECS和VQ评分上。GenSE的DNSMOS得分为3.65,较基准系统提升了约19.7%,显示出它在噪声消除和语音质量恢复方面的优势。即使在存在混响的情况下,GenSE依然表现突出,其DNSMOS得分为3.49,比其他系统提高了约27.4%,VQ评分和SECS也有所提升,证明其在复杂环境下的稳定性和可靠性。
表1 DNS数据集对比结果
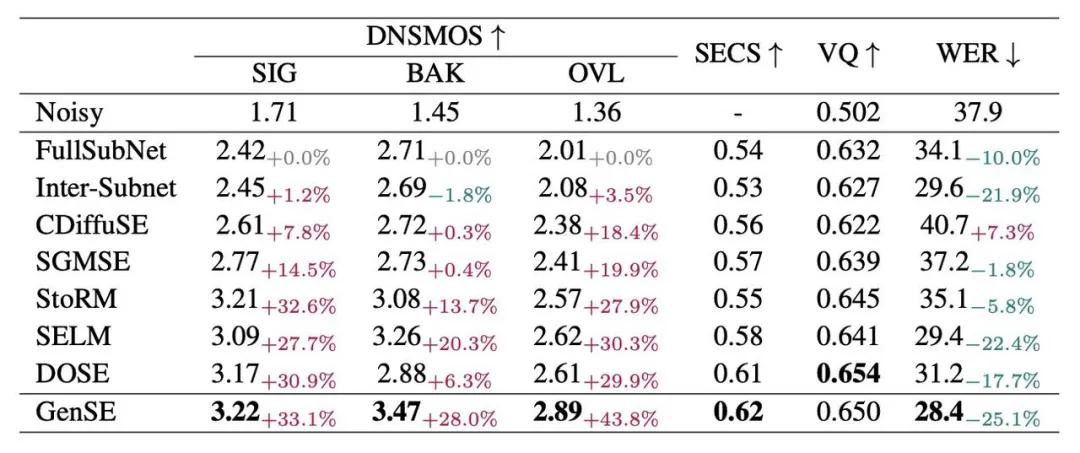
我们进一步评估了GenSE在不同领域(如街道、餐厅等)的泛化能力。使用CHiME-4数据集进行测试,结果如表2所示,GenSE能够有效适应不同噪声环境,在DNSMOS、SECS和WER等指标上均表现优异,尤其是在处理未知噪声环境时,它的表现优于基于确定性模型的基准系统。在这些环境下,GenSE显示出较好的说话人一致性和语音清晰度,尤其是在与其他基准模型比较时,GenSE的WER得分最低,表明它能更好地保持语音的可懂度和语言信息。
表2 CHiME-4数据集对比结果
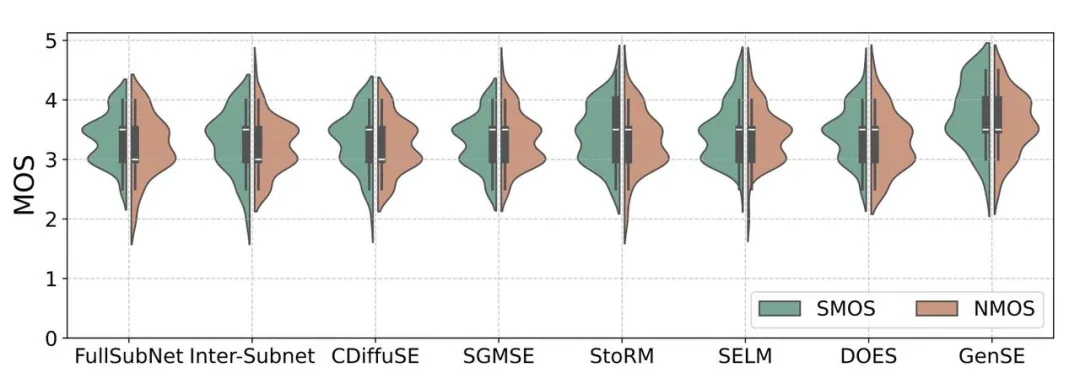
同时,我们还使用平均意见得分作为主观指标,进一步对比GenSE和基线系统。我们使用小提琴图来展示主观结果,如图2所示。GenSE在主观测试中表现优异,其NMOS(自然度评分)和SMOS(相似度评分)显著高于所有其他基准系统。参与者普遍认为GenSE增强后的语音更自然、清晰,且与干净语音更加接近。
图2 主观指标对比小提琴图
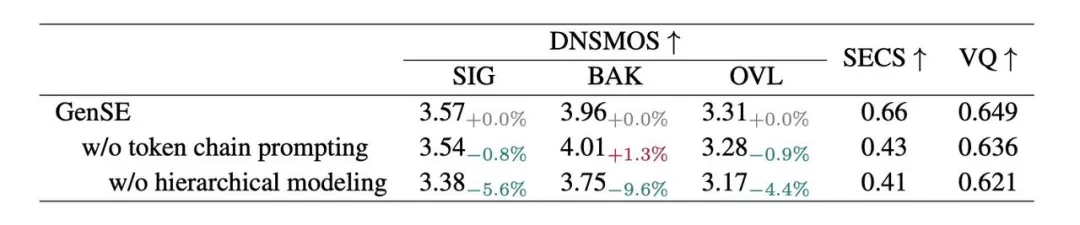
最后,我们进行消融实验,验证所提出的层次化建模的有效性,实验结果如表3所示。如果去除Token链提示机制,GenSE的说话人一致性得分会显著下降,表明该机制对保持语音增强后的说话人一致性至关重要。去除层次化建模后,DNSMOS得分显著下降,说明分层建模能够有效减少语音增强过程中的预测难度,提高生成稳定性。消融实验的结果进一步证明了所提出组件在整体框架中的有效性。
表3 消融实验结果
GenSE在各类环境和任务中表现突出,特别是在复杂噪声和混响条件下,展示了其强大的语音增强能力和泛化能力。相较于现有的最先进的SE方法,GenSE在语音质量、说话人一致性、噪声消除和泛化能力等方面均有显著提升。这些实验结果证明了语言模型在生成性语音增强中的潜力,尤其是将语义信息引入语音增强过程中。
参考文献
[1] Richter J, Welker S, Lemercier J M, et al. Speech enhancement and dereverberation with diffusion-based generative models[J]. IEEE/ACM Transactions on Audio, Speech, and Language Processing, 2023, 31: 2351-2364.[2] Fu S W, Liao C F, Tsao Y, et al. Metricgan: Generative adversarial networks based black-box metric scores optimization for speech enhancement[C]//International Conference on Machine Learning. PmLR, 2019: 2031-2041.[3] Wang Z, Zhu X, Zhang Z, et al. SELM: Speech enhancement using discrete tokens and language models[C]//ICASSP 2024-2024 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2024: 11561-11565.[4] Kato M, Baese-Berk M M. The effects of acoustic and semantic enhancements on perception of native and non-native speech[J]. Language and Speech, 2024, 67(1): 40-71. 
 语音小管家