
 语音小管家
近日,香港科技大学、出门问问、西北工业大学、上海交通大学、南洋理工大学等研究机构,重磅推出新一代语音生成模型 Spark-TTS。该模型完全基于Qwen2.5架构,摒弃额外生成模型辅助,以单阶段、单流方式实现 TTS 生成,具备超自然的语音克隆与跨语种生成能力,还支持用户根据需求定制专属声音。目前,Spark-TTS已经在开源社区SparkAudio发布,迅速登上Hugging Face趋势榜TTS第二,目前仍在持续攀升中。
论文题目:Spark-TTS: An Efficient LLM-Based Text-to-Speech Model with Single-Stream Decoupled Speech Tokens
全新语音编码范式,充分释放大语言模型潜力
单码本的语义 token需要经过多个阶段才能生成声学特征,在大语言模型的自回归建模过程中,难以对音色等属性进行精准控制。 声学编码通常依赖多个码本,导致模型设计复杂化,同时缺乏与语义的强关联性,增加了预测的不确定性和难度。
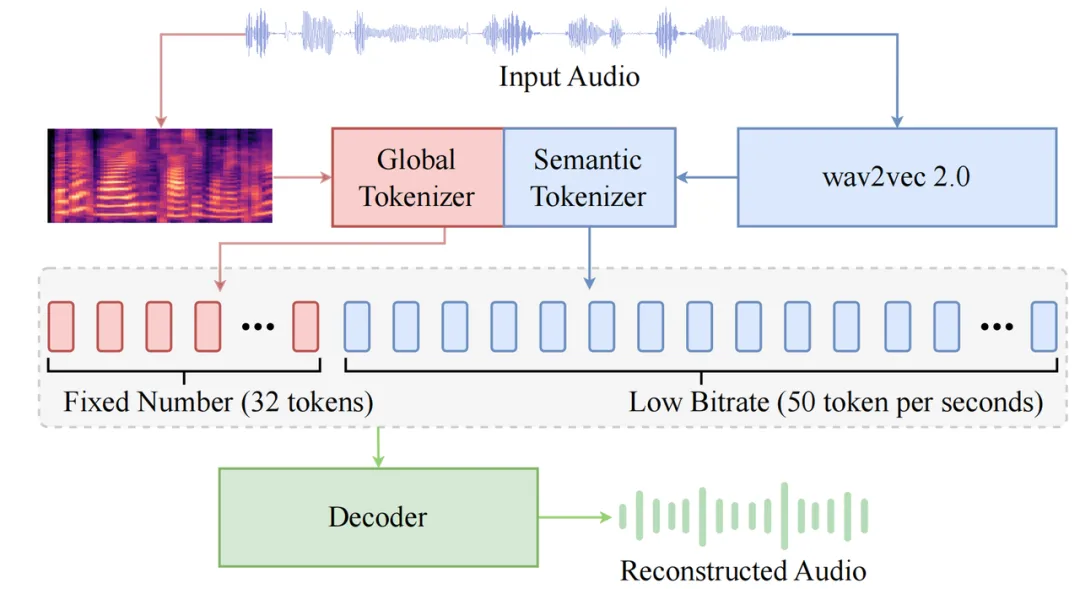
图1 BiCodec示意图
Global Token 负责建模时序无关的全局特征(如音色),确保语音生成的全局可控性。 Semantic Tokens 以 wav2vec 2.0 提取的特征为输入,编码与文本紧密相关的信息,确保语义的强相关性。
简洁建模,与文本LLM结构高度统一
统一的模型结构:直接复用Qwen2.5的原生架构,并扩展其Tokenizer以支持语音相关 token,使Spark-TTS的建模方式与文本建模高度一致。 属性控制:通过引入属性标签(如性别、基频等级)和细粒度属性值(如精确基频),Spark-TTS以文本+属性标签为输入,采用链式思考(CoT, Chain of Thought)的方式,依次预测细粒度属性值 → Global Tokens → Semantic Tokens,从而实现高度可控的音色生成。
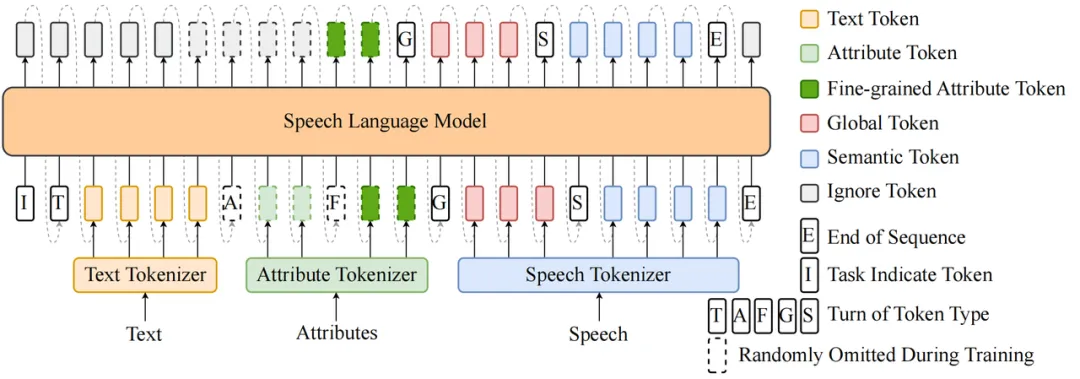
图2 Spark-TTS的语言模型示意图
