
 语音小管家
来源丨AI音频时代
2024年Sora的发布开启了AIGC新时代。 AIGC技术在文字、图像、视频、音频等领域实现跨越式发展。其中,TTS技术从少数巨头垄断走向百花齐放,底层技术和应用场景均取得重大突破。以下是整理的当下具有代表性的 10 个中文 TTS。
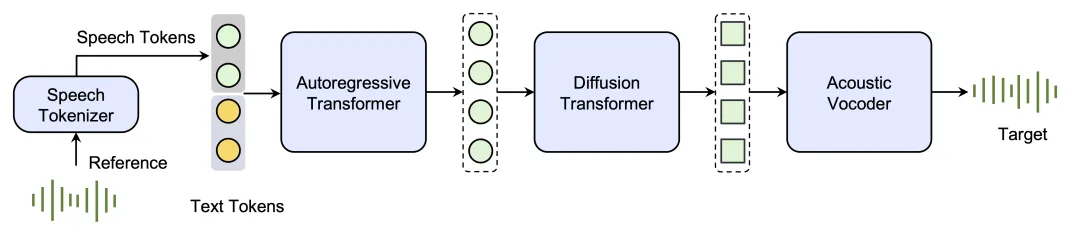
Seed-TTS:由字节跳动开发的的语音合成系统,支持多种语言,能处理各种文本类型,可生成带有不同情感和语境细微差别的同语言或跨语言语音。
优势:
多语言与跨语言能力:支持多语言合成与跨语言转换,适用于全球客服、语言学习等场景,如快速生成多语种产品介绍。
情感与语境感知:能根据文本内容调整语音情感(如喜怒哀乐),提升有声读物、对话等场景的沉浸感。
文本类型兼容性强:适配新闻、对话、诗歌等多样文本,生成自然流畅的语音,扩展内容创作可能性。
领先技术保障:依托字节跳动技术团队,采用先进深度学习模型,确保合成语音的高质量与稳定性。
局限:
专业领域适配待优化:医学、法律等专业术语的发音和语感还原度有限,需进一步优化。
极端场景覆盖不足:难以模拟特殊环境语音失真或生僻方言发音,灵活性有待提升。
数据依赖性较强:对小众语言或新兴口音的合成效果受限于训练数据覆盖范围。
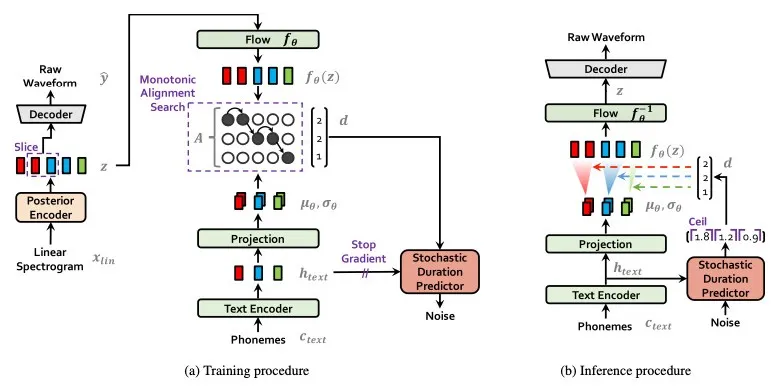
基于 SoVITS(Singing Voice Conversion)技术与 GPT 相关能力结合的语音合成项目,在 AI 音频领域展现出独特优势,同时也面临一些挑战:
优势
零样本语音克隆:仅需少量文本即可高精度克隆目标音色,显著降低数据依赖,提升克隆效率。
多语言支持:兼容中文等主流语言,满足全球化应用需求。
开箱即用工具包:提供易用集成方案,助力开发者快速接入语音助手、有声读物等场景。
局限
自然度不足:长文本合成时韵律、停顿偶显生硬,流畅度较真人语音仍有差距。
情感表达局限:复杂情绪(如微妙喜怒)的语音呈现不够精准,影响情感共鸣。
版权与伦理风险:声音克隆可能引发侵权问题,存在伪造声音进行诈骗等滥用隐患。
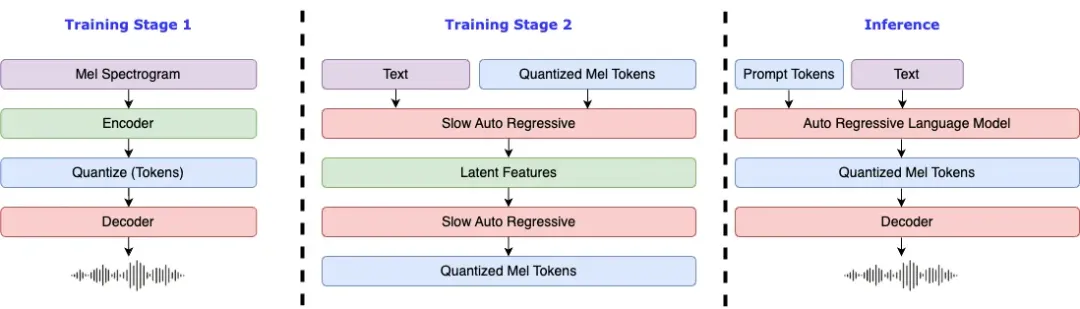
Fish Speech 以稳定性和卓越的语音克隆能力闻名,经过 300,000 小时的中文等多语言音频数据训练,适用于需要高稳定性语音合成的场景。
优势:
开源共享:代码和模型开源,全球开发者可共同参与和贡献,推动技术发展,也方便用户根据自身需求进行定制和改进。
平台友好:提供在线平台,无需技术基础也能轻松体验 AI 语音合成。有 “发现”“语音合成”“构建声音”“我的声音” 等模块,操作简单。
可集成性强:提供 API 接口和 SDK,便于集成到各种应用程序、网站、游戏或智能设备中,拓展了应用场景。
多语言支持:涵盖中文、英语和日语等多种语言,满足了不同语言用户的需求,方便在全球范围内应用。
语音克隆出色:用户只需提供一段参考语音,就能快速进行语音克隆,无需复杂训练过程,为内容创作者等提供了便利。
低显存需求:仅需 4GB 显存即可推理,8GB 用于微调,对硬件要求低,降低了使用门槛,普通个人设备也能轻松运行。
个性化定制:提供丰富的音色库,有明星、游戏角色、动漫人物等多种音色可供选择,还支持用户根据喜好调整语速、音调、音色等,创建专属虚拟声音角色。
采用高效算法:运用 Flash-Attn 算法,在处理大规模数据时效率高、准确性和稳定性强,极大提升了 TTS 性能。
集成多种技术:集成 VQGAN、Llama 和 VITS 等先进技术,实现了文本到语音的高级别转换质量,增强了语音的自然度和真实感。
局限:
情感精准度不足:尽管整合了 Text2Semantic 模型,但在一些复杂情感的精准表达上可能仍有欠缺,与人类自然语音在情感细腻度上存在一定差距。
语音自然度瑕疵:在某些特殊语境或特定发音上,生成的语音可能还存在一些不自然的地方,如一些连读、变调等细节处理可能不够完美。
适用场景有限:主要集中在文本转语音和语音克隆领域,对于一些更复杂的语音交互任务,如实时语音对话中的多轮交互、语音理解后的深度语义分析等,功能相对较弱。
ChatTTS:专注于具有详细韵律的对话式 TTS,支持中文和英文,在生成逼真且细致入微的多说话人对话方面表现出色。
优势:
对话场景优化:专门为对话场景设计,能根据上下文调整语气和情感,使生成的语音在对话中更加连贯、自然,富有表现力,为用户带来沉浸式的对话体验,更贴近真实的人际交流。
韵律调控精准:可以精准预测并细致调控语音中的韵律特征,如笑声、停顿和插入语等,在韵律表达上超越了许多现有的开源 TTS 模型,让语音更生动。
模型先进:采用先进的自回归模型和细粒度声学特征预测技术,实现了高质量和自然度的语音合成。
开源共享:项目开源,代码和预训练模型资源可获取,开发者能在其基础上进行深入开发和创新应用,推动语音合成技术发展。
体验方式多样:提供在线体验功能,用户可在网页上输入文本生成语音文件;也支持本地安装,方便有高级定制需求的用户;还有 Windows 环境下的一键启动包,降低了使用门槛。
社区活跃:在 GitHub 等平台上拥有活跃的社区,用户可以方便地获取技术支持、分享经验,共同推动模型的发展,也会有持续的更新和优化。
多语言支持:全面支持中文和英文两种主流语言,为全球各地的用户搭建了无障碍沟通的桥梁,拓宽了应用场景和用户群体。
多说话人模拟:能够呈现不同性别和风格的语音,满足各种场景下对不同说话人声音的需求,为合成效果增添了更多趣味和多样性。
实时合成:具有强大的实时语音合成功能,能在用户输入文本后迅速生成对应的语音,适用于智能客服、在线教育和虚拟助手等需要即时反馈的场景。
局限:
长文本处理短板:目前版本存在生成音频时长限制,处理较长文本时可能出现分词问题,合成质量也可能会受影响,计算资源需求高,算法优化有待提升。
训练数据局限:开源版本使用了 4 万小时的数据,相比一些大规模的 TTS 模型,训练数据量相对较少,可能会影响模型的泛化能力和对一些复杂语言现象的处理。
伦理潜在风险:为防止滥用,开发者在训练过程中添加了少量额外的高频噪音并压低了音质,一定程度上可能会影响语音质量和用户体验,且仍可能存在被恶意利用的风险。
MARS5-TTS:由 CAMB.AI 团队开发的一款先进的语音合成模型,擅长为体育评论和动漫等韵律复杂多样的场景生成语音,可应用于多种动态场景,满足不同场景下的语音合成需求。
优势:
独特的两阶段 AR - NAR 管道:采用自回归(AR)和非自回归(NAR)的两阶段处理流程,AR 阶段生成粗略语音特征,NAR 阶段利用多变量 DDPM 模型细化,使模型在处理复杂韵律场景如体育解说、动漫配音等方面表现出色。
自动编码器与字节对编码:利用自动编码器学习和重建语音信号编码表示,采用字节对编码技术处理文本数据,提高了对文本的处理效率。
简单的加载与调用:通过 <代码开始> torch.hub < 代码结束 > 提供方便的模型加载方式,无需克隆仓库。提供简单的 API 调用方式,开发者可轻松集成到自己的应用中。
开源协作:项目开源,鼓励社区成员参与改进和优化,有活跃的社区,文档齐全,用户可获取技术支持、分享经验。
语音克隆出色:支持浅层推理和深层推理两种方式,深层推理可提供更高输出质量。通过提供 5 秒的音频样本和文本输入,能模仿参考音频的语音特征,实现高质量的语音克隆。
韵律与情感控制佳:能够根据文本中的标点和大写来控制语音的停顿、强调等,还可模拟不同的情感表达,使生成的语音更自然、富有表现力。
多语言支持:虽然专注于英语,但所属团队提供多语言的 TTS 解决方案,且模型本身也支持 140 多种语言,适用范围广泛。
局限:
硬件要求高:需要至少 20GB 的 GPU VRAM 来运行,对硬件配置要求较高,可能限制了一些用户的使用,增加了使用成本。
输入条件限制:语音合成的质量依赖于参考音频质量和转录文本的准确性,若参考音频质量不佳或文本不准确,会影响最终的语音输出质量。
功能有待完善:目前只能识别并生成单人的语音片段,无法生成对话音频,在一些需要多人对话的应用场景中存在局限性。
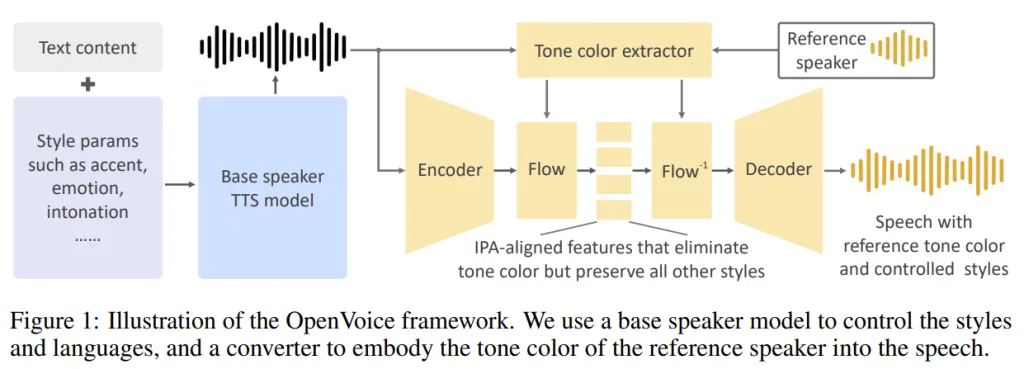
OpenVoice 是麻省理工学院(MIT)和 MyShell 联合开发的开源即时语音克隆项目,一种多功能的即时语音克隆方法,只需要来自参考说话人的简短音频剪辑即可复制他们的语音并生成多种语言的语音。OpenVoice 还可以对语音风格进行精细控制,包括情感、口音、节奏、停顿和语调。
优势:
精确的音色克隆:能够准确克隆参考语音的音色,在音调、音质、情感等方面高度还原原声,可在不同语言和口音之间生成高度一致的语音内容。比如,在制作多语言有声读物时,能将原作者的声音特点精准克隆到不同语言版本中。
灵活的语音风格控制:允许用户对语音风格进行细粒度控制,包括情感、口音、语速、停顿和语调等。用户可以根据具体需求,将语音设置为欢快、悲伤、严肃等不同情感风格,或者调整为不同地区的口音。
零样本跨语言语音克隆:无论生成语音的语言,还是参考语音的语言,都不需要在庞大的多语种训练数据集中出现。即使训练数据集中没有包含某些语言,也能实现这些语言之间的语音克隆,为跨语言交流和语音应用的全球化提供了便利。
局限:
自然度不足:克隆语音在语调、韵律方面仍显生硬,长文本时更明显。
情感表达局限:复杂情绪(如微妙喜怒)的呈现不够精准。
版权风险:存在声音侵权和恶意伪造的伦理隐患。
EmotiVoice(易魔声)是网易有道开源并维护的一款功能强大且现代的开源文本转语音(TTS)引擎,原生支持包括中文在内的多种语言,提供灵活的语音风格控制和零样本跨语言语音克隆功能,方便在不同语言和风格之间切换。
优势:
双语言支持:支持中英文两种语言的文本转语音,在处理包含多种语言的文本时,能够准确地将其转换为相应语言的语音,满足不同语言场景的需求。
音色丰富:拥有超过 2000 种不同的音色,包括男声、女声、童声等多种类型,用户可以根据需要选择合适的音色进行语音合成。
情感合成:特色功能之一是情感合成,允许用户通过简单的提示词实现情感的切换,如快乐、兴奋、悲伤、愤怒等,使合成的语音更具表现力和感染力。
用户友好界面:提供了简洁直观的网页界面,用户可以轻松上手,无需复杂的设置即可进行语音合成。
批量语音生成 API:除网页界面外,还配备了批量语音生成的 API,方便开发者将其集成到自己的项目中,实现自动化的语音合成功能。
应用前景较广:在语音助手、在线教育、有声读物、广告配音等多个领域具有广泛的应用前景,能够提供高质量的语音合成服务,满足用户的多样化需求。
局限:
声音预览缺失:EmotiVoice 不支持声音预览,用户在选择语音包时无法提前试听,只能凭运气或经验选择,这可能会浪费用户的时间和精力,影响使用体验。
音色标注不准确:部分音色的性别标注可能存在错误,用户需要自己试听来判断,这也给用户选择合适的音色带来了不便。
对运行环境要求较高:EmotiVoice 的本地部署包较大,需要足够的存储空间进行下载和解压。并且,为了达到最佳使用体验,建议使用拥有 NVIDIA GPU 的 PC 进行本地部署,因为 GPU 性能将影响语音合成的效率,这对于一些没有高性能 GPU 的用户来说,可能无法充分发挥该软件的功能。
文本处理存在局限:当文本含有中英文混搭、阿拉伯数字或标点符号过多时可能会报错,对复杂文本格式的处理能力有待提高。
情感识别准确性有待提升:尽管 EmotiVoice 具有情感合成功能,但人工智能在理解和识别情感表达方面仍然存在一定的局限性,可能无法完全准确地把握和合成一些复杂、隐晦的情感。
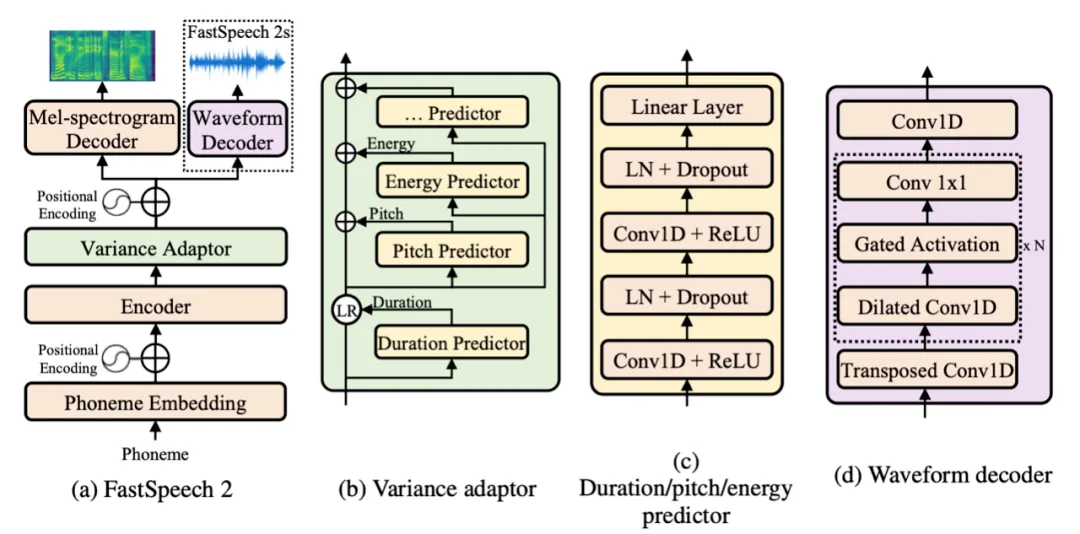
PaddleSpeech 是百度AI开发的一个基于飞桨深度学习框架开发的开源语音处理工具集,提供了基于 FastSpeech2 声学模型和 HiFiGAN 声码器的中文流式语音合成系统。
优势:
易用性强:提供命令行界面、服务器 API 和流式处理等多种使用方式,还有详细的文档和示例代码,方便开发者快速上手,降低了语音处理技术的使用门槛。
功能丰富多样:集成了语音识别、语音合成、语音分类、声纹识别、语音翻译、标点恢复以及语音前端处理等多项先进语音技术,能满足不同行业和领域的多样化需求。
性能出色:采用业界先进的语音模型和算法,经过大量数据训练和优化,在准确性和效率上表现优异,能够快速、准确地处理语音任务,为用户提供高质量的语音服务体验。
高度可定制:开放了模型训练和微调的能力,开发者可以根据自身特定的应用场景和数据特点,对模型进行个性化定制,使 PaddleSpeech 更好地适应不同的业务需求,实现定制化的语音处理解决方案。
中文优化显著:针对中文语音处理进行了专门优化,在文本正则化、多音字处理等方面表现出色,能够有效提升中文语音处理的准确性和自然度,特别适合中文语音相关的应用开发。
流式处理能力:支持语音识别和语音合成的流式处理,这使得它在实时交互场景中表现出色,如实时语音聊天、直播语音转文字等,能够满足对实时性要求较高的应用场景需求。
跨平台兼容:能在 Linux、Windows 和 MacOS 等多种操作系统上运行,兼容多种设备和开发环境,如 Python、Jupyter Notebook 等,方便开发者进行实验和调试。
社区支持活跃:拥有强大的开发团队和活跃的社区,持续更新维护,问题响应及时,开发者可以通过参与贡献来帮助推动项目的发展。
局限:
框架容错率较低:在面对一些异常输入或不常见的语音数据时,可能容易出现错误或报错,对输入数据的规范性要求相对较高1。
维护人员有限:开源项目的维护人员数量可能相对有限,这可能导致在处理一些复杂问题或新需求时,响应速度和解决问题的效率受到一定影响1。
不支持 Torch 下二次开发:由于是基于飞桨深度学习框架开发,不能在 Torch 框架下进行二次开发,限制了一些习惯使用 Torch 框架的开发者的选择1。
语音合成自然度和情感表达有待提升:虽然语音合成功能可将文本转化为自然流畅的语音,但在自然度和情感表达方面,与一些专业的商业语音合成系统相比,可能还存在一定的差距,语音可能会显得相对机械,在表达复杂情感时不够细腻和准确。
多语种支持存在挑战:尽管支持多种语言,但在多语种的全面性和语种间切换的无缝衔接上,可能还有提升空间,难以实现像一些专门的多语种语音处理系统那样的流畅切换和高质量合成。
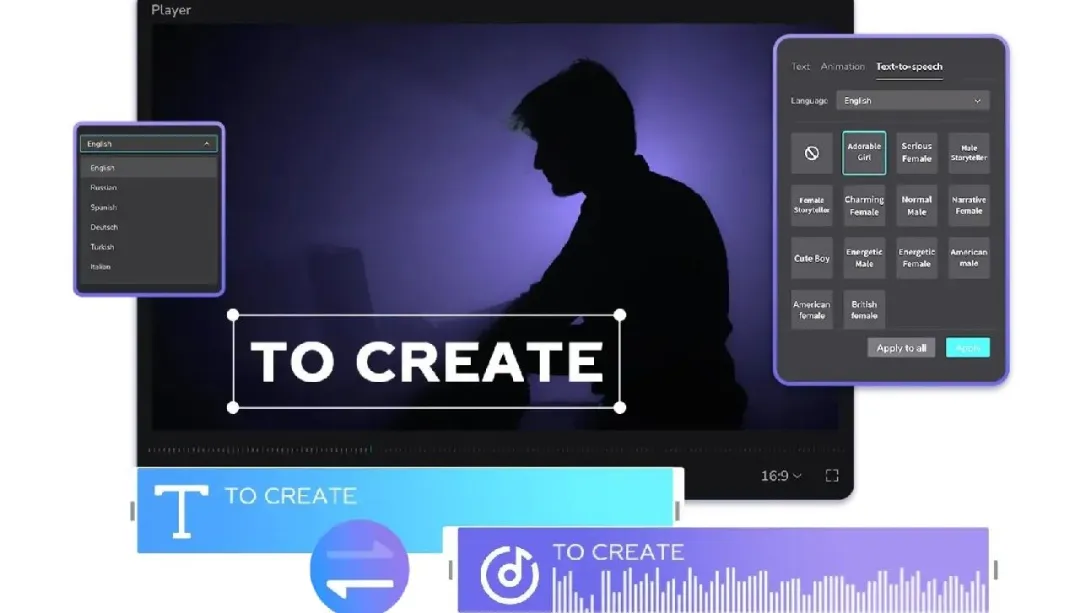
剪映CapCut TTS 是字节跳动AI Lab语音与音频团队开发的语音合成技术。
优势:
超高语音合成质量:采用音素级细粒度韵律建模等先进技术,确保发音精准、清晰自然,可懂度极高。支持17+ 种语言、13+ 种方言、100+ 种真人级音色,同一音色可跨语言演绎,满足多样化需求。
极简操作体验:输入文本 → 选择音色 → 一键合成,支持实时试听与调整,轻松打造理想语音效果。
多格式灵活导出:输出为MP3、WAV等主流音频格式,无缝适配剪辑、配音、短视频创作等场景,无需转码。
深度集成剪映(CapCut):与视频剪辑流程无缝衔接,文本转语音后可直接应用至时间轴,省去跨软件操作的繁琐,提升创作效率。
局限:
功能聚焦基础场景:目前专注文本转语音核心功能,暂不支持语音交互、实时变声等高级特效。
小众语言待优化:部分冷门语言或专业术语的合成效果可能不够自然,准确性仍在持续提升中。
需依赖软件环境:仅支持在剪映或关联平台内使用,暂不提供独立应用或离线模式,跨设备灵活性受限。
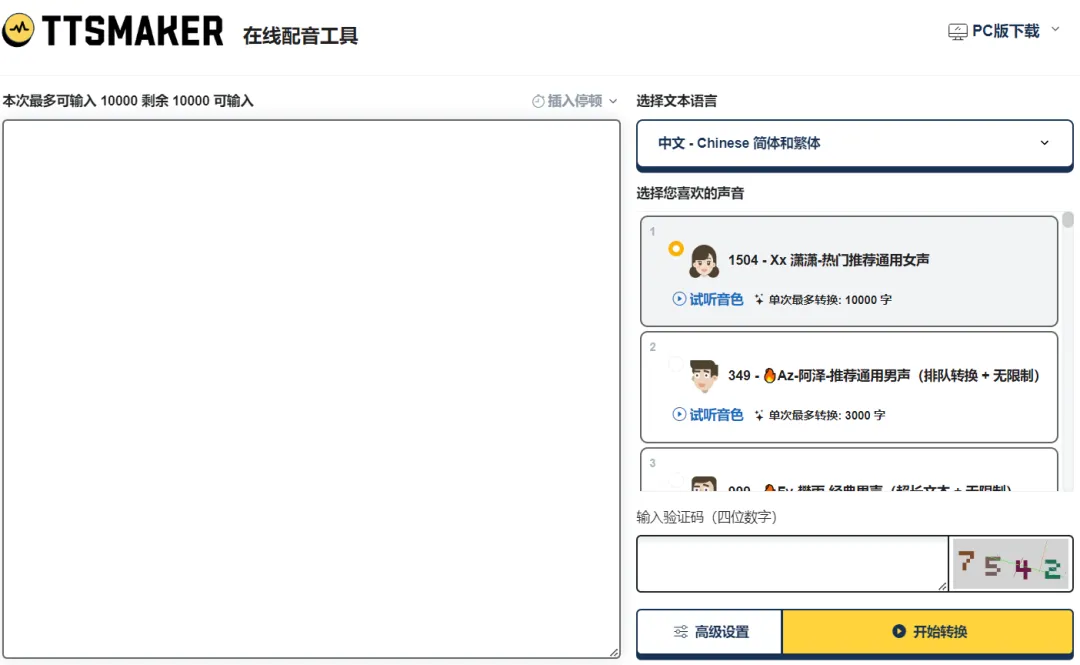
TTS Maker 是一款免费在线的文本转语音工具,提供语音合成服务,支持包括英语、法语、德语、西班牙语、阿拉伯语、中文、日语、韩语、越南语等多种语言,支持中文多种方言,如东北话、粤语、闽南话等,以及各种声音风格。
优势:
免费商用:支持个人和企业商用,合成音频版权100%归属用户,无版权风险。
多语言多风格:覆盖50+语言及方言,提供300+语音风格,包括不同性别、年龄、播音腔及情感化发音,满足多样化需求。
高效易用:三步操作(输入文本→选择语音→转换),AI模型快速处理,长文本也能高效合成。
深度定制:支持调节语速、音量、音高,自定义停顿及背景音乐,适配不同场景需求。
多格式输出:可导出MP3、WAV等主流音频格式,兼容各类使用场景。
局限:
配音师筛选不便:需手动下拉浏览,缺乏快捷检索功能,影响效率。
字数限制:单次1万字,每周上限3万字,难以满足大批量需求。
合成质量待提升:与高端付费工具相比,自然度和情感表达稍显不足,偶现机械感。
依赖网络:仅限在线使用,离线环境无法操作。
