
 语音小管家
该论文创新点如下:
在线目标说话人语音活动检测(OTS-VAD)。改进了传统的TS-VAD方法,在线特定人语音活动检测(TS-VAD),不再依赖于事先的聚类结果来获得目标说话人嵌入表示(embeddings),而是在推理阶段动态生成和更新这些表示。 多通道扩展(Multi-channel Extension)。通过引入跨通道注意力机制,有效地利用了多通道音频数据,进一步增强了在线系统在多通道数据场景下的表现。 轻量前端特征提取器。使用了轻量化的Conformer模型替代原先较为复杂的ResNet模型,显著减少了参数量,同时性能保持在较高水平。
论文题目:Online Neural Speaker Diarization with Target Speaker Tracking
作者列表:Weiqing Wang and Ming Li
论文原文:https://ieeexplore.ieee.org/document/10768974
预印版本:https://sites.duke.edu/dkusmiip/files/2024/11/main_taslp_weiqing_24.pdf
如图1展示了我们所提出的在线特定人语音活动检测系统(Online Target-Speaker Voice Activity Detection, OTS-VAD)。输入特征首先经过基于ResNet的前端提取器(包含ResNet主干网络,帧级别统计池化层,和线性输出层),获得帧级别的声纹特征序列。在训练时,我们将每个较长的音频片段切分为左右两部分,得到的特征序列分别标记为和。利用左侧片段(历史信息)对应的日志标签矩阵对中每个时刻的特征向量进行加权平均,即可提取到目标说话人的声纹嵌入。同时,从左侧片段提取到的目标说话人嵌入会用于和右侧片段(当前信息)进行结合,输入到后端模块中得到对右侧片段的日志结果预测。基于这种方法,TS-VAD模型可以学习从左侧历史信息中提取目标说话人嵌入,并用于对右侧当前输入进行预测。在推理时,OTS-TSVAD系统需要一个额外的通用语音活动检测(VAD)系统来作为辅助。首先,初始化一个空的字典用于缓存提取到的目标说话人嵌入。音频以逐块的形式输入,首先将当前已缓存的目标说话人嵌入用于预测每个说话人的语音活动信息;如果某时刻被通用VAD预测为活动区域,但又不属于已缓存的说话人活动预测,那么则该活动区域被标记为一个新加入的说话人,并将其目标嵌入缓存用于下一个块的预测。通过这种逐块迭代的形式,OTS-VAD系统可以遍历整个输入音频,以在线地形式注册每个说话人及预测对应的语音活动。
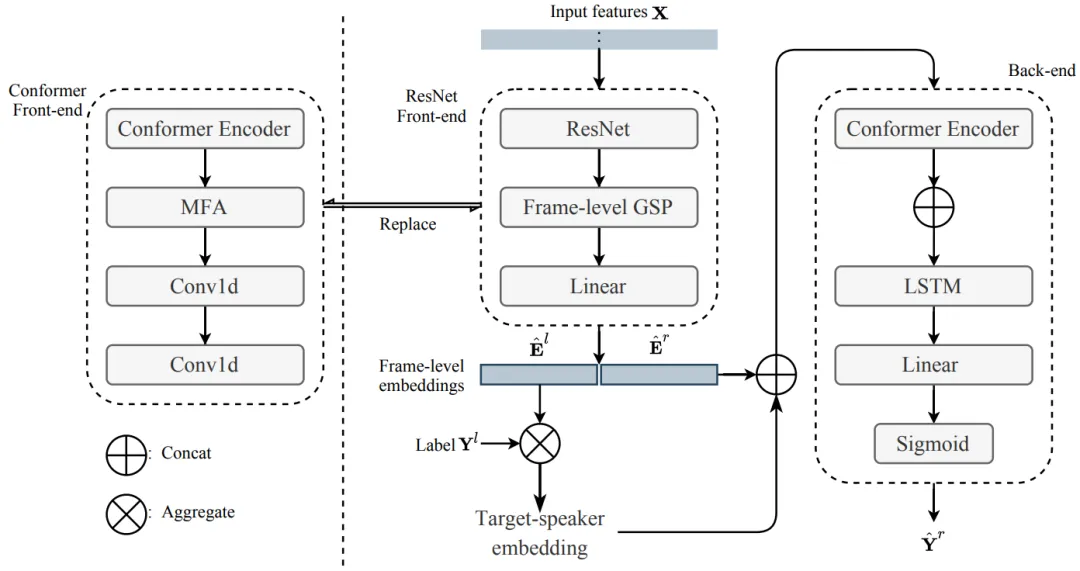
此外,如图1左侧所示,我们引入了一个参数量更少的轻量化Conformer前端来替代原有的ResNet前端,在少许的性能损失下大幅度减少了前端特征提取器所需的参数量。此外,在多通道场景下,我们也探索了利用跨通道间的自注意力机制去融合前端提取器从不同通道获取的帧级别特征序列,将OTS-VAD系统扩展到了多通道在线日志场景。具体实现细节详见原文。
表1. 展示了所提出的OTS-VAD方法在不同实验设定下的性能。可以看到,对前端特征提取器进行声纹预训练可以显著提高最终的日志性能,降低DER和JER;此外,推理时使用较大的块长(Block Length)相对可以得到更好的性能;此外,利用Conformer前端(约9.38M参数量)替换ResNet前段(约20.54M参数量),可以在稍微损失性能的情况下大幅度减少前端特征提取部分的模型大小。
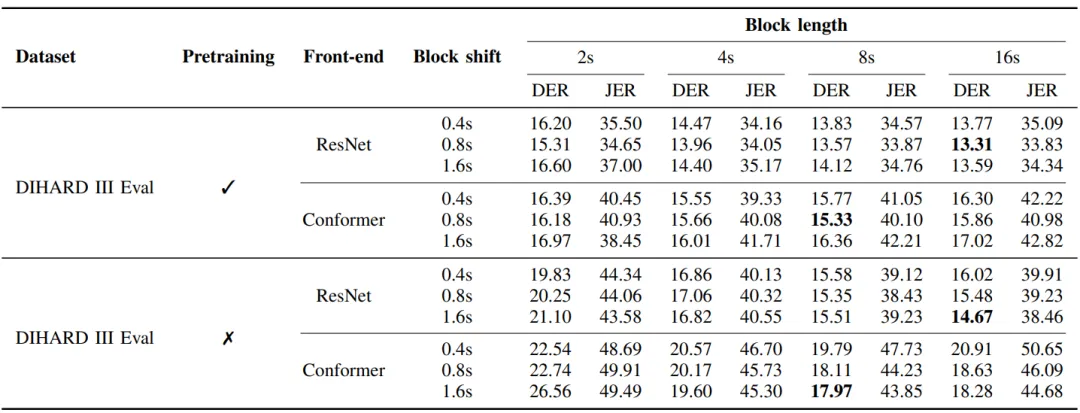
表2. 展示了所提出的OTS-VAD系统在DIHARD III数据库上和其它主流方法的对比。无论是在Oracle VAD还是System VAD条件下,该方法都获得了较为优秀的性能。
表2 – OTS-VAD方法在DIHARD III数据库上的比较
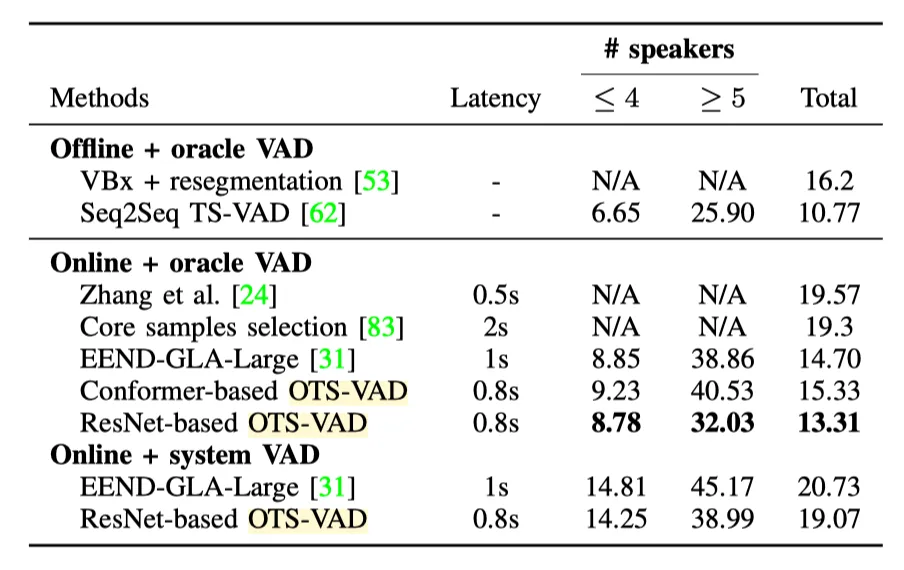
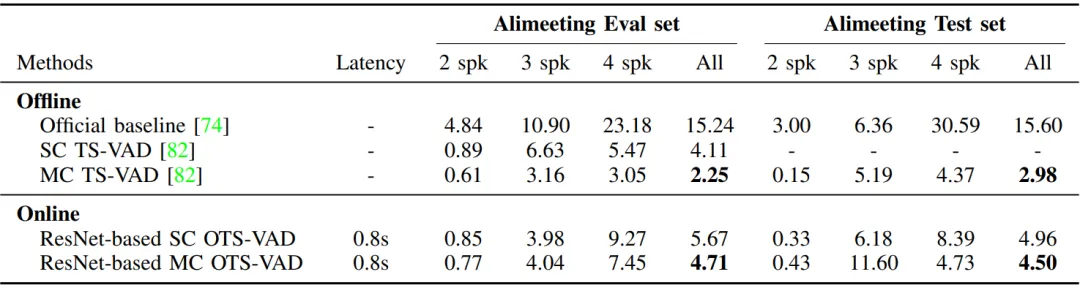
表3. 展示了OTS-VAD (单通道)和MC OTS-VAD(多通道)版在Alimeeting数据库上的性能。可以看到,本文所采用的跨通道融合方法相比单通道版本得到了明显的提升。
本文提出了一种在线目标说话人语音活动检测方法(OTS-VAD),通过实时自生成目标说话人嵌入,有效地提升了在线说话人日志任务的性能,并在DIHARD III和AliMeeting数据集上进行了实验验证。首先,我们将传统的离线TS-VAD方法扩展为在线模式,通过动态生成和更新目标说话人嵌入,避免了传统聚类方法所需的先验知识。其次,我们引入了轻量化的Conformer前端模型替代原有的ResNet网络,进一步降低了参数量和计算成本,同时保持了高效的实时性能,为实际的在线部署提供了更多可能性。最后,我们通过融合跨通道注意力机制,有效利用多通道音频信息进一步增强了OTS-VAD系统在复杂声学环境中的表现。
